Chương 10 · Hệ thống Training
Sắp xếp bộ nhớ, truyền thông giữa các thiết bị và recompute để làm training hiệu quả hơn trong các mô hình lớn.
~102 phút đọc · Thuật ngữ
Hệ thống Training
Nếu một model có thể sinh văn bản trên một thẻ tăng tốc (accelerator card) duy nhất, liệu nó có thể được huấn luyện ngay trên thẻ đó không?
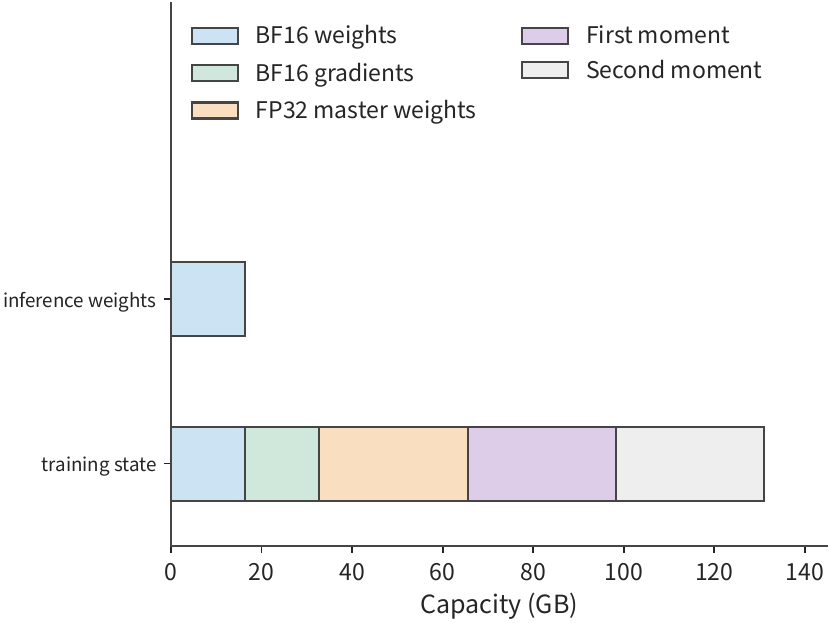
Huấn luyện toàn tham số (full-parameter training) cập nhật mọi weight có thể huấn luyện trong model. Weight BF16 của Qwen3-8B tổng cộng khoảng 16,4 GB, nhưng khi huấn luyện toàn tham số dùng Adam độ chính xác hỗn hợp (mixed-precision), hệ thống còn phải giữ thêm gradient, weight master FP32 và lịch sử gradient mà Adam tích lũy qua các bước, bên cạnh weight của model, tổng cộng khoảng 131 GB. Trạng thái training này chiếm gấp khoảng tám lần dung lượng của weight BF16.
Truyền ngược (backward pass) phải đọc các activation được giữ lại từ forward pass; các buffer dùng để thu gom tham số và chuyển đổi định dạng cũng cần được cấp phát trong lúc thực thi. Thiết kế một hệ thống training bắt đầu bằng việc xác định các tensor và buffer này nằm ở đâu, và phải được giữ lại trong bao lâu.
Chia trạng thái training cho nhiều thẻ hơn có thể giảm áp lực bộ nhớ trên mỗi thẻ, nhưng khi đó phép tính thường phải chờ dữ liệu đến từ các thẻ khác. Chuyển trạng thái sang bộ nhớ host giải phóng bộ nhớ GPU nhưng làm tăng chi phí truyền giữa host và GPU. Khi training chạy hàng tuần, việc chờ dữ liệu vào, lưu checkpoint và tính lại sau sự cố đều ảnh hưởng tới thời gian hoàn thành. Hiểu những đánh đổi này đòi hỏi nối ba câu hỏi với nhau: những tensor và buffer nào phải đồng thời chiếm bộ nhớ GPU, những thao tác nào quyết định thời điểm một bước training kết thúc, và sau sự cố quá trình huấn luyện có thể khôi phục về điểm nào.
Đồ thị tính toán của training làm rõ từng loại dữ liệu được sinh ra và tiêu thụ vào lúc nào, tạo cơ sở cho các quyết định thiết kế này. Các activation sinh ra trong forward pass được dùng trong backward pass, gradient được tổng hợp trước khi cập nhật tham số, và trạng thái optimizer được giữ lại qua các bước. Dựa trên những quan hệ đã biết này, runtime có thể nạp trước (prefetch) các tham số sắp được dùng, tính lại (recompute) các activation rẻ để tái tạo, và chồng lấp việc truyền thông các gradient đã sẵn sàng với phần tính toán backward tiếp theo. Vi phân hóa model, quản lý bộ nhớ và lập lịch accelerator cùng nhau quyết định một bước training thực thi như thế nào.
Chương này xoay quanh một nhiệm vụ: dùng Qwen3-8B xử lý 100B token để tiếp tục huấn luyện theo miền (domain-specific continued training), với hạn chót 30 ngày. Trước tiên chúng ta ước lượng tài nguyên tối thiểu cần thiết, rồi so sánh hai sơ đồ — một sơ đồ dựng từ 32 thẻ RTX 4090, sơ đồ kia từ 48 thẻ. Sự so sánh bắt đầu từ yêu cầu bộ nhớ, sau đó lần lượt cộng thêm thời gian dành cho tính toán, truyền thông, chuẩn bị dữ liệu và phục hồi sự cố, cuối cùng xác định sơ đồ nào có thể hoàn thành đúng hạn. Để làm rõ các cơ chế liên quan, văn bản xen kẽ các ví dụ tensor và pipeline nhỏ hơn. Phần RL phân tích sâu hơn cách generation (sinh), verification (xác minh) và learning (học) kết hợp thành một vòng phản hồi.
Các con số dung lượng trong chương này dùng hai bộ đơn vị: GB và TB biểu thị dung lượng thập phân, còn GiB và MiB biểu thị dung lượng nhị phân.
10.1 Ước lượng dung lượng và thời gian từ nhiệm vụ training
10.1.1 Nhiệm vụ training, tham số có thể huấn luyện và mục tiêu hoàn thành
Thiết kế hệ thống bắt đầu từ công việc cần hoàn thành. Nhiệm vụ trong chương này dùng huấn luyện toàn tham số, Adam độ chính xác hỗn hợp và chuỗi 8.192 token, xử lý 100B token hiệu dụng. Mỗi vòng lặp training (iteration) xử lý 384 chuỗi đủ độ dài, tức 3.145.728 token hiệu dụng; vòng lặp cuối xử lý phần dữ liệu còn lại, ngân sách thời gian vẫn được phân bổ như cho một bước đầy đủ. Khi so sánh hai sơ đồ hệ thống, chúng ta dùng cùng dữ liệu training, cùng hàm mục tiêu và cùng yêu cầu đánh giá.
Token hiệu dụng là token mà nhiệm vụ thực sự cần, không tính các token padding được chèn vào để làm đều độ dài. Padding làm cho hình dạng tensor đều đặn hơn nhưng cũng tiêu tốn tài nguyên tính toán và lưu trữ. Khi hạch toán việc hoàn thành nhiệm vụ, chỉ đếm token hiệu dụng. Ngược lại với huấn luyện toàn tham số, LoRA thêm các ma trận có thể huấn luyện nhỏ hơn bên cạnh weight gốc, tích của chúng biểu thị mức điều chỉnh weight. LoRA giảm số tham số cần huấn luyện: weight gốc vẫn được dùng trong forward pass, còn kích thước của gradient và trạng thái optimizer chủ yếu phụ thuộc vào số tham số adapter.
Về thời gian, một vòng lặp training bao gồm forward pass, backward pass, giảm gradient (gradient reduction) và cập nhật tham số. Tiếp tục huấn luyện gồm nhiều vòng lặp như vậy, xen kẽ với chuẩn bị dữ liệu vào và lưu checkpoint. Khởi động, chuẩn bị tài nguyên và bảo trì cũng được tính vào tổng thời gian từ lúc bắt đầu đến lúc kết thúc. Tình huống thiết kế trong chương này dành 5 trong 30 ngày cho khởi động, đánh giá và tạm dừng theo kế hoạch, để lại 25 ngày cho training, lưu checkpoint và phục hồi sự cố. Do đó thông lượng hiệu dụng trung bình yêu cầu tăng từ khoảng 38.600 token/s lên khoảng 46.300 token/s.
Hoàn thành toàn bộ nhiệm vụ cần vòng lặp training. Trải đều trong 25 ngày, mỗi vòng lặp chỉ được khoảng 67,9 s. Đây là ngân sách thời gian xuyên suốt cả chương: tính toán mỗi bước, thời gian chờ truyền thông, thời gian chờ dữ liệu vào, cùng phần lưu checkpoint và phục hồi sự cố phân bổ cho bước này — tất cả phải nằm gọn trong 67,9 s này.
Kích thước batch mỗi bước cũng cần được xác định. Global batch được cố định ở 384 chuỗi thay vì tăng tiếp, vì những lý do bắt nguồn từ tỷ số tín hiệu trên nhiễu của gradient. Khi batch size tăng, nhiễu trong ước lượng gradient giảm; một khi đủ lớn, thêm mẫu chỉ làm giảm nhẹ số bước cần thiết để đạt cùng loss, trong khi tính toán mỗi bước tăng theo tỷ lệ. Kích thước batch tại điểm chuyển đổi này được gọi là critical batch size (batch size tới hạn), có thể ước lượng bằng gradient noise scale (thang nhiễu gradient). Gọi là Hessian (ma trận đạo hàm bậc hai) của loss theo các tham số, là hiệp phương sai của gradient từng mẫu (per-sample gradient), và là gradient thực. Thang nhiễu gradient được định nghĩa là
Số bước cần để đạt một loss cho trước và số mẫu đã xử lý thỏa mãn quan hệ thực nghiệm
trong đó là số bước tối thiểu cần để đạt loss đó, và là số mẫu tối thiểu cần dùng. Critical batch size xấp xỉ bằng gradient noise scale; khi huấn luyện ở critical batch size, cả số bước lẫn số mẫu đều gấp đôi mức tối thiểu tương ứng.
thay đổi theo model và giai đoạn training. Ở đây ta lấy hai triệu token: tài liệu đã đo trên các model lớn nhất được huấn luyện và nhận thấy giá trị này hội tụ về khoảng một đến hai triệu token. Coi lần chạy chuẩn trong chương này — 48 thẻ, token mỗi bước, 31.790 bước để hoàn thành 100B token — là chạm chính xác mục tiêu, ta đảo ngược quan hệ trên để có bước và B token. Batch size mỗi bước hiện tại lớn gấp khoảng 1,57 lần , đã vượt qua khoảng mà việc nhân đôi batch size làm giảm gần một nửa số bước; tiếp tục tăng batch size có thể giảm số bước từ 31.790 xuống nhiều nhất là 19.434. Bảng dưới so sánh thời gian hoàn thành theo weak scaling (giãn yếu) và strong scaling (giãn mạnh) khi số thẻ tăng lên.
| Thẻ | Weak scaling: token mỗi bước | Thời gian hoàn thành weak scaling / ngày | Thời gian hoàn thành strong scaling / ngày |
|---|---|---|---|
| 48 (chuẩn) | 3,145,728 | 19.4 | 19.4 |
| 96 | 6,291,456 | 15.7 | 9.8 |
| 192 | 12,582,912 | 13.8 | 5.0 |
| 384 | 25,165,824 | 12.8 | 2.6 |
| 1536 | 100,663,296 | 12.1 | 0.8 |
Trong bảng này, weak scaling giữ mỗi thẻ tích lũy cố định 8 micro-batch, nên mỗi bước vẫn mất 52,8 s trong khi global batch tăng theo số thẻ; strong scaling giữ global batch cố định, nên tính toán của mỗi thẻ tỷ lệ nghịch với số thẻ, và 0,58 s truyền thông cũng như chờ dữ liệu vào mỗi bước không đổi. Cả hai đều không tính đến sự thay đổi hiệu quả song song hóa. Trần tăng tốc của weak scaling là lần: lên 1536 thẻ đưa batch size mỗi bước lên gấp 32 lần giá trị chuẩn, nhưng thời gian hoàn thành chỉ giảm từ 19,4 ngày xuống 12,1 ngày. Strong scaling không bị giới hạn bởi , nhưng tỷ trọng thời gian chờ cố định trong mỗi bước tăng theo số thẻ — ở mức 0,8 ngày, truyền thông và chờ dữ liệu vào đã chiếm khoảng một phần tư trong đó.
Việc lợi ích của weak scaling đảo chiều khi nào phụ thuộc vào giá trị : nếu thang nhiễu là hai mươi triệu token, trần của weak scaling sẽ tăng lên khoảng 7,36 lần, và tăng batch size cùng với số thẻ khi đó mang lại lợi ích rõ ràng. Vì vậy, batch size có thể tăng theo số thẻ hay không đòi hỏi trước tiên phải ước lượng : khi batch size hiện tại thấp hơn nhiều giá trị này, batch size có thể tăng theo số thẻ; khi cao hơn nhiều, thêm thẻ chỉ có thể rút ngắn thời gian mỗi bước qua strong scaling. Việc chọn 384 chuỗi đi theo đúng logic này: con số này nằm vừa trong ngân sách bộ nhớ và thời gian mỗi bước của 48 thẻ, và đã nằm hơi trên mức thang nhiễu, nên lợi ích của việc mở rộng batch size thêm bắt đầu giảm dần.
10.1.2 Tham số, gradient, trạng thái optimizer và activation
67,9 s cho biết thời gian cho phép mỗi bước, nhưng trước khi tính toán có thể bắt đầu, các yêu cầu bộ nhớ phải được thỏa mãn. Gọi là số lượng tham số. Trong một vòng lặp, forward pass tính toán dự đoán và loss từ dữ liệu vào; backward pass đi theo các phụ thuộc tính toán để suy ra gradient của loss theo từng giá trị trung gian và tham số, đọc các activation mà forward pass để lại; optimizer sau đó dùng gradient của tham số để tính weight cho bước tiếp theo.
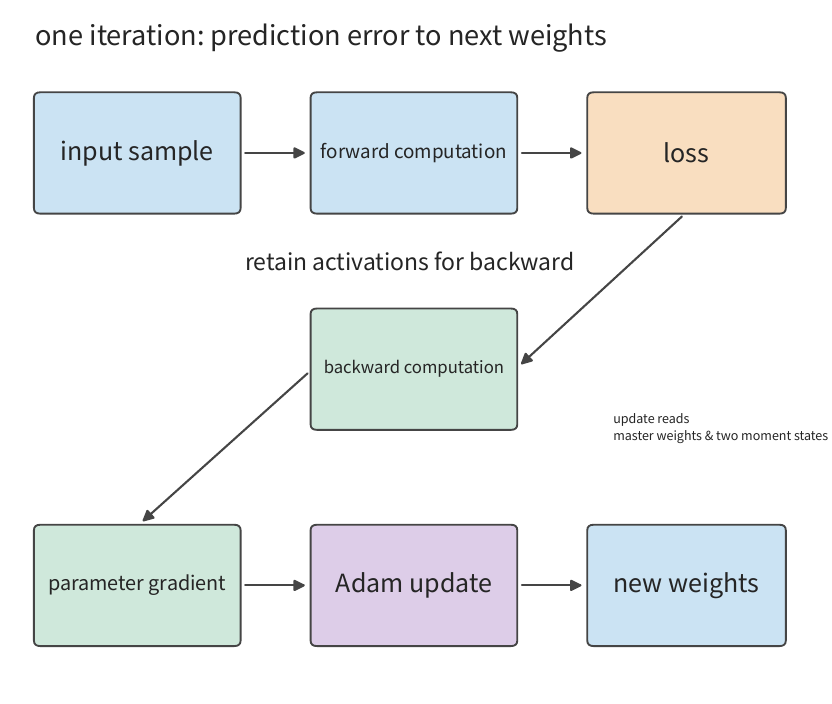
Cụ thể với nhiệm vụ trong chương này, Adam độ chính xác hỗn hợp thực hiện phép toán ma trận bằng weight BF16, giữ weight master FP32 để chứa giá trị tham số sau khi optimizer cập nhật, và giữ hai trạng thái moment FP32. Moment thứ nhất và thứ hai được giữ lại qua các vòng lặp, ghi lại lịch sử hướng và độ lớn của gradient; sau khi weight master được cập nhật, chúng được chuyển đổi ngược lại thành BF16 cho các phép toán ma trận. Gradient được tích lũy ở định dạng BF16. Cộng theo từng hạng tử cho ra 16 byte mỗi tham số.
| Trạng thái | Byte mỗi tham số | Dung lượng của Qwen3-8B / GB | Dùng khi nào |
|---|---|---|---|
| Weight model BF16 | 2 | 16.4 | Phép toán ma trận forward và backward |
| Gradient BF16 | 2 | 16.4 | Sinh ra trong quá trình lan truyền ngược, dùng khi tính tham số mới |
| Weight master FP32 | 4 | 32.8 | Lưu tham số mới, sau đó tạo bản sao BF16 |
| Moment thứ nhất của Adam | 4 | 32.8 | Giữ lịch sử gradient qua các vòng lặp training |
| Moment thứ hai của Adam | 4 | 32.8 | Giữ lịch sử gradient bình phương qua các vòng lặp training |
| Tổng | 16 | 131.1 | Trạng thái training thường trực |
Qwen3-8B có tham số, nên
Định dạng gradient là một lựa chọn khác. Chuyển gradient sang FP32 thêm 2 byte mỗi tham số, nâng tổng lên 18 byte. Sự thay đổi này đến từ định dạng dữ liệu của gradient; bản thân thuật ngữ “mixed precision” không quy định định dạng gradient. MoE chọn một tập con các mạng con chuyên gia (expert subnetwork) qua một router trong mỗi lượt; mỗi expert cũng có tham số và lịch sử optimizer cần cập nhật, nên dung lượng trạng thái được xác định bởi tổng số tham số có thể huấn luyện.
Ngoài dung lượng mỗi loại dữ liệu chiếm bao nhiêu, ta cũng phải phân biệt mỗi loại phải được giữ lại trong bao lâu. Các activation sinh ra trong forward pass không thể giải phóng cho đến khi phần tính toán backward tương ứng hoàn tất, còn các buffer thu gom tham số có thể chỉ cần trong lúc thực thi một module cụ thể. Bộ nhớ đỉnh trên thẻ phụ thuộc vào trạng thái training, activation và buffer tạm cư trú tại cùng một thời điểm:
Chẳng hạn, nếu 8 GiB activation và 4 GiB buffer thu gom xuất hiện cùng lúc, chúng cùng chiếm 12 GiB; nhưng nếu activation được giải phóng trước khi thu gom tham số, chính không gian ấy có thể được tái sử dụng. Tối ưu dung lượng vì thế có hai hướng: thu nhỏ bản thân các tensor và buffer, hoặc giảm lượng dữ liệu phải được giữ đồng thời. Các kỹ thuật sharding, recomputation và offloading trình bày ở mục tiếp theo thay đổi bộ nhớ đỉnh lần lượt theo hai hướng này.
Các con số dung lượng trên giả định phép toán ma trận thực thi ở BF16. Chuyển sang một định dạng dấu phẩy động khác sẽ thay đổi cả số byte của trạng thái lẫn rủi ro số học. Trước tiên xét FP16. Mục 4.6.1 đã so sánh số mũ và phần định trị của FP16 và BF16: số mũ năm bit của FP16 đặt số chuẩn nhỏ nhất ở ; các giá trị nhỏ hơn mức này chỉ có thể được biểu diễn ở dạng subnormal, mất dần bit quan trọng khi độ lớn thu nhỏ; các giá trị dưới trở thành chính xác bằng không. Bài báo về training độ chính xác hỗn hợp đưa ra hai bộ thống kê: trong weight gradient của một model nhận dạng giọng nói tiếng Quan thoại, khoảng 5% giá trị có số mũ dưới và sẽ trở thành không trong FP16, mà bài báo dùng để lập luận cho weight master FP32; trong activation gradient của mạng phát hiện Multibox SSD, một lượng lớn giá trị nằm dưới phạm vi biểu diễn được của FP16 và trở thành không, và trong số đó, các giá trị thuộc vẫn quan trọng cho training.
Loss scaling (thang loss) giải quyết vấn đề này: trước khi lan truyền ngược, loss được nhân với một thừa số , nâng gradient lên gấp lần vào phạm vi biểu diễn được của FP16; trước khi cập nhật tham số, chúng lại được chia cho . Trong các mạng khác nhau được huấn luyện ở bài báo đó, các thừa số scaling được dùng nằm trong khoảng 8 đến 32K. Thừa số quá nhỏ vẫn để gradient nhỏ tràn dưới (underflow); thừa số quá lớn khiến gradient lớn tràn trên (overflow) thành vô cùng, đòi hỏi phải bỏ qua lần cập nhật đó và giảm thừa số.
Số mũ tám bit của BF16 khớp với FP32, nên hai định dạng chia sẻ cùng phạm vi biểu diễn và gradient không cần scaling — đây là một lý do bảng trạng thái trên dùng BF16. Cái giá phải trả là phần định trị chỉ có bảy bit: sai số làm tròn trên dữ liệu vào của phép toán ma trận lớn hơn trong FP16, và độ chính xác của các tích nội dài phải được đảm bảo bằng một bộ cộng FP32.
Hạ thấp độ rộng bit hơn nữa vẫn đòi hỏi tinh chỉnh thừa số scaling toàn cục duy nhất thành scaling theo khối (block-wise scaling). Mã hóa E4M3 của FP8 chỉ có bốn bit số mũ và ba bit phần định trị, với giá trị chuẩn lớn nhất là 448; một thừa số toàn cục không thể đưa các activation của từng layer vào một phạm vi hẹp như vậy cùng lúc. Huấn luyện FP8 của DeepSeek-V3 quản lý scaling theo khối: activation tính một scale cho mỗi khối (mỗi token, mỗi 128 kênh), weight tính một scale cho mỗi khối , và đơn vị ma trận chuyển các tổng riêng phần sang FP32 để tiếp tục tích lũy sau mỗi 128 phần tử được tích lũy. So với lần chạy kiểm chứng BF16, sai số loss tương đối vẫn dưới 0,25%.
FP8 cũng thay đổi cách hạch toán dung lượng, nhưng chỉ với bản sao weight được đưa vào đơn vị ma trận: huấn luyện FP8 của DeepSeek-V3 chuyển đổi toán hạng của phép toán ma trận sang FP8, còn weight master, gradient và trạng thái optimizer vẫn được giữ ở độ chính xác cao hơn. Bản sao toán hạng FP8 này tốn 1 byte mỗi tham số, cộng một scale FP32 cho mỗi khối , tổng cộng khoảng byte mỗi tham số; với Qwen3-8B, weight đọc cho phép toán ma trận giảm từ 16,4 GB của BF16 xuống khoảng 8,2 GB, trong khi trạng thái training thường trực 16 byte mỗi tham số ở bảng trước đó không giảm tương ứng xuống 1 byte.
| Định dạng weight cho phép toán ma trận | Byte mỗi tham số (gồm scale) | Weight đọc cho phép toán ma trận của Qwen3-8B | Quản lý scale | Rủi ro số học chính |
|---|---|---|---|---|
| FP16 | 2 | 16.4 GB | Loss scaling toàn cục | Gradient tràn dưới, scaling tràn trên |
| BF16 | 2 | 16.4 GB | Không cần | Phần định trị ngắn hơn, bù lại bằng tích lũy FP32 |
| Bản sao toán hạng FP8 (E4M3) | ~1.0002 | ~8.2 GB (weight master và trạng thái optimizer lưu riêng) | Scaling theo khối kèm tích lũy độ chính xác cao định kỳ | Làm tròn trong khối, scale quá hạn |
Độ chính xác càng thấp và hạt scaling càng thô thì dung lượng tiết kiệm được càng nhiều, nhưng rủi ro lệch khỏi chuẩn độ chính xác cao càng lớn. Dù nguyên nhân là gì — scaling hỏng, dữ liệu bất thường hay lỗi phần cứng — sự phân kỳ của training hiện ra dưới dạng một gai trên đường cong loss, thường được xử lý bằng cách quay lui về checkpoint trước đó và huấn luyện lại. Việc quay lui làm mất bao nhiêu tiến độ được xác định bởi mô hình chu kỳ lưu trong Mục 10.4, và Mục 10.4.5 kết hợp thêm tỷ lệ quay lui vào mô hình đó.
10.1.3 Yêu cầu tính toán, MFU và cận dưới tài nguyên
Bộ nhớ quyết định một model có thể bắt đầu training hay không; tốc độ tính toán quyết định nó có thể hoàn thành đúng hạn hay không. Trạng thái của một model có thể được chia cho nhiều thẻ, nhưng số thẻ thực sự cần thiết phải được đánh giá từ tổng lượng tính toán và hạn chót. Một chuỗi 8.192 token cần khoảng FLOPs tính toán ma trận cho cả forward lẫn backward pass, trung bình khoảng 52,7 GFLOPs mỗi token. Xử lý 100B token vì vậy cần khoảng FLOPs tổng cộng. Con số khối lượng công việc này được tích lũy từ các hình dạng ma trận của model và các thao tác forward/backward.
Giả sử trước tiên cả 30 ngày đều dành cho tính toán training. Thông lượng đỉnh ma trận BF16 đặc (dense) của H100 SXM là 989 TFLOP/s; ở 40% đỉnh, một thẻ xử lý khoảng 7.500 token/s. Năm thẻ cùng nhau cho khoảng 37.600 token/s, thấp hơn mức khoảng 38.600 token/s cần cho 30 ngày; ít nhất sáu thẻ là cần thiết để đáp ứng yêu cầu tính toán. Để so sánh, hai thẻ 80 GB đã có thể chứa 131,1 GB trạng thái training thường trực trong điều kiện chia đều lý tưởng, nhưng sẽ cần khoảng 77 ngày để hoàn thành phần tính toán.
Gọi là tổng lượng tính toán mà thuật toán yêu cầu, là số thẻ, là thông lượng đỉnh mỗi thẻ, và là hiệu quả tính toán trung bình trong khoảng đo. Khi đó
Chương này tính MFU theo định nghĩa trong Mục 1.2.2, với mẫu số lấy là thông lượng đỉnh của tất cả các thẻ. Nếu thời gian đo được lấy là thời gian trọn vẹn một vòng lặp training, thời gian chờ truyền thông đã được tính trong đó; nếu chỉ tính thời gian accelerator dành cho việc thực thi tính toán, kết quả là hiệu quả tính toán của từng thẻ. Tình huống thiết kế trong chương này áp dụng cách phân rã sau: hiệu quả tính toán của từng thẻ lấy là 40%, sau đó cộng thêm lần lượt từng khoản thời gian truyền thông không thể chồng lấp với tính toán trong thẻ, cùng thời gian chờ dữ liệu vào. Nhờ đó có thể quan sát trực tiếp tác động của từng lựa chọn thiết kế hệ thống lên thời gian hoàn thành. Con số 40% đến từ bản ghi công khai của Llama 3: model 405B được pretrain trên 8.192 đến 16.384 H100 với MFU BF16 từ 38%–43%. Con số đó được tính trên toàn bộ thời gian bước và vì thế đã bao gồm chờ truyền thông; chương này cộng thêm truyền thông riêng lên trên, nên thời gian hoàn thành tính ra ở đây dài hơn một chút. RTX 4090 không có NVLink, nên mọi dữ liệu giữa các thẻ đều đi qua PCIe; chi phí này được tính riêng trong Mục 10.3.3 dựa trên liên kết thực tế. Hình 10-3 đến Hình 10-5 cũng thể hiện các mốc 30% và 50%, để quan sát số thẻ thay đổi thế nào khi hiệu quả lệch đi.
Phần sáu mươi phần trăm còn lại của thông lượng đỉnh đi vào đâu được trả lời từng mục trong chương này: truyền thông không thể chồng lấp với tính toán (Mục 10.3.3), bubble pipeline (khoảng trống pipeline, Mục 10.3.2), cập nhật tham số và chuyển đổi trạng thái bị giới hạn bởi băng thông bộ nhớ (Mục 10.2.3), recomputation (Mục 10.2.2), straggler (thẻ chậm, Mục 10.4.5), và lưu checkpoint (Mục 10.4.3). Theo tiêu chí trong Mục 1.3.4, bốn khoản đầu là công việc mà model phải hạch toán — bỏ sót bất kỳ khoản nào sẽ làm thời gian hoàn thành ước lượng quá ngắn — còn hai khoản cuối, cùng với phần truyền thông không chồng lấp được, chứa phần chi phí có thể giảm bớt; đó chính là chỗ cho việc tối ưu thiết kế hệ thống.
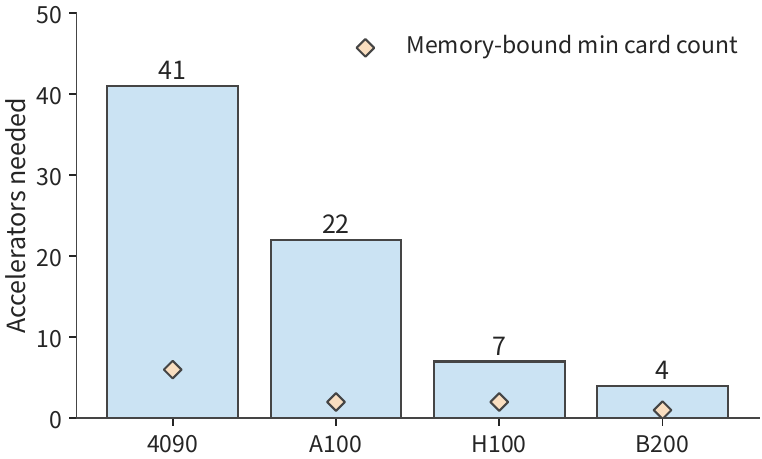
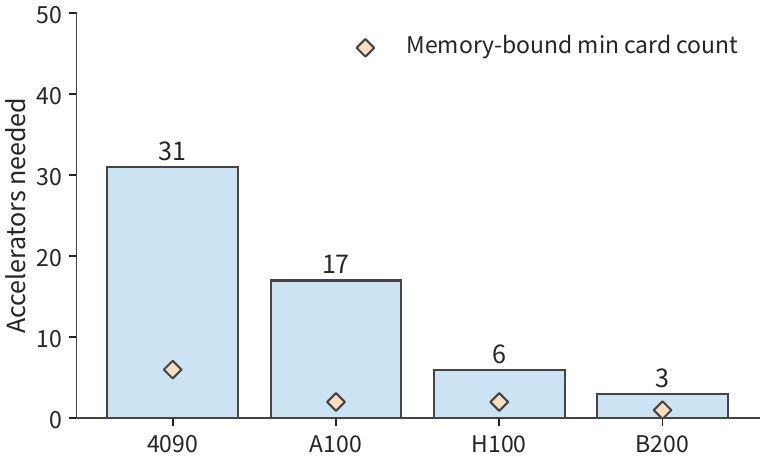
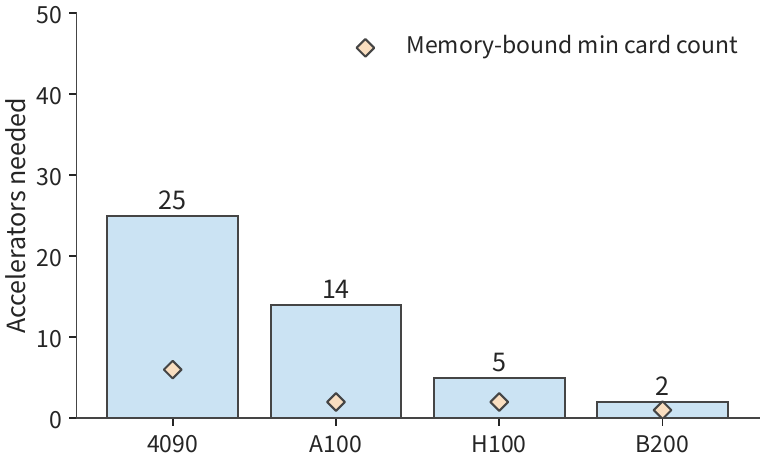
Hình 10-3 đặt cận dưới bộ nhớ và cận dưới tính toán cạnh nhau: với nhiệm vụ trong chương này, số thẻ cần thiết chủ yếu do tính toán quyết định. Dựa trên đó, giờ đây ta chọn hai cấu hình cụ thể để so sánh từng bước trong các mục sau. Đỉnh tương ứng của RTX 4090 là 165,2 TFLOP/s. Ở hiệu quả 40% và hạn 30 ngày, cần ít nhất 31 thẻ. Áp dụng cấu hình tám thẻ mỗi host, trước tiên có thể xét sơ đồ 32 thẻ; thêm hai host nữa cho 48 thẻ. Trong cả hai sơ đồ, mỗi thẻ tích lũy lần lượt 12 và 8 micro-batch một chuỗi, cùng nhau hoàn thành một global batch 384 chuỗi. Thêm thẻ làm thay đổi phân bổ công việc, trong khi mục tiêu training vẫn giữ nguyên.
Mỗi vòng lặp training cần khoảng FLOPs. Với 32 thẻ, mỗi thẻ mất khoảng 78,3 s để hoàn thành phần tính toán được giao; với 48 thẻ, khoảng 52,2 s. So với ngân sách 67,9 s, sơ đồ 32 thẻ đã vượt ngân sách trước khi cộng truyền thông, còn sơ đồ 48 thẻ để lại khoảng 15,7 s dư. Bước tiếp theo là xác định hai sơ đồ sắp xếp trạng thái của chúng như thế nào, và loại chờ nào sẽ tiêu thụ 15,7 s đó.
10.2 Sharding, recomputation và offloading trạng thái training
10.2.1 Data parallelism (song song dữ liệu) và ZeRO/FSDP sharding trạng thái
Cách trạng thái được phân phối trên nhiều thẻ được quyết định bởi chiến lược song song hóa. Data parallelism đồng bộ cho mỗi thẻ xử lý các mẫu khác nhau, rồi cập nhật tham số của chính mỗi thẻ bằng gradient đã được giảm. Vì mọi thẻ cuối cùng đều có cùng tham số mới, mỗi thẻ thường giữ một bản sao giống hệt nhau của weight và trạng thái optimizer; càng nhiều thẻ, trạng thái trùng lặp càng nhiều. ZeRO được các nhà nghiên cứu Microsoft đề xuất năm 2019 và công bố năm 2020; nó dùng sharding xuyên thẻ để giảm các bản sao trạng thái trùng lặp được giữ trong quá trình huấn luyện model lớn. ZeRO phân chia quyền sở hữu trạng thái này theo từng giai đoạn: mỗi thẻ chỉ chịu trách nhiệm cập nhật một phần tham số, và thông qua truyền thông lấy về bất kỳ dữ liệu nào khác mà nó cần để thực thi.
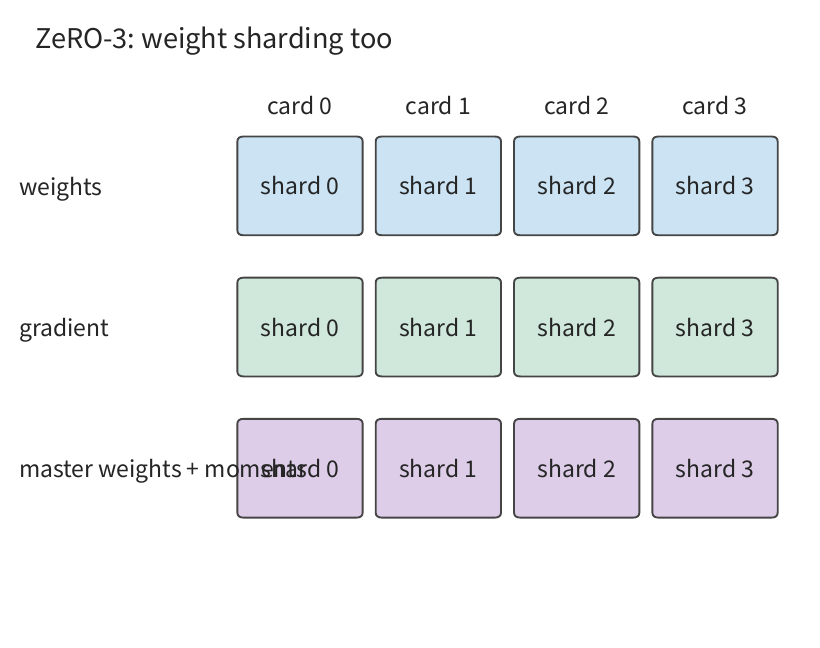
Fully Sharded Data Parallel (FSDP) tổ chức thực thi quanh chính ý tưởng sharding đó, với tham số, gradient và trạng thái optimizer đều được shard. Dưới đây, ta dùng bốn thẻ để thay đổi dần quyền sở hữu trạng thái, rồi phân tích kiểu thực thi tạo thành. Trong mỗi hình, mỗi cột luôn tương ứng với cùng một thẻ; “full” nghĩa là thẻ đó giữ toàn bộ trạng thái, “shard” nghĩa là nó chỉ giữ phần tư mà nó chịu trách nhiệm.
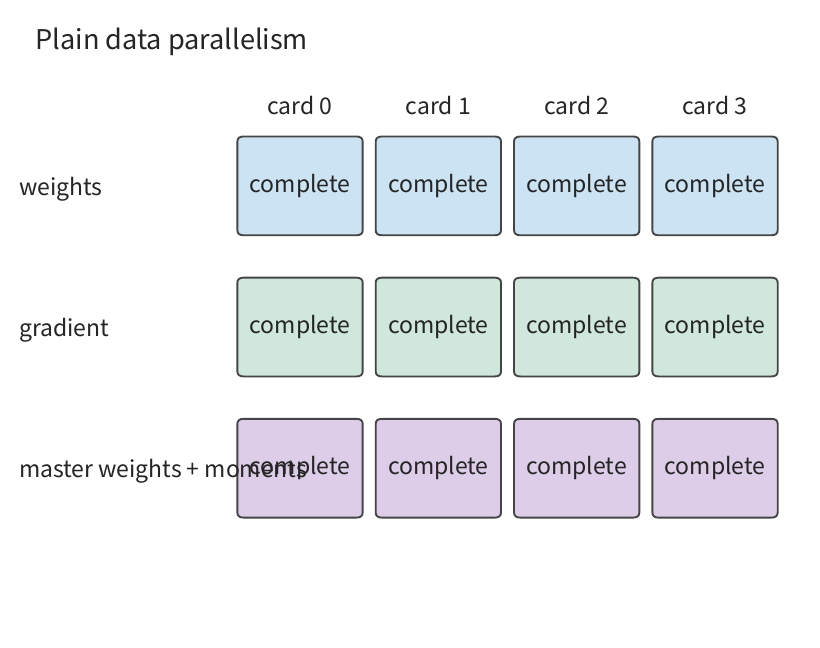
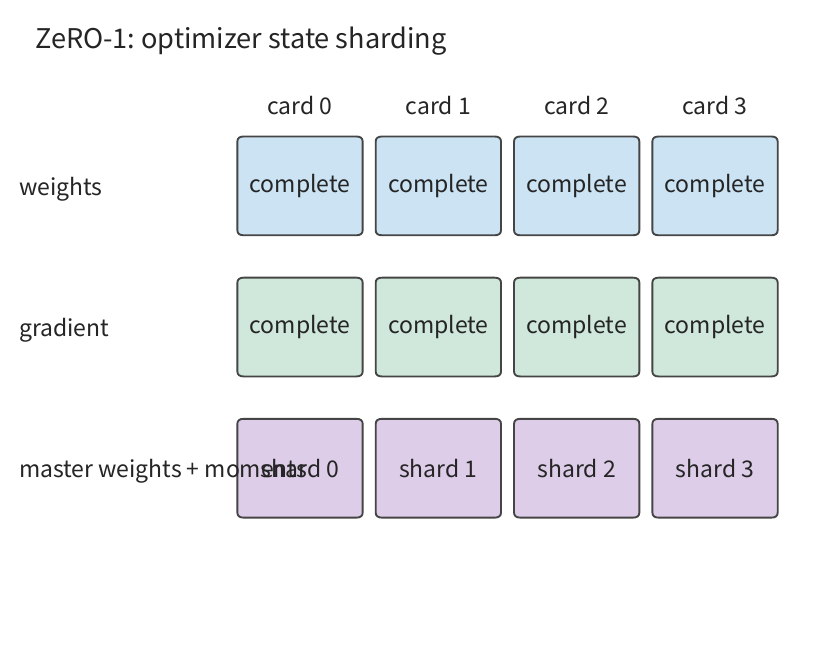
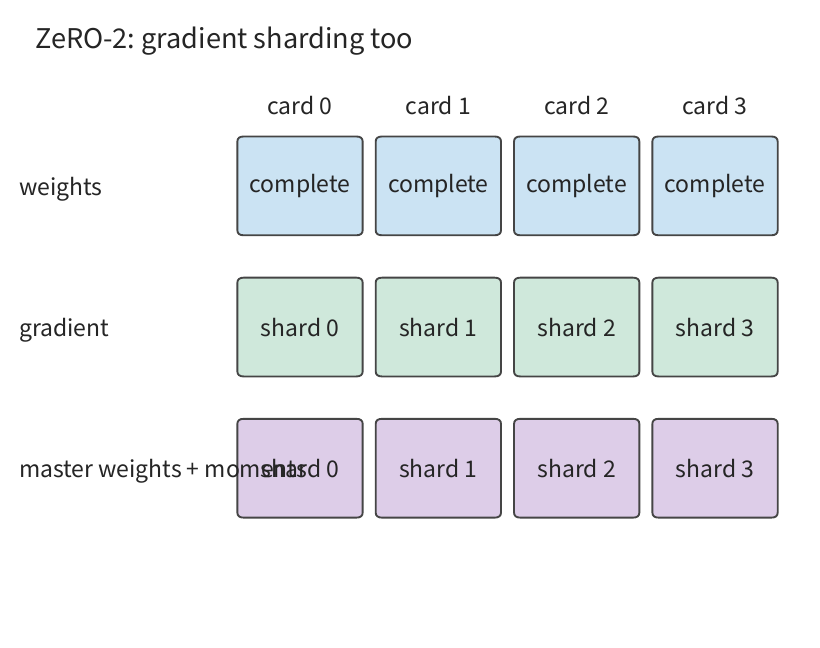
Hai giai đoạn đầu vẫn giữ một bản sao đầy đủ weight model trên mỗi thẻ. Hình 10-9 cũng phân chia quyền sở hữu weight, giảm tiếp không gian cư trú lâu dài, với cái giá phải truyền thông để lấy về các weight cần thiết trước khi thực thi mỗi module.
Gọi là số thẻ trong nhóm data-parallel. Tính trạng thái training thường trực trước, dung lượng mỗi thẻ của data parallelism thuần túy và ba giai đoạn ZeRO là
Giai đoạn thứ nhất shard weight master FP32 và hai trạng thái Adam, tổng 12 byte/tham số, trong khi weight và gradient vẫn mỗi loại được giữ một bản sao đầy đủ. Giai đoạn thứ hai shard tiếp gradient, chỉ để lại weight BF16 được nhân bản đầy đủ. Giai đoạn thứ ba shard cả weight. Thay cho ra các thay đổi dung lượng dưới đây.
| Cấu hình | Trạng thái training thường trực mỗi thẻ / GiB | Trạng thái training nhân bản đầy đủ |
|---|---|---|
| DP thuần túy | 122.1 | Weight, gradient và trạng thái optimizer |
| ZeRO-1 | 42.0 | Weight và gradient |
| ZeRO-2 | 28.6 | Weight |
| ZeRO-3 | 15.3 | Mọi trạng thái training thường trực đều được shard |
Một khi đã shard, mỗi module thực thi theo thứ tự sau: trước tiên thu gom các tham số cần thiết qua AllGather, thực hiện forward hoặc backward pass, rồi tổng hợp gradient qua ReduceScatter và phân phối các mảnh gradient sao cho thẻ sở hữu mỗi mảnh nhận được đầy đủ đóng góp gradient của nó, và cuối cùng mỗi thẻ cập nhật các tham số mà nó sở hữu. Thực thi fully sharded của FSDP cũng được tổ chức quanh đường đi này. Nếu toàn bộ tham số được giải phóng sau forward pass, chúng phải được thu gom lại trước backward pass; nếu được giữ lại, backward pass có thể dùng trực tiếp, nhưng toàn bộ tham số khi đó chiếm bộ nhớ cùng lúc với các activation tiếp theo.
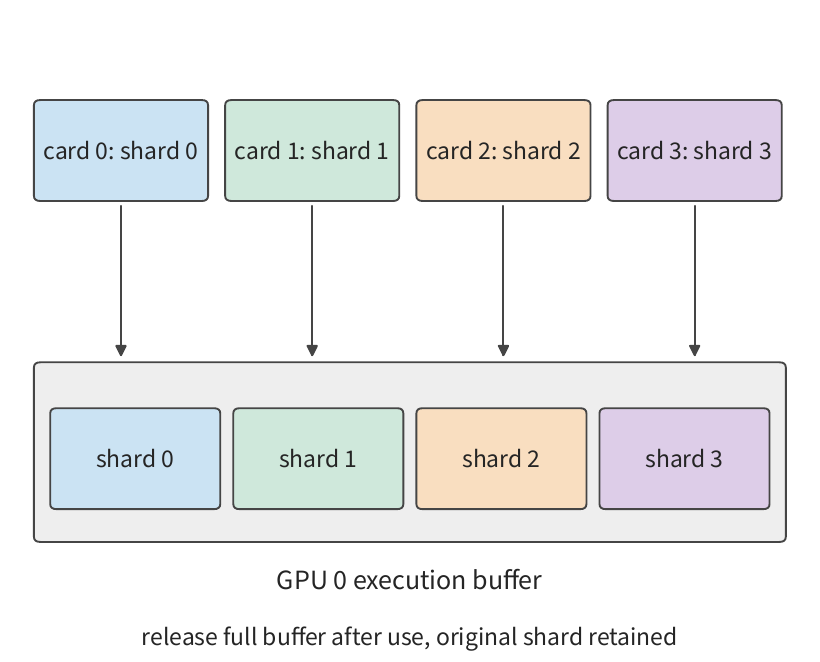
Trong Hình 10-10, buffer weight đầy đủ tồn tại cùng lúc với các mảnh gốc. Tăng số thẻ làm thu nhỏ mỗi mảnh gốc, nhưng kích thước của buffer weight đầy đủ được quyết định bởi chính module. Đây là lý do mức giảm của trạng thái thường trực và mức giảm của bộ nhớ đỉnh khi thực thi khác nhau về độ lớn.
Sự khác biệt này có thể quan sát trực tiếp trong một thí nghiệm nhỏ. Trong một bộ thí nghiệm dùng bản triển khai FSDP thế hệ thứ hai của PyTorch (FSDP2) trên một model CPU nhỏ, tăng số tiến trình tham gia từ hai lên bốn làm giảm trạng thái giữ lại sau khi cập nhật tham số từ khoảng 18 MiB xuống 9 MiB, trong khi bộ nhớ đỉnh khi thực thi chỉ giảm từ khoảng 39 MiB xuống 30 MiB. Phần giữ lâu dài giảm một nửa, nhưng đỉnh chỉ giảm khoảng 23%, vì khoảng 21 MiB tensor và buffer khác vẫn cần trong lúc thực thi. Vì vậy, phân tích yêu cầu dung lượng sau khi shard cũng đòi hỏi xem xét tham số và activation phải được giữ trong bao lâu khi thực thi module.
10.2.2 Giữ activation và recomputation có chọn lọc
Các activation do tính toán forward để lại giống như các bước trung gian được ghi trên giấy nháp: khi tính toán backward quay về layer này, một số giá trị trong đó vẫn còn được cần đến. Giữ hết mọi công việc nháp làm việc lấy ra thuận tiện nhưng tốn không gian; chỉ giữ một số bước nghĩa là các giá trị thiếu phải được tính lại trước khi dùng. Sharding tham số đã giảm sự trùng lặp của weight và trạng thái optimizer; recomputation activation đổi lại việc tăng tính toán lấy không gian cần để lưu các giá trị trung gian này.
Xét phép toán ma trận , trong đó là dữ liệu vào, là weight, là đầu ra. Sau khi tính toán forward hoàn tất, vẫn phải đợi cho đến khi gradient của weight được tính. Gọi loss là , gọi là gradient được truyền từ tính toán xuôi dòng vào, và gọi , lần lượt là gradient của loss theo dữ liệu vào và theo weight; chỉ số trên biểu thị chuyển vị ma trận. Backward pass tính
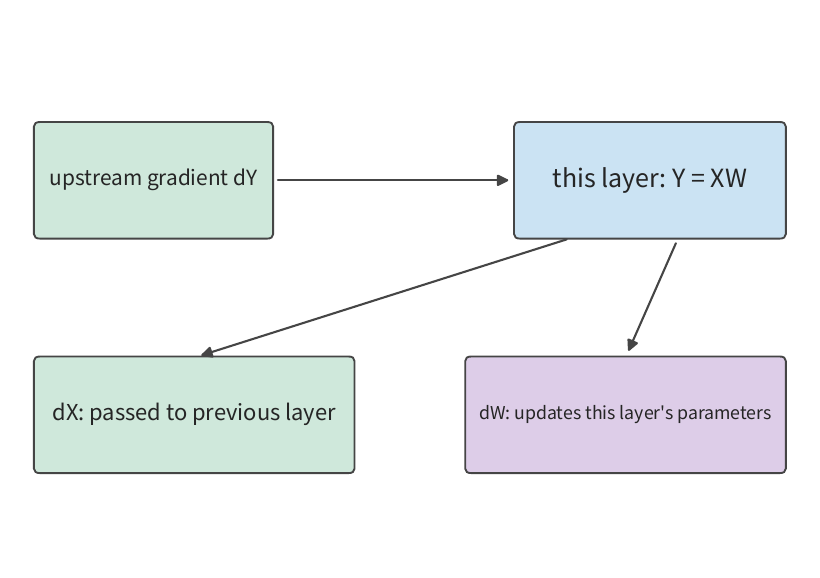
Tính gradient của tham số cần dữ liệu vào forward là . Nếu được giữ lại, nó phải cư trú từ lúc tính toán forward cho tới khi tính toán backward dùng xong nó; nếu được giải phóng, tính toán forward tương ứng phải được thực thi lại trước khi dùng trong backward, bắt đầu từ các dữ liệu vào hoặc kết quả trung gian được giữ lại. Giữ giá trị nào và tính lại giá trị nào phụ thuộc vào lượng không gian tiết kiệm được và lượng công việc mà việc tính lại đòi hỏi.
Ví dụ: tính lại tích của cổng (gate product) tiết kiệm bao nhiêu lưu trữ activation trước khi lan truyền ngược? MLP (multi-layer perceptron, mạng con truyền thẳng trong ví dụ này) của Qwen3-8B trước tiên tính kết quả cổng và kết quả chiếu lên , sau đó tạo thành , và cuối cùng tính . Gradient tham số của phép chiếu xuống cần . Nếu đã được giữ lại cho tính toán backward của toán tử phi tuyến, chúng có thể được nhân lại ngay trước backward pass của phép chiếu xuống, nên không cần được giữ suốt thời gian đó.
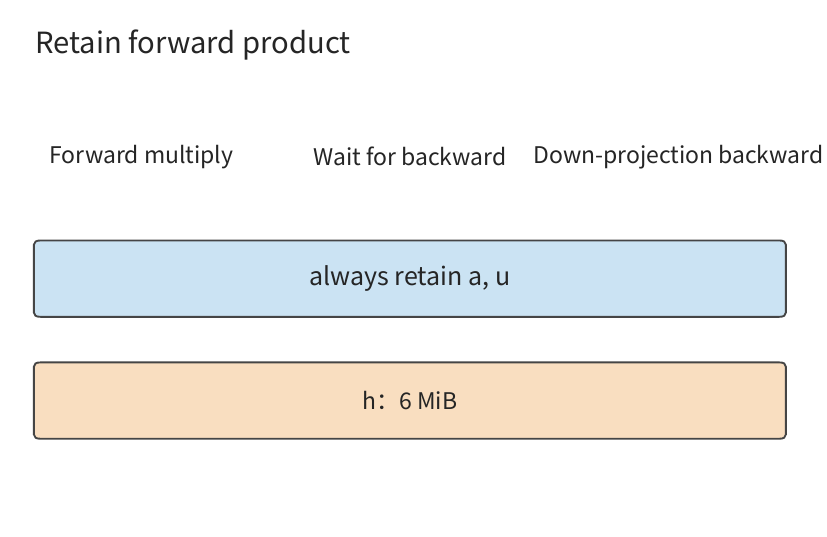
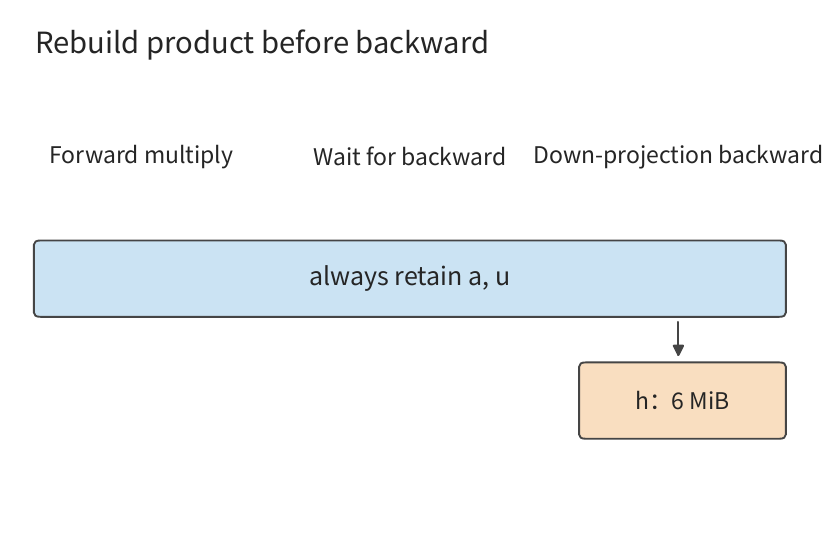
Sau khi dựng lại, h chỉ cần được tạo ra ngay trước khi backward pass của phép chiếu xuống bắt đầu, và được giữ đến khi phép tính đó hoàn tất. Kích thước buffer này như sau: với micro-batch 128 token và activation FP32, có hình dạng , chiếm MiB; dựng lại nó cần khoảng 1,57 triệu phép nhân. Hai đầu ra có trọng số chuẩn hóa trong cùng layer đều có hình dạng , mỗi cái chiếm 2 MiB, và cũng có thể được dựng lại từ các kết quả chuẩn hóa và weight đã lưu. Việc này tiết kiệm MiB mỗi layer, và 90 MiB mỗi micro-batch trên một giai đoạn pipeline chín layer, tức khoảng 94 MB.
Trong sơ đồ gốc, các dữ liệu vào được lưu cho các phép GEMM này chiếm 15 MiB mỗi layer, trong đó ba tích ở trên chiếm 10 MiB, còn Q, K, V và đầu ra attention chiếm 5 MiB còn lại. Giai đoạn chín layer vì thế giảm từ 135 MiB xuống 45 MiB, tức từ khoảng 142 MB xuống 47 MB. Việc dựng lại diễn ra lần lượt từng layer; buffer làm việc của tích lớn nhất là 6 MiB, và một khi một layer dùng xong, layer kế tiếp tái sử dụng chính không gian đó.
Nếu bốn micro-batch đồng thời đang chờ tính toán backward, lượng dữ liệu phải được giữ lâu dài giảm đi MiB, khoảng 377 MB, và phép tính dựng lại khi đó được thực hiện lần lượt từng micro-batch trong lúc backward. Lợi ích ở đây đến từ sự khác biệt về vòng đời dữ liệu: càng nhiều micro-batch chờ tính toán backward, càng nhiều dữ liệu phải được giữ lâu dài; nhưng khi dựng lại từng layer một, cùng một buffer làm việc có thể được tái sử dụng nhiều lần. Nếu lập lịch pipeline khiến tính toán backward bắt đầu sớm hơn, số micro-batch chờ tính toán backward giảm tương ứng. Recomputation và lập lịch pipeline vì vậy cùng nhau quyết định lượng dữ liệu phải được giữ; việc tính toán tăng thêm có kéo dài thời gian training mỗi bước hay không phụ thuộc vào vị trí của nó trên dòng thời gian.
10.2.3 Offloading CPU/GPU và thời gian dùng buffer
Khi chi phí dựng lại dữ liệu từ các kết quả đã lưu nhỏ, recomputation là một lựa chọn phù hợp. Một cách tiếp cận khác là giữ nguyên dữ liệu nhưng chuyển nó sang bộ nhớ host, nơi có dung lượng lớn hơn, và chuyển nó trở lại GPU trước khi dùng — đây là offloading (chuyển trạng thái sang host). Một khi chọn offloading, vấn đề bộ nhớ GPU ban đầu trở thành câu hỏi liệu việc truyền có thể hoàn thành kịp thời. Giả sử một phần trạng thái có kích thước , băng thông hiệu dụng của liên kết là , và có giây giữa lúc có thể bắt đầu truyền và lúc toán tử cần dữ liệu này; khi đó thời gian truyền vượt quá cửa sổ này là
và toán tử tương ứng phải chờ bấy nhiêu thời gian. Việc truyền và tính toán chồng lấp được bao nhiêu phụ thuộc vào khi nào dữ liệu có thể được gửi đi, khi nào liên kết rảnh, và khi nào toán tử tương ứng cần dữ liệu. Truyền DMA được khởi xướng bởi thiết bị, và dữ liệu nguồn phải giữ nguyên giá trị trong suốt quá trình truyền. Buffer nguồn giữ nguyên giá trị cho tới khi DMA hoàn tất, còn buffer đích chiếm bộ nhớ từ lúc nó bắt đầu nhận dữ liệu; offloading thay đổi thời gian dùng buffer ở cả hai đầu cùng lúc.
Ví dụ: chuyển đổi gradient trên CPU hay GPU — cách nào hoàn tất offloading nhanh hơn? Gradient của phép chiếu cổng có hình dạng ; kích thước BF16 của nó là MiB, và kích thước FP32 là 192 MiB. CPUAdam là một triển khai chạy cập nhật Adam trên CPU; nó dùng gradient FP32, nên có thể hoặc truyền BF16 trước rồi chuyển đổi trên CPU, hoặc chuyển đổi trên GPU trước rồi truyền FP32. Cả hai cách đều đọc và ghi , truy cập tổng cộng byte. Việc chuyển đổi bị giới hạn bởi băng thông bộ nhớ: với GPU ta lấy 1008 GB/s của RTX 4090, và với CPU ta lấy 307,2 GB/s của Xeon thế hệ thứ tư đơn socket tám kênh DDR5-4800. Gọi lần lượt là thông lượng chuyển đổi của CPU và GPU, và gọi là băng thông hiệu dụng của liên kết; thời gian của hai đường tuần tự là
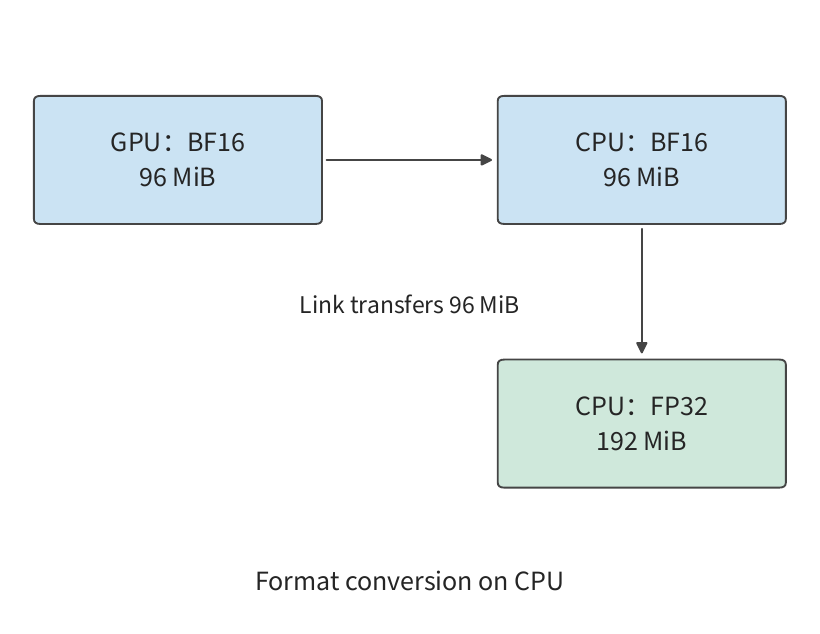
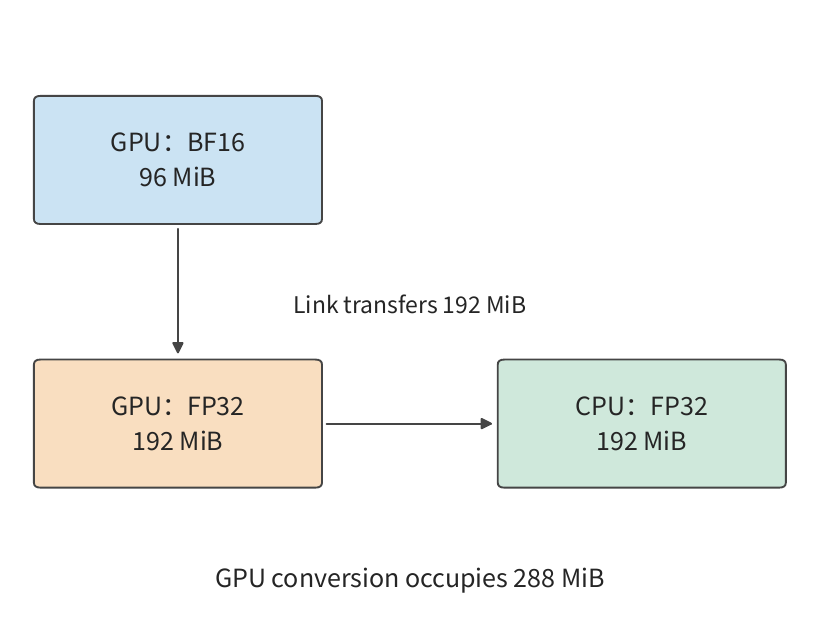
Sự khác biệt giữa Hình 10-14 và Hình 10-15 tập trung ở mũi tên băng qua liên kết: dù GPU chuyển đổi nhanh hơn, nó phải truyền thêm 96 MiB. Liên kết càng chậm, khoản truyền thêm này càng dễ triệt tiêu lợi ích chuyển đổi.
RTX 4090 kết nối với host qua PCIe 4.0 x16, ở 32 GB/s mỗi hướng. Trên liên kết này, đường CPU mất khoảng ms, và đường GPU mất khoảng ms. Việc chuyển đổi của đường GPU nhanh hơn khoảng 0,68 ms, nhưng truyền của nó chậm hơn khoảng 3,15 ms, khiến cả đường chậm hơn. Nếu liên kết thay vào đó là NVLink-C2C giữa CPU và GPU trong GH200, ở 450 GB/s mỗi hướng, 96 MiB truyền thêm chỉ thêm khoảng 0,22 ms; hai đường trở thành khoảng 1,21 ms và 0,75 ms, và chuyển đổi trên GPU giành lợi thế rõ ràng.
Đặt thời gian hai đường bằng nhau cho ra ngưỡng băng thông tại đó phương pháp nhanh hơn đổi chỗ:
Ngưỡng này đặt hai hiệu ứng đối nghịch lên cùng một thang đo: chuyển đổi trên GPU nhanh hơn, tiết kiệm thời gian chuyển đổi định dạng; dữ liệu FP32 lớn hơn, làm tăng thời gian truyền. Liên kết càng nhanh, chi phí sau này càng nhỏ. Vì 147 GB/s vượt quá 64 GB/s mỗi hướng của PCIe 5.0 x16, các thẻ kết nối qua PCIe trong ví dụ này luôn nên truyền BF16 trước rồi chuyển đổi trên CPU.
Dung lượng bộ nhớ GPU tạo thêm một ràng buộc nữa. Trong quá trình chuyển đổi trên GPU, 96 MiB gốc và 192 MiB đầu ra cùng tồn tại, cho đỉnh 288 MiB; đường truyền BF16 trước chỉ cần giữ trên GPU 96 MiB gradient tham gia chuyển đổi đó. Chọn chuyển đổi trên GPU đòi hỏi thêm một buffer 192 MiB. SuperOffload là một hệ thống offload cho training trên các chip CPU-GPU ghép chặt như GH200; nó lập lịch vị trí chuyển đổi cùng với việc thực thi optimizer trên host, khai thác chính xác sự đánh đổi này giữa tốc độ chuyển đổi, khối lượng dữ liệu truyền và thời gian dùng buffer. Lợi ích tổng thể của bước khi đó được quyết định bởi thời điểm bucket gradient cuối cùng, cập nhật tham số phía CPU và truyền weight trở lại — tất cả hoàn tất.
10.2.4 Phân bổ trạng thái mỗi thẻ và tô-pô liên kết trong các sơ đồ song song kết hợp
Sharding, recomputation và offloading lần lượt thay đổi khối lượng lưu trữ, tính toán và truyền. Khi kết hợp các cách tiếp cận này thành một hệ thống hoàn chỉnh, người ta còn phải xác định chúng tác động lên những thẻ và nhóm truyền thông nào. Các phương pháp song song hóa trong Chương 6 và Chương 7 phân vùng các dữ liệu và phép tính khác nhau trong lúc training: TP chia các ma trận trong layer, PP phân vùng các layer, DP phân vùng các mẫu, và EP phân vùng các expert. Bảng tổng quan trong Mục 6.1.4 còn có SP và CP: loại trước shard các activation của các toán tử theo token dọc theo chuỗi, thường tái sử dụng nhóm tensor-parallel; loại sau phân phối ngữ cảnh attention của cùng một chuỗi dài cho nhiều thẻ, giữ các phụ thuộc giữa các vị trí. Các phương pháp song song này mở rộng cách tiếp cận “xếp gạch — sắp xếp đầu vào — hợp nhất kết quả” từ Chương 5, với training sau đó lan truyền gradient ngược theo cùng đồ thị tính toán. Bằng cách trước tiên xác định ai cập nhật từng tham số, rồi sắp xếp việc thu gom, trao đổi và giảm dọc theo các phụ thuộc forward và backward, một người sẽ đồng thời thu được cả dung lượng mỗi thẻ lẫn lưu lượng tại từng giao diện.
Ba biện pháp tối ưu dung lượng có thể được so sánh bằng cùng một bộ câu hỏi.
| Phương pháp | Giảm vết bộ nhớ gì | Phần công việc thêm vào | Quan hệ thời gian quyết định lợi ích |
|---|---|---|---|
| Sharding trạng thái | Weight, gradient hoặc trạng thái optimizer bị trùng lặp | Thu gom tham số, giảm và shard gradient | Việc thu gom có kịp hoàn tất trước khi module thực thi hay không |
| Recomputation activation | Các giá trị trung gian được giữ từ forward đến backward | Dựng lại các giá trị forward | Việc dựng lại có làm chậm tính toán backward trên đường tới hạn hay không |
| Offloading trạng thái | Trạng thái tạm thời không dùng trên accelerator | Truyền giữa host và accelerator | Dữ liệu có được truyền về trước khi dùng hay không |
Ví dụ: khi bộ nhớ GPU không đủ, nên tăng số bên tham gia sharding hay tính lại activation? RTX 4090 được định mức danh nghĩa 24 GB, khoảng 22,35 GiB; sau khi trừ chi phí runtime, ta tính 22 GiB bộ nhớ GPU dùng được mỗi thẻ. Qwen3-8B với ZeRO-3 trên tám thẻ giữ khoảng 15,3 GiB mỗi thẻ, để lại khoảng 6,7 GiB cho các tensor và buffer khác. Nếu activation và buffer tạm cùng lúc cần 10 GiB, tổng khoảng 25,3 GiB, vượt ngân sách khoảng 3,3 GiB. Lúc này, có thể dùng recomputation để tiết kiệm 3,3 GiB này, hoặc tăng lên mười sáu thẻ, hạ trạng thái training cư trú xuống khoảng 7,6 GiB, đưa tổng xuống khoảng 17,6 GiB.
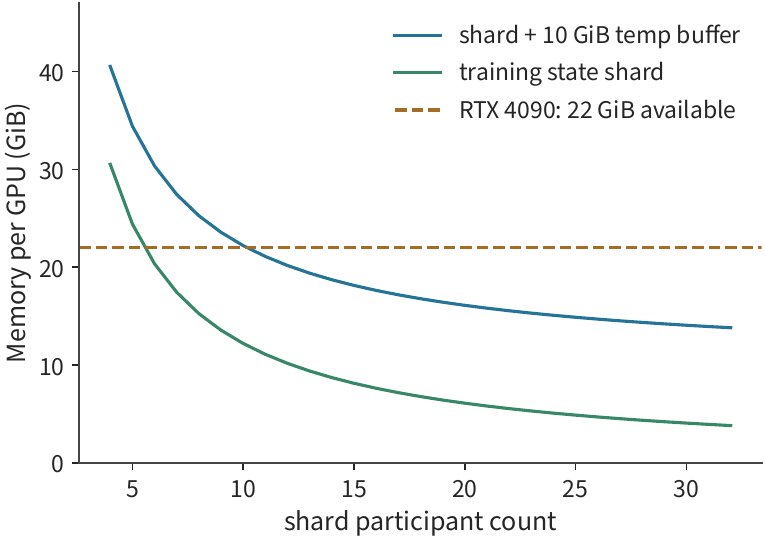
Hai lựa chọn tương ứng với các chi phí khác nhau: sơ đồ tám thẻ thêm tính toán dựng lại, còn sơ đồ mười sáu thẻ thêm thẻ và thay đổi nhóm truyền thông. Trước tiên có thể xác định từ hình sơ đồ nào thỏa mãn yêu cầu bộ nhớ, rồi so sánh thời gian mỗi bước của các sơ đồ đó.
Với nhiệm vụ training trong chương này, cả sơ đồ 32 thẻ lẫn 48 thẻ đều dùng ZeRO-3 toàn nhóm, với TP=PP=1, và micro-batch của mỗi thẻ là một chuỗi. Như ví dụ trước, ta tính 22 GiB bộ nhớ GPU dùng được mỗi thẻ, và dành ngân sách 10 GiB cho các activation, tham số đầy đủ của module và buffer làm việc được giữ đồng thời. Trạng thái training cư trú của hai sơ đồ lần lượt khoảng 3,8 và 2,5 GiB, cho tổng khoảng 13,8 và 12,5 GiB, với biên dư dung lượng khoảng 8,2 và 9,5 GiB. Bộ nhớ GPU đủ cho cả hai sơ đồ, nên so sánh giờ đây chủ yếu chuyển sang thời gian hoàn thành.
10.3 Lập lịch pipeline và chồng lấp truyền thông trong một bước training
Phân tích dung lượng xác định bộ nhớ GPU có thể chứa dữ liệu cần thiết hay không; phân tích thời gian xác định dữ liệu có đến kịp hay không. Mục này trước tiên làm rõ hàm mục tiêu được tối ưu trong một vòng lặp training, rồi đặt tính toán forward, tính toán backward và truyền thông trên cùng một dòng thời gian. Tình huống thiết kế trong chương này dùng data parallelism; một pipeline bốn giai đoạn làm ví dụ độc lập, minh họa lập lịch đồng thời thay đổi cả đường tới hạn lẫn vòng đời activation.
10.3.1 Micro-batch, tích lũy gradient và cập nhật tham số
Global batch chứa tất cả các mẫu dùng cho một lần cập nhật tham số, và có thể được chia thành nhiều micro-batch thực thi lan truyền ngược theo trình tự, tích lũy gradient trước khi cập nhật thống nhất. Gọi tập chỉ số các token hợp lệ trong micro-batch là , gọi tổng số token hợp lệ là , và gọi loss trung bình mỗi token là
Phép tổng và phép lấy vi phân có thể hoán đổi cho nhau, nên lan truyền ngược có thể được thực thi riêng cho từng micro-batch; khi tính loss của mỗi micro-batch, tổng loss của nó được chia cho cùng mỗi lần. Một khi gradient từ tất cả các micro-batch đã được tích lũy, một lần cắt gradient (gradient clipping) và một lần cập nhật tham số được thực hiện. Chia thành micro-batch theo cách này chỉ thay đổi thứ tự thực thi, không thay đổi trọng số mà mỗi token mang trong hàm loss.
Ví dụ: vì sao lấy trung bình theo micro-batch khác theo token lại đổi gradient? Trong tám phản hồi, bốn phản hồi mỗi cái chứa hai token hợp lệ và bốn cái mỗi cái chứa ba token, tổng cộng 20. Gọi loss mỗi token của một phản hồi ngắn là và của một phản hồi dài là ; khi đó
Nếu trước tiên tính loss trung bình của mỗi phản hồi, rồi lấy trung bình trên tám phản hồi, phản hồi ngắn và dài mỗi loại mang nửa trọng số, và gradient trở thành . Với phép lấy trung bình theo token ban đầu, phản hồi dài chiếm , nên kết quả nghiêng gần về 0,4. Nếu mẫu số chung 20 đã được áp dụng, và kết quả tích lũy lại bị chia cho tám, gradient trở thành 0,04. Mẫu số quyết định đóng góp của mỗi token vào gradient của tham số.
Quay lại tình huống thiết kế: 384 chuỗi đủ độ dài từ Mục 10.1.3 tích lũy 12 micro-batch mỗi thẻ trên 32 thẻ, và 8 micro-batch mỗi thẻ trên 48 thẻ. Mỗi thẻ xử lý một chuỗi tại một thời điểm, và mọi thẻ thực thi cùng hình dạng ma trận; tổng số token hợp lệ toàn cục và hàm mục tiêu cũng giống nhau. Thu gom tham số và truyền thông gradient sau đó được lập lịch riêng lên dòng thời gian theo đường thực thi.
10.3.2 Lập lịch pipeline, bubble và vòng đời activation
Chia thành micro-batch giữ nguyên mục tiêu training nhưng thay đổi thứ tự tính toán diễn ra. Trong pipeline parallelism (song song pipeline), thứ tự này còn quyết định khi nào mỗi giai đoạn có thể bắt đầu tính toán và có bao nhiêu bản sao activation đang chờ tính toán backward. Pipeline parallelism chia model thành nhiều giai đoạn, với mỗi micro-batch đi forward theo trình tự rồi lan truyền gradient ngược. Lập lịch fill-drain hoàn tất forward pass của tất cả các micro-batch trước, rồi thực thi backward pass trong một khối tập trung. 1F1B (one forward, one backward — một forward, một backward) xen kẽ một forward và một backward pass sau khi pipeline khởi động xong, để các micro-batch sớm hơn giải phóng activation của chúng sớm hơn.
Tốc độ giải phóng activation quyết định trực tiếp bộ nhớ đỉnh. Tính toán backward cần các activation được lưu trong forward pass, nên activation của mỗi micro-batch phải ở trong bộ nhớ từ lúc tính toán forward kết thúc cho đến khi backward pass tương ứng đến. Có bao nhiêu micro-batch đồng thời chờ tính toán backward, thì có bấy nhiêu bản sao activation nằm trong bộ nhớ. Fill-drain phải chờ cả micro-batch hoàn tất tính toán forward trước khi bắt đầu backward pass đầu tiên, nên đỉnh tăng tuyến tính theo ; một khi vượt quá dung lượng bộ nhớ, bước training này hoàn toàn không thể thực thi, và người ta chỉ có thể giảm số micro-batch đồng thời trong pipeline, rút ngắn chuỗi, hoặc chuyển sang recomputation đắt hơn để thực thi được. Thực thi tính toán backward sớm hơn nghĩa là kết thúc sớm hơn thời kỳ chờ của activation: một khi đỉnh hạ xuống, bước training trở nên khả thi, hoặc biên dư giải phóng ra có thể dành cho micro-batch lớn hơn và chuỗi dài hơn. Vì vậy, sự cư trú trong bộ nhớ thường không phải là câu hỏi về tốc độ mà là về việc thực thi có khả thi hay không.
So sánh hai sơ đồ lập lịch bất kỳ đòi hỏi xem xét đồng thời hai trục: một là thời gian hoàn thành, được quyết định bởi kích thước thời gian chờ rảnh (bubble) trong pipeline; hai là sự cư trú trong bộ nhớ, được quyết định bởi mỗi activation phải được giữ trong bao lâu trước khi backward pass tương ứng của nó đến.
Giả sử trước tiên giai đoạn được cân bằng hoàn hảo, với thời gian forward và thời gian backward mỗi giai đoạn, và thời gian truyền cùng cập nhật tham số lấy bằng không. Việc điền và rút cạn micro-batch cần
Hạng tử ở đây tương ứng với công việc tính toán thực tế của các micro-batch, còn hạng tử đến từ việc điền và rút cạn. Vì vậy mức sử dụng tăng khi số micro-batch tăng. Lấy cho . Nếu global batch size giữ cố định, tăng số micro-batch nghĩa là thu nhỏ từng cái; mức giảm thời gian rảnh của pipeline tạo thành phải được cân với thời gian thực thi của các ma trận nhỏ hơn này.
Ví dụ: với cùng bubble, 1F1B mua được gì? Chia 36 layer của Qwen3-8B thành bốn giai đoạn chín layer, với tám micro-batch, mỗi cái chứa một chuỗi 128 token. Forward pass mỗi giai đoạn mất 10 ms, backward pass mất 20 ms, truyền biên mất 1 ms mỗi chiều, liên kết forward và backward độc lập, và cập nhật tham số mất 1 ms. Lập lịch fill-drain không tính truyền mất ms; điền forward qua ba biên thêm 3 ms, rút cạn backward thêm 3 ms, và cập nhật tham số thêm 1 ms, tổng cộng 337 ms.
1F1B bắt đầu tính toán backward sớm hơn, nên các forward pass tiếp theo phải chờ backward pass giải phóng tài nguyên tính toán. Ở giai đoạn 0, bốn micro-batch đầu hoàn tất tính toán forward ở 40 ms, và gradient được trả về đầu tiên đến ở 106 ms. Tính toán backward sau đó chạy đến 126 ms, lúc đó micro-batch thứ năm bắt đầu forward pass. Sự xen kẽ này làm các thời điểm đến ở hạ nguồn dồn dần từng mức. Giai đoạn 3 hoàn tất backward pass của micro-batch thứ hai ở 93 ms, nhưng đầu vào forward thứ ba không đến cho đến 95 ms, tạo ra một khoảng trống 2 ms; các lần chờ tương tự tiếp theo tiếp tục kéo dài đường tới hạn. Sau khi lập lịch thứ tự thực thi theo các phụ thuộc này, mọi gradient hoàn tất tính toán ở 346 ms, và cộng cập nhật tham số, tổng là 347 ms.
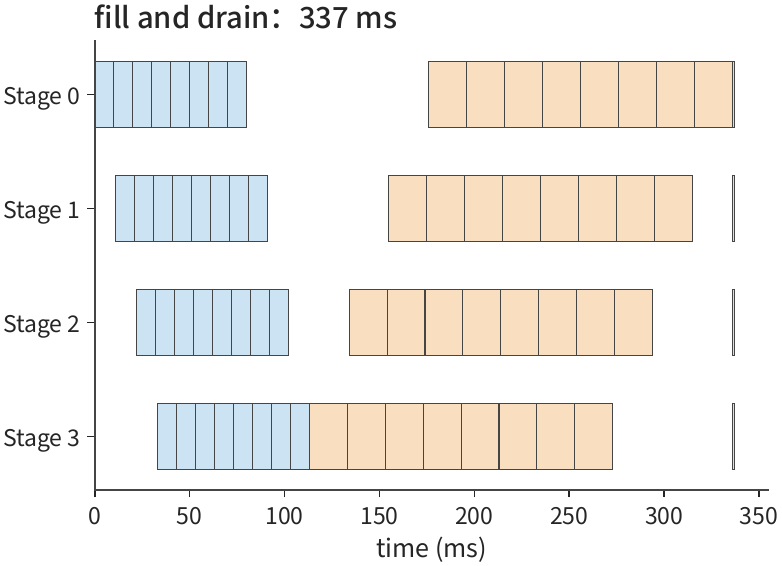
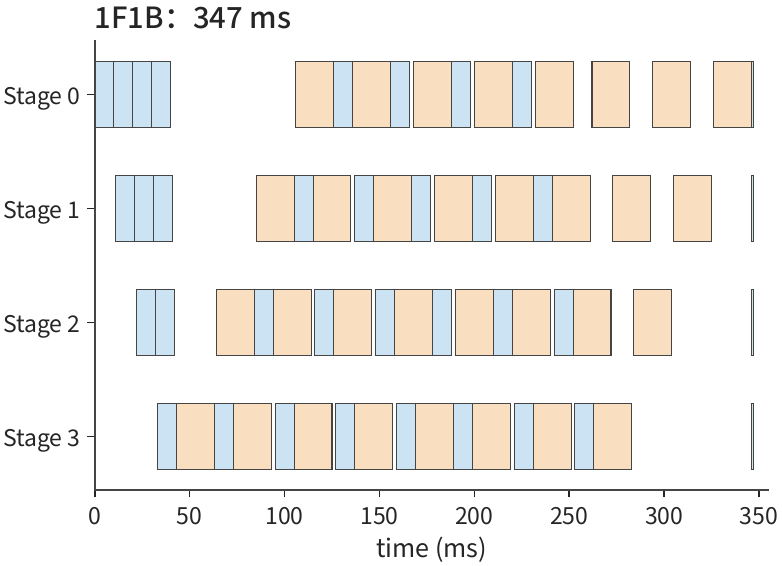
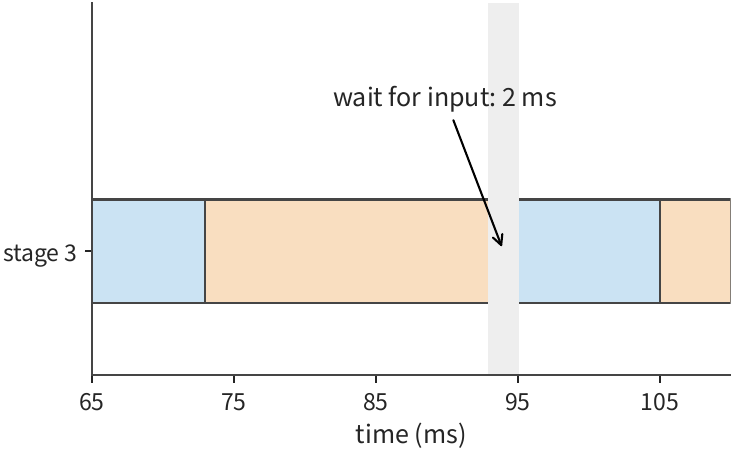
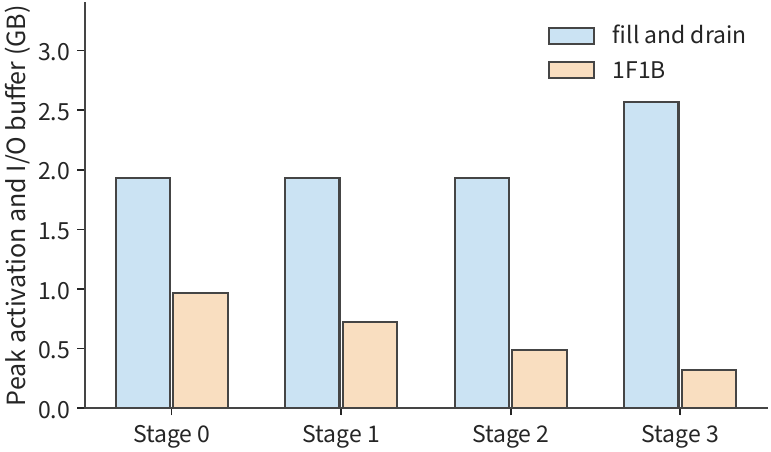
So sánh hai hình cho thấy cả hai lịch trình đều thực hiện cùng công việc forward và backward, và thời gian bubble là như nhau trong cả hai; 1F1B, vì các lần chờ phụ thuộc do việc xen kẽ tạo ra (Hình 10-19), thực ra mất lâu hơn khoảng 3%, nhưng lợi ích hiện ra ở Hình 10-20 — bộ nhớ đỉnh của các kết quả trung gian và buffer giảm từ khoảng 2,57 GB xuống 0,97 GB, giảm khoảng 62%. Vậy “1F1B tốt hơn fill-drain” chỉ đúng trên trục bộ nhớ; trên trục thời gian nó thực ra chậm hơn một chút. Nếu chỉ dành ngân sách 1 GB cho các kết quả trung gian và buffer này, chỉ lịch trình backward sớm hơn mới thực thi được bước training này; khi dung lượng dư dả, lịch trình fill-drain 337 ms hoàn thành sớm hơn. Chọn lịch trình nào được quyết định chung bởi “khi nào tensor được giải phóng” và “khi nào đầu vào tiếp theo có sẵn”.
Để rút ngắn thời gian hoàn thành, bản thân bubble phải được nén: chia tính toán backward mịn hơn và giữ nhiều micro-batch chảy đồng thời hơn sẽ lấp đầy các khoảng trống đầy hơn. Ba lớp lịch trình dưới đây đều xây trên phân tích phụ thuộc ở trên, lần lượt đổi số lần truyền thông, activation đỉnh và số tham số lấy một bubble nhỏ hơn. Cả ba dùng cùng một ví dụ (bốn giai đoạn, forward 10 ms, backward 20 ms, truyền biên 1 ms, cập nhật tham số 1 ms); thứ tự thực thi của mỗi micro-batch tại mỗi giai đoạn (slot order) được lập lịch bằng một mô hình sự kiện, và các công thức bubble cùng ý tưởng chia backward đến từ các bài báo đã công bố.
Interleaved 1F1B (còn gọi là virtual pipelining) cắt 36 layer thành tám khối, phân phối vòng quanh cho bốn thẻ, cho mỗi thẻ khối không liền nhau, tổng cộng vẫn chín layer như trước: bốn khối đầu mỗi khối năm layer, bốn khối sau mỗi khối bốn layer; thẻ 0 thực thi layer 0–4 và layer 20–23, phần còn lại tương tự. Forward pass của mỗi micro-batch vì thế băng qua biên thay vì 3, và tỷ lệ bubble thu nhỏ từ xuống
Với tám micro-batch, thời gian hoàn thành giảm từ 347 ms xuống 298 ms, và thời gian rảnh mỗi thẻ giảm từ khoảng 106 ms xuống khoảng 57 ms. Có hai cái giá: số lần truyền tăng hơn gấp đôi (số thông điệp forward của cả bước tăng từ 24 lên 56), và activation của các giai đoạn sớm phải chờ nhiều khối hơn hoàn tất tính toán forward — activation đỉnh và buffer gửi/nhận của giai đoạn 0 tăng từ 921 MiB lên khoảng 1.329 MiB.
Zero-bubble chia tính toán backward thành hai phần: gradient đầu vào (bài báo ký hiệu là B) phải được truyền cho giai đoạn trước, vốn đang chờ nó, nên nằm trên đường tới hạn và nên thực thi càng sớm càng tốt; gradient weight (bài báo ký hiệu là W) chỉ nuôi phần tích lũy gradient của layer này và có thể được đặt ở bất kỳ thời điểm nào sau tương ứng của giai đoạn này, nên được trì hoãn để lấp các khoảng trống. Gọi thời gian mỗi giai đoạn của forward, và lần lượt là , và ; khi đó bubble của 1F1B là ; ZB-H1 lấp vào các khoảng trống, giảm bubble xuống ; ZB-H2 chuyển nhiều forward pass về sớm hơn, giảm bubble xuống . Hai lịch trình được dựng thủ công trong bài báo zero-bubble được xây với ; Bảng 2 của bài báo cho dạng tổng quát ở trên.
Trong ví dụ này, chia backward pass 20 ms đều thành ms: bubble của 1F1B là ms, cận dưới của ZB-H1 là ms, và cận dưới của ZB-H2 là 0. Lập lịch các sự kiện theo thứ tự slot ZB-H1 trong Hình 3 của bài báo, tám micro-batch hoàn thành trong 283 ms, với 42 ms thời gian rảnh mỗi thẻ; đặt truyền biên bằng không, thời gian rảnh đúng bằng cận dưới 30 ms, với 12 ms thừa ra đến từ truyền. Activation đỉnh và buffer gửi/nhận của giai đoạn 0 giống như của 1F1B, 921 MiB. Cái giá rơi vào các giai đoạn sau: của giai đoạn 3 thực thi muộn hơn của nó ba micro-batch, và mô hình sự kiện giữ một bản sao đầy đủ của activation trong suốt giai đoạn này, nâng đỉnh của giai đoạn 3 từ 308 MiB của 1F1B lên khoảng 1.226 MiB. Bài báo tính điều này bằng lượng activation nhỏ hơn thực sự cần cho , và Bảng 2 của nó đưa đỉnh của ZB-H1 là cùng ( là lượng activation của một micro-batch) như 1F1B.
DualPipe chia micro-batch thành hai nửa, bơm chúng từ hai đầu pipeline hướng vào nhau, nên mỗi giai đoạn đồng thời mang các khối từ cả hai hướng. Theo ký hiệu của DeepSeek-V3, bubble của nó là , trong đó là số giai đoạn pipeline, là khoảng thời gian forward và backward tính toán chồng lấp, biểu thị toàn bộ backward pass 20 ms, và biểu thị phần 10 ms của nó. Ví dụ này không mô phỏng việc forward và backward tính toán chồng lấp, lấy ms, cho bubble ms và thời gian hoàn thành 306 ms. Cái giá cũng trực tiếp không kém: mỗi thẻ phải lưu bản sao tham số cho cả hai hướng, nhân đôi số tham số, và activation được giữ cho bản sao; trong ví dụ này, đỉnh mỗi giai đoạn khoảng 1.228–1.612 MiB.
Bảng dưới đặt năm lịch trình này cạnh nhau trong cùng một ví dụ. Fill-drain, dù không nén bubble, vẫn là đường cơ sở khi dung lượng dư dả, và được liệt kê cùng các lịch trình khác:
| Lịch trình (tám micro-batch) | Thời gian hoàn thành / ms | Thời gian rảnh mỗi thẻ / ms | Đỉnh giai đoạn 0 / MiB | Cơ chế nén bubble | Chi phí chính |
|---|---|---|---|---|---|
| Fill-drain | 337 | 96 | 1,840 (giai đoạn 3: 2,448) | Không có | Cư trú activation cao nhất; không khả thi khi dung lượng chật |
| 1F1B | 347 | 106 | 921 | Không có (bubble bằng fill-drain) | Rẻ nhất về bộ nhớ, nhưng chậm hơn fill-drain khoảng 3% |
| Interleaved 1F1B, | 298 | 57 | 1,329 | Các khối layer mỗi thẻ được chia thành đoạn | Số thông điệp forward tăng từ 24 lên 56 |
| Zero-bubble (ZB-H1), | 283 | 42 | 921 (giai đoạn 3: 1,226) | bị trì hoãn để lấp khoảng trống | Activation của các giai đoạn sau phải được giữ đến khi thực thi |
| DualPipe | 306 | 65 | 1,228 (giai đoạn 1, 2: 1,612) | Micro-batch chảy từ hai đầu hướng vào nhau | Hai bản sao tham số mỗi thẻ |
Vẽ các con số trong bảng lên dòng thời gian của từng giai đoạn cho thấy chính xác chỗ nào bubble được lấp đầy. Ba hình dưới dùng cùng thang thời gian và màu sắc với Hình 10-17 và Hình 10-18.
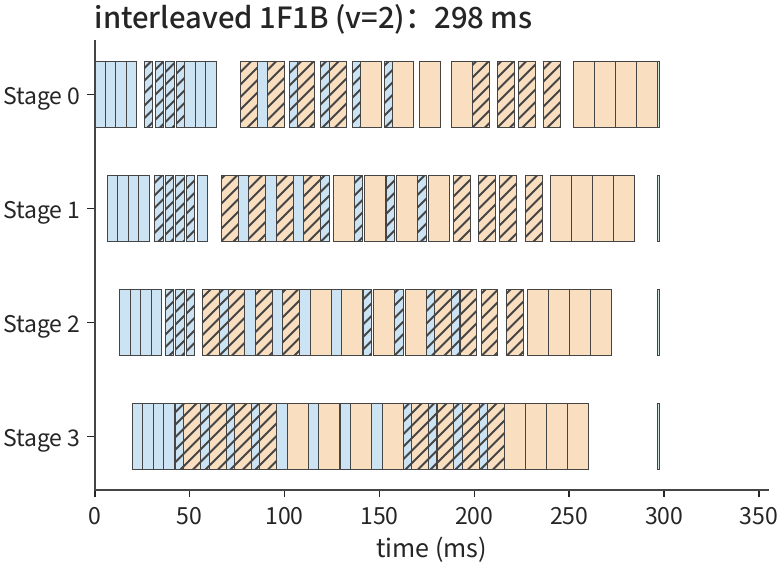
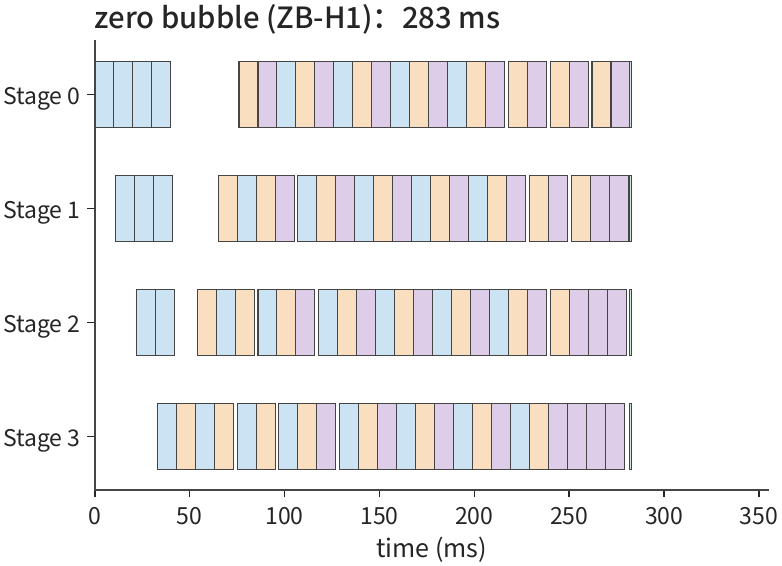
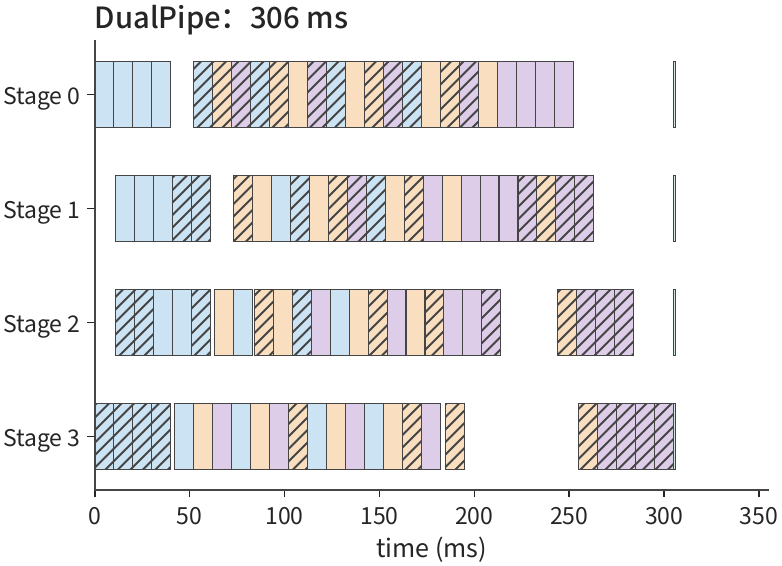
Không một lịch trình nào chiếm ưu thế trên cả hai trục. Xếp hạng năm lịch trình riêng theo từng trục cho ra người thắng khác nhau mỗi lần: zero-bubble có thời gian hoàn thành ngắn nhất, còn 1F1B có đỉnh tối đa của một giai đoạn thấp nhất. Thời gian tiết kiệm được từ việc nén bubble của ba lịch trình mở rộng đều đổi lấy việc tăng một tài nguyên khác, nên chọn lịch trình đòi hỏi trước tiên xác định ràng buộc nằm ở phía nào: thời gian hay dung lượng. Hình 10-24 vẽ cả hai trục cạnh nhau (fill-drain không được vẽ), để đối chiếu với bảng trên.
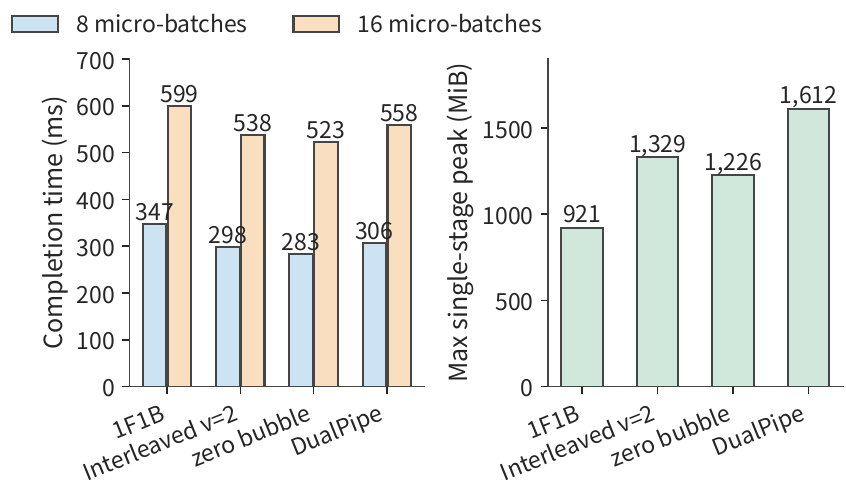
Khi số micro-batch tăng gấp đôi lên 16, thời gian hoàn thành của 1F1B, interleaved, zero-bubble và DualPipe lần lượt là 599, 538, 523 và 558 ms, cùng thứ hạng như trước. Việc nén bubble có đáng hay không phụ thuộc vào độ lớn tương đối của thời gian bubble tiết kiệm được so với chi phí thêm vào. Khi tăng, tỷ lệ bubble tự nó cứ giảm — ở 16 micro-batch, phần bubble của 1F1B đã giảm từ 37,5% xuống 18,8%, nên lợi ích tương đối của việc chia mịn hơn thu nhỏ tương ứng, trong khi số truyền thông thêm vào của interleaved, cư trú activation thêm vào của zero-bubble và số tham số thêm vào của DualPipe không thu nhỏ theo . Việc tranh chấp liên kết được bàn trong Mục 10.3.3 cho thêm một ranh giới nữa: bốn lần truyền xuyên biên mà interleaved thêm vào cho mỗi micro-batch sẽ trực tiếp kéo dài đường tới hạn khi liên kết đã bị giảm gradient bão hòa. Khi dung lượng chật, thứ tự chọn đảo ngược: trước tiên loại các lịch trình không khả thi về đỉnh dùng theo Mục 10.2.4, rồi mới so sánh thời gian hoàn thành.
10.3.3 Phụ thuộc backward, gộp nhóm gradient và chồng lấp truyền thông
Khoảng trống 2 ms ở mục trước đến từ việc dữ liệu vào chưa đến. Truyền thông gradient tuân theo cùng một quy tắc: gửi phải chờ dữ liệu được sinh ra, và một khi bắt đầu gửi, còn phải chờ liên kết rảnh. Lan truyền ngược sinh gradient từng layer; các triển khai thường gộp nhiều tensor gradient vào một bucket truyền thông duy nhất và chỉ gửi sau khi mọi gradient trong bucket đã được tính. Bucket càng lớn, càng dễ chờ gradient được sinh ra cuối cùng; bucket càng nhỏ, truyền thông phải được khởi động càng nhiều lần. Lập lịch phải cân chi phí khởi động với việc gửi sớm.
Giả sử một phép giảm cần 3 ms, và sau khi gradient sẵn sàng có 5 ms tính toán không liên quan, trong đó phép giảm có thể tiến hành đồng thời. Nếu liên kết dùng chung đã được lập lịch 4 ms trao đổi expert trước đó, phép giảm chỉ có thể dùng 1 ms còn lại, để 2 ms kéo dài quá cuối phần tính toán. Phần này, không thể chồng lấp với tính toán và làm kéo dài bước training, được gọi là thời gian chờ truyền thông (communication wait time). Phụ thuộc dữ liệu xác định thời điểm bắt đầu sớm nhất có thể, tranh chấp tài nguyên đẩy nó muộn hơn, và các phụ thuộc của toán tử tiếp theo xác định lần chờ này có kéo dài toàn bộ bước training hay không.
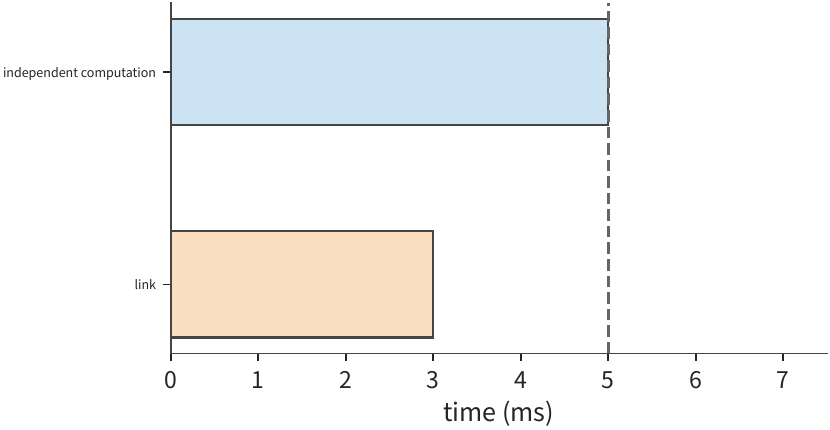
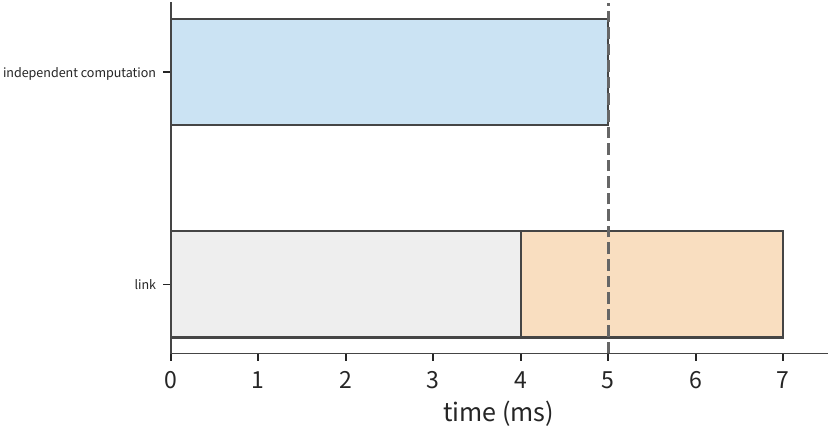
Hình 10-25 cố định tạm thời thời điểm gradient được sinh ra. Trong training thực tế, thứ tự tính toán cũng có thể được thay đổi để một số gradient được sinh ra sớm hơn, nhờ đó chuyển phép giảm về sớm hơn trên dòng thời gian. Trong tính toán backward của ma trận, gradient đầu vào được truyền sang layer trước để tiếp tục lan truyền ngược, còn gradient tham số được trao cho phần giảm của layer này. Tính trước cho phép layer trước bắt đầu lan truyền ngược sớm hơn; tính trước cho phép truyền thông gradient của layer này bắt đầu sớm hơn. Khi hai việc tranh cùng một tài nguyên tính toán, thay đổi thứ tự sẽ tái phân bổ cửa sổ truyền thông. Đây cũng là lý do lập lịch training phải tính đồng thời cả phụ thuộc forward lẫn backward.
Giờ dùng quy tắc này để tính thời gian chờ truyền thông cho tình huống thiết kế. Cả hai sơ đồ đều dùng ZeRO-3 toàn nhóm; mỗi micro-batch cần ba lần truyền thông tập thể: một AllGather để thu gom weight BF16 trước forward pass, một AllGather nữa trước backward pass, và một ReduceScatter trên gradient BF16 sau backward pass. Trong mỗi lần truyền thông tập thể, số byte mỗi thẻ gửi và nhận là , khoảng 16,0 GB ở 48 thẻ. Mỗi thẻ tích lũy micro-batch, và khối lượng truyền thông cho một bước là
Ở 48 thẻ, , GB; ở 32 thẻ, , GB. Đường truyền của các byte này được xác định bởi phần cứng. RTX 4090 không có NVLink và không hỗ trợ P2P xuyên thẻ (một thẻ trực tiếp đọc/ghi bộ nhớ GPU của thẻ khác qua PCIe); ngay cả hai thẻ trong cùng một host cũng phải trao đổi dữ liệu qua bộ nhớ host, nên mọi lần gửi và nhận trên mỗi thẻ đều phải đi qua PCIe 4.0 x16 của chính nó, 32 GB/s mỗi hướng. Dựa trên một cấu hình cluster 4090 đã công bố, mỗi host tám thẻ được trang bị tám NIC 200 Gbit/s, 25 GB/s mỗi cái; truyền thông tập thể dạng vòng (ring) trải lưu lượng liên host qua tám NIC, nên các NIC không phải nút thắt cổ chai. Thời gian liên kết mỗi bước ở 48 thẻ vì vậy khoảng s, và khoảng 17,9 s ở 32 thẻ.
Thời gian liên kết không giống thời gian chờ truyền thông. ZeRO-3 nạp trước (prefetch) tham số của một layer trước khi thực thi layer đó, và giảm gradient của nó ngay sau khi backward pass của layer đó kết thúc. Ở 48 thẻ, thời gian liên kết mỗi micro-batch khoảng 1,50 s, trong khi tính toán cho micro-batch đó khoảng 6,53 s; từng layer một, thu gom khoảng 0,39 GB tham số của một layer chỉ mất khoảng 12 ms, cũng ngắn hơn nhiều tính toán của layer đó. Vậy hầu hết truyền thông có thể nằm gọn trong tính toán. MegaScale áp dụng cùng cách tiếp cận trong data parallelism, và ghi nhận truyền thông duy nhất không thể ẩn được là AllGather đầu tiên và ReduceScatter cuối cùng trong một bước. Với Qwen3-8B, cả hai lần truyền thông này đều tác động lên khoảng 1,24 GB word embedding: word embedding là layer đầu tiên trong forward pass và cũng là layer cuối cùng có gradient được tính trong backward pass. Hai lần cộng lại tổng cộng khoảng 0,08 s, đây chính là thời gian chờ truyền thông mỗi bước. Cập nhật tham số và các phép toán phi ma trận trong một thẻ đã được tính trong hiệu quả tính toán của từng thẻ; thời gian mỗi bước của hai sơ đồ khi dữ liệu vào sẵn sàng lần lượt khoảng 78,4 s và 52,3 s.
Hầu hết truyền thông được tính toán che phủ, và điều này cũng đặt một cận trên cho mức tăng tối ưu. Nếu chỉ 0,2 s trong một phép giảm 1,3 s kéo dài quá cuối tính toán backward, và mọi thứ khác trên dòng thời gian giữ nguyên, thì loại bỏ lần chờ truyền thông này rút ngắn bước đi nhiều nhất 0,2 s. Nếu mục tiêu vẫn cần rút ngắn 0,5 s, các công việc khác trên đường tới hạn cũng phải được rút ngắn đồng thời.
Tình huống: với global batch size cố định, tăng gấp bốn số thẻ cho tốc độ tăng bao nhiêu? Hệ thống training phân tán quy mô lớn MegaScale giữ global batch size ở 6144 cho một model 175B trong khi tăng số thẻ từ 3072 lên 12288. Thời gian mỗi bước ban đầu khoảng 23,7 s; nếu tăng gấp bốn số thẻ cho tốc độ tăng gấp bốn, thời gian mỗi bước nên rút ngắn xuống khoảng 5,9 s, nhưng kết quả thực tế khoảng 6,3 s. Tăng tốc tổng thể khoảng 3,7x, tương ứng hiệu quả mở rộng khoảng 93%. Khi số thẻ tăng, công việc mỗi thẻ giảm, và tỷ trọng thời gian mỗi bước bị chiếm bởi sự chờ do đồng bộ xuyên nhóm và mất cân bằng tải tăng tương ứng; thời gian mỗi bước thực tế vượt lý tưởng khoảng 0,4 s, và đây là khoản thời gian thừa cần phân tích thêm sau khi mở rộng. Theo thứ tự trong Mục 1.3.4, trước tiên gấp việc đồng bộ xuyên nhóm và mất cân bằng tải vào mô hình: càng nhiều thẻ, phần bước dành để chờ nhóm chậm nhất càng lớn, và đây là công việc vốn có của chính việc mở rộng; chỉ khoảng chênh còn lại mà điều này vẫn không giải thích được mới nên quy cho chi phí triển khai.
Giờ xét quy mô routing của một model thực. Qwen3-235B-A22B có expert, và mỗi token chọn ; 8.192 token tạo ra 65.536 dispatch tổng cộng, trung bình 512 hàng mỗi expert. Giả sử một nửa số expert nhận gấp 1,5 lần khối lượng dispatch trung bình, cùng tỷ lệ mất cân bằng 3:1 như ví dụ trước, với expert nóng ở 768 hàng mỗi cái và expert lạnh ở 256 hàng mỗi cái. Ở các giá trị là 1,0, 1,25, 1,5, 2,0, dung lượng mỗi expert là 512, 640, 768, 1.024 hàng; expert nóng lần lượt bị drop 256, 128, 0, 0 dispatch, cùng chiếm 25%, 12,5%, 0, 0 tổng số dispatch; hàng pad không chiếm 25%, 30%, 33%, 50% tổng số hàng được thực thi.
| Capacity factor | Dung lượng mỗi expert / hàng | Phần dispatch bị drop | Hàng pad không như phần khối lượng thực thi |
|---|---|---|---|
| 1.0 | 512 | 25% | 25% |
| 1.25 | 640 | 12.5% | 30% |
| 1.5 | 768 | 0 | 33% |
| 2.0 | 1,024 | 0 | 50% |
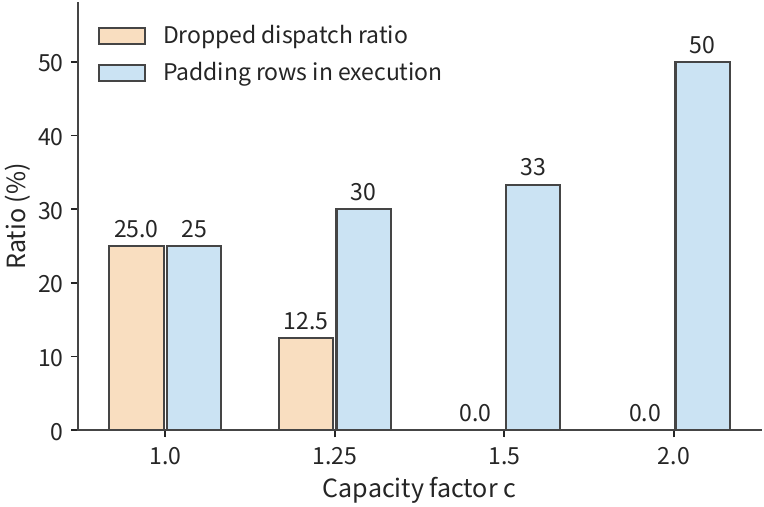
Điều kiện đảo chiều được quyết định bởi phân phối routing: phân phối ở trên cần để đưa tỷ lệ drop về không; routing càng cân bằng, cần thiết càng gần 1, và lãng phí pad không càng ít. Auxiliary loss (một hạng tử cân bằng tải được thêm vào mục tiêu training) trực tiếp phạt việc dispatch lệch; sơ đồ không-auxiliary-loss của DeepSeek-V3 điều chỉnh động độ chệch routing dựa trên tải của expert. Cả hai đều đẩy phân phối về cân bằng, cho phép capacity factor nhận giá trị nhỏ hơn. Công thức dung lượng expert trong Mục 2.4 giả định không có dispatch token nào bị drop trong lúc routing (), tương ứng trường hợp capacity factor đủ lớn để tỷ lệ drop bằng không.
Ngay cả sau khi cân bằng tính toán expert, truyền dữ liệu vẫn có thể để các thẻ chờ. Trao đổi token forward của MoE, truyền gradient đầu vào backward và giảm gradient tham số đều tranh cùng một liên kết, nên phân tích dòng thời gian truyền thông ở mục trước vẫn áp dụng. Lấy một gradient expert FP32 72 MiB, được giảm qua ring AllReduce bởi bốn thành viên data-parallel giữ expert đó; mỗi thẻ gửi MiB. Mỗi thẻ được trang bị một NIC 200 Gbit/s, 25 GB/s mỗi hướng, và mỗi lần gọi tập thể có chi phí khởi động khoảng 0,02 ms. Toàn bộ bucket mất khoảng 4,55 ms, không thể hoàn thành trong một cửa sổ rảnh 2 ms duy nhất. Nếu gradient được chia thành ba bucket con 24 MiB, mỗi bucket gửi 36 MiB, khoảng 1,53 ms, mỗi cái có thể hoàn thành trong một cửa sổ rảnh như vậy; tuy nhiên, tổng thời gian xử lý truyền thông tăng lên khoảng 4,59 ms. Dù phải khởi động thêm hai lần truyền thông, mỗi bucket nhỏ hoàn tất truyền trước khi tính toán kết thúc, nhờ đó giảm thời gian chờ sau tính toán. Chuyển sang NIC 400 Gbit/s, toàn bộ bucket mất khoảng 2,28 ms, vẫn không vừa vào khoảng trống 2 ms, nên việc chia bucket vẫn cần thiết.
Tải của expert phụ thuộc vào số dispatch token mà expert của mỗi thẻ nhận được. Ngữ cảnh dài giới thiệu một loại khác biệt khác: ngay cả với cùng tổng số token, số cặp attention phải tính có thể khác nhau.
Với cùng tổng số token, độ dài chuỗi không đều làm tăng tính toán attention như thế nào. Với một chuỗi nhân quả độ dài , token đầu tiên attend một token, token thứ hai attend hai token, v.v., cho cặp attention hiệu dụng. Hai chuỗi độ dài 4096 và 4096 cùng nhau cho khoảng 16,8 triệu cặp; đổi thành 7168 và 1024, với tổng số token vẫn là 8192, tăng số cặp lên khoảng 26,2 triệu, tăng khoảng 56%. Số cặp attention tăng gần như bậc hai theo độ dài chuỗi, nên chuỗi dài hơn làm tăng tổng lượng tính toán.
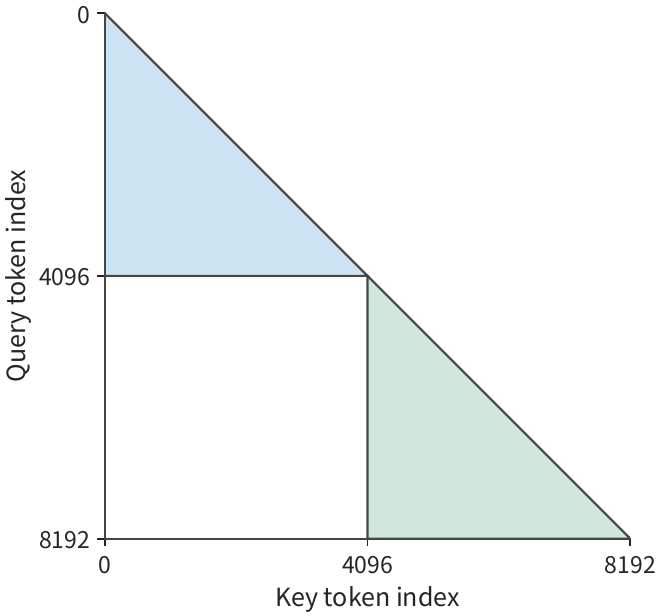
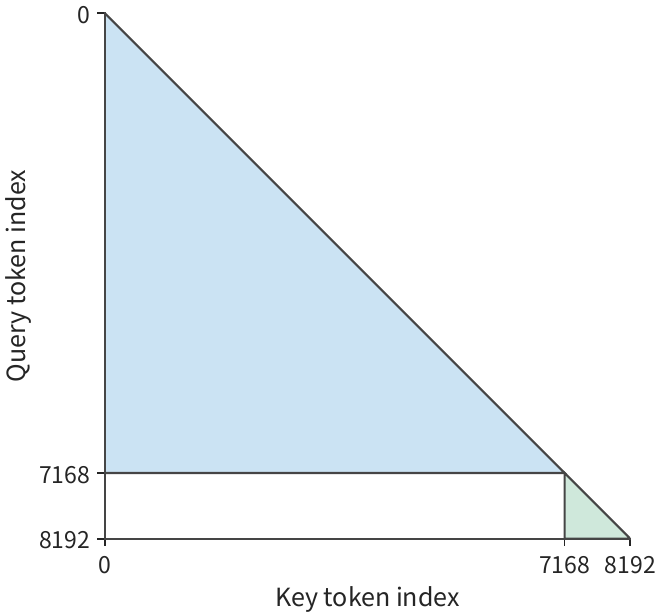
Trong Hình 10-29, diện tích thêm của tam giác dài hơn đến từ các quan hệ attention thực sự và không thể loại bỏ bằng cách bỏ token padding. Packing (ghép vài chuỗi ngắn nối tiếp nhau thành một chuỗi có độ dài mục tiêu) giảm token padding, còn việc gom nhóm theo độ dài đưa diện tích tam giác mà mỗi thẻ xử lý lại gần nhau hơn; context parallelism (song song ngữ cảnh) tiếp tục chia tính toán của các chuỗi dài cho nhiều thẻ, trao đổi K và V được giữ bởi các thẻ khác. Ba cách tiếp cận lần lượt thay đổi công việc lãng phí, phân bổ công việc và đường dữ liệu đến. Khi so sánh các sơ đồ có cùng tổng số token, giữ nguyên phân phối độ dài, mặt nạ nhìn thấy (visibility mask, quy định mỗi vị trí token có thể đọc những token ngữ cảnh nào) và trọng số loss sẽ tách lợi ích lập lịch khỏi những thay đổi trong chính nhiệm vụ.
10.4 Dữ liệu vào, checkpoint và phục hồi sự cố
Phân tích thời gian mỗi bước trong Mục 10.3 giả định dữ liệu vào đã được chuẩn bị sẵn và training không bị gián đoạn bởi sự cố. Trong vận hành liên tục, việc đọc và tiền xử lý dữ liệu phải theo kịp nhịp tính toán, và cũng phải có các checkpoint lưu trạng thái training có thể khôi phục. Mục này thêm cả hai yếu tố vào thời gian hoàn thành đã được giới thiệu ở đầu chương: dữ liệu vào quyết định các thẻ có thể tiếp tục làm việc liên tục hay không, và phục hồi quyết định bao nhiêu phần công việc đã hoàn thành phải làm lại.
10.4.1 Đọc dữ liệu, packing và nạp trước
Dữ liệu thô trải qua đọc, giải mã hoặc tokenization (token hóa) và lọc, rồi được ghép thành các chuỗi training có độ dài mục tiêu, đặt vào một buffer bộ nhớ host, và cuối cùng được truyền sang GPU. Buffer host thường dùng bộ nhớ cố định (pinned memory), giữ dữ liệu cư trú trong bộ nhớ vật lý trong lúc truyền bất đồng bộ. Tốc độ xử lý bền vững của mỗi giai đoạn quyết định tốc độ dữ liệu vào, và các hàng đợi làm êm các biến động tốc độ ngắn hạn.
Việc GPU cuối cùng nhận một khối lượng dữ liệu nhỏ không có nghĩa quá trình chuẩn bị trước đó nhanh tương đương. Ngân sách 25 ngày đòi hỏi khoảng 46.300 token/s, tức khoảng 5,7 chuỗi 8.192 token mỗi giây. Nếu ID token được truyền dưới dạng int64, 8 byte mỗi ID, tốc độ dữ liệu chỉ khoảng 0,37 MB/s. Giả sử mỗi tiến trình chuẩn bị dữ liệu CPU chuẩn bị hai chuỗi mỗi giây; hai tiến trình chuẩn bị dữ liệu chỉ cho bốn chuỗi/s, dưới yêu cầu; ba tiến trình đạt sáu chuỗi/s. Dù khối lượng dữ liệu truyền nhỏ, tiến trình chuẩn bị trên CPU vẫn có thể làm chậm toàn bộ cluster.
Tình huống thiết kế trong chương này phân bổ bốn tiến trình chuẩn bị dữ liệu như vậy cho dữ liệu vào, tổng cộng tám chuỗi/s. Ở 48 thẻ, thời gian mỗi bước khi dữ liệu vào sẵn sàng khoảng 52,3 s, xử lý 384 chuỗi mỗi bước, đòi hỏi khoảng 7,3 chuỗi/s, thấp hơn tám chuỗi/s. Chuẩn bị dữ liệu chạy nhanh hơn training tiêu thụ, nên sau một đợt chậm ngắn hàng đợi nạp trước có thể được nạp lại đầy. Tình huống thiết kế còn cho phép trung bình 0,5 s chờ dữ liệu vào mỗi bước để biểu thị phần chờ mà nạp trước không loại bỏ được, thay đổi thời gian training mỗi bước ở 32 và 48 thẻ thành khoảng 78,9 s và 52,8 s.
Hàng đợi nạp trước cho phép chuẩn bị dữ liệu và tính toán GPU chạy ở các nhịp khác nhau. Trong lúc training bình thường, dữ liệu chuẩn bị trước có thể làm giảm lần chờ do biến động tốc độ dữ liệu vào; tuy nhiên, khi lưu checkpoint, thiết yếu phải phân biệt dữ liệu nào đã được dùng cho training. Giả sử data loader đã giao nhiệm vụ chuẩn bị cho 108 batch đầu tiên, trong khi training mới hoàn thành batch 100; batch 101–108 vẫn đang được xử lý hoặc đang chờ trong hàng đợi. Nếu phục hồi tiếp tục trực tiếp từ batch 109, tám batch sẽ bị bỏ qua. Vị trí batch đã được giao cho các tiến trình chuẩn bị dữ liệu phản ánh tiến độ nạp trước, còn vị trí batch đã được dùng trong training phản ánh tiến độ training; buffer giữa hai vị trí chứa dữ liệu chưa được huấn luyện.
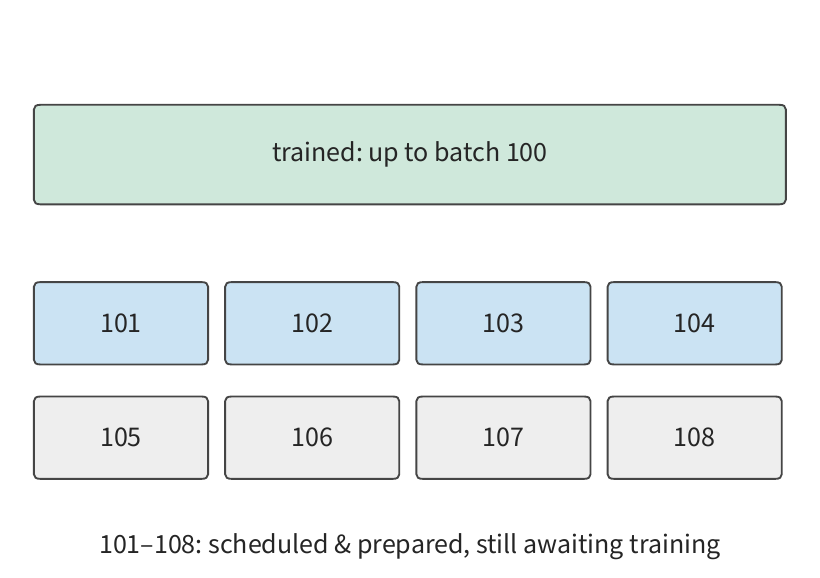
Hàng đợi trong Hình 10-30 chỉ có thể bù tạm thời cho sự chậm lại của tốc độ chuẩn bị; nếu chuẩn bị dữ liệu chậm kéo dài, hàng đợi cuối cùng sẽ cạn. Việc ghi checkpoint chịu cùng một ràng buộc: một khi tốc độ trung bình sinh ra snapshot vượt quá tốc độ lưu trữ có thể tiếp nhận bền vững, khoản tồn đọng các lần ghi chờ sẽ cứ tăng, và buffer tạm hữu hạn cuối cùng sẽ bị đầy; Mục 10.4.4 tính loại tồn đọng này bằng các tốc độ ghi cụ thể. Với nhiệm vụ văn bản trong chương này, phía dữ liệu vào liên quan khối lượng byte nhỏ, với nút thắt nằm ở phần chuẩn bị dữ liệu phía CPU; lưu lượng ghi trung bình của checkpoint cũng không lớn: tình huống thiết kế dùng khoảng lưu 1800 s, và checkpoint khoảng 115 GB trung bình chỉ khoảng 64 MB/s. Phần chậm do lưu được hạch toán riêng trong Mục 10.4.4.
10.4.2 Trạng thái có thể khôi phục và biến đổi bố cục
Giả sử training vừa hoàn tất một lần cập nhật tham số, và máy dừng lại ở điểm đó. Để tiếp tục training sau khi khôi phục, người ta cần biết weight tại thời điểm đó, batch dữ liệu tiếp theo cần đọc là gì, và optimizer đã tích lũy lịch sử gì. Chỉ riêng weight đủ để chạy suy luận forward, nhưng chưa đủ để xác định lần cập nhật training tiếp theo. Một training checkpoint vì thế phải lưu tất cả trạng thái cần thiết tương ứng với cùng một điểm trong training, để training có thể tiếp tục sau khi khôi phục.
Training với Adam, như dùng trong chương này, đòi hỏi lưu weight, moment thứ nhất và thứ hai, số bước, trạng thái learning rate, trạng thái ngẫu nhiên (random state) và thành phần của batch dữ liệu tiếp theo. Learning rate điều khiển kích thước bước cập nhật, và trạng thái ngẫu nhiên quyết định trình tự của việc lấy mẫu ngẫu nhiên về sau. Với cùng weight nhưng trạng thái moment optimizer khác, lần cập nhật tham số tiếp theo có thể khác; với cùng vị trí đọc dữ liệu nhưng token thừa khác nhau từ packing, chuỗi training tiếp theo cũng sẽ thay đổi. Điều mà recomputation activation trong Mục 10.2.2 xử lý là những giá trị trung gian nào trong một forward-backward pass duy nhất có thể được dựng lại; điều mà một checkpoint phải xử lý là toàn bộ quá trình training tiếp tục ra sao sau một sự gián đoạn.
Sau khi một vòng lặp training kết thúc, batch gradient tiếp theo được tái sinh bởi backward pass. Lúc này, trạng thái được lưu gồm weight ở 2 byte, weight master ở 4 byte, và hai trạng thái Adam ở 8 byte, tổng 14 byte mỗi tham số. Phần này của checkpoint Qwen3-8B khoảng 115 GB. Lưu trạng thái model cùng với vị trí dữ liệu đã xử lý, ở cuối một vòng lặp training, xác định tham số nào sẽ được dùng sau khi khôi phục và training tiếp tục từ batch nào.
Phục hồi cũng có thể đòi hỏi thay đổi bố cục song song hóa, khiến cùng một trạng thái phải được shard lại. Ví dụ: một checkpoint được shard lại từ tensor parallelism bốn chiều sang tám chiều như thế nào? Weight của phép chiếu cổng có hình dạng , 96 MiB ở BF16. Chia bốn lần dọc theo chiều đầu ra, mỗi mảnh có 3072 hàng, 24 MiB; chia tám lần, mỗi mảnh có 1536 hàng, 12 MiB. Thẻ đích có rank đọc mảnh cũ , với rank chẵn lấy nửa trước và rank lẻ lấy nửa sau. Tọa độ hàng toàn cục nối bố cục cũ và mới.
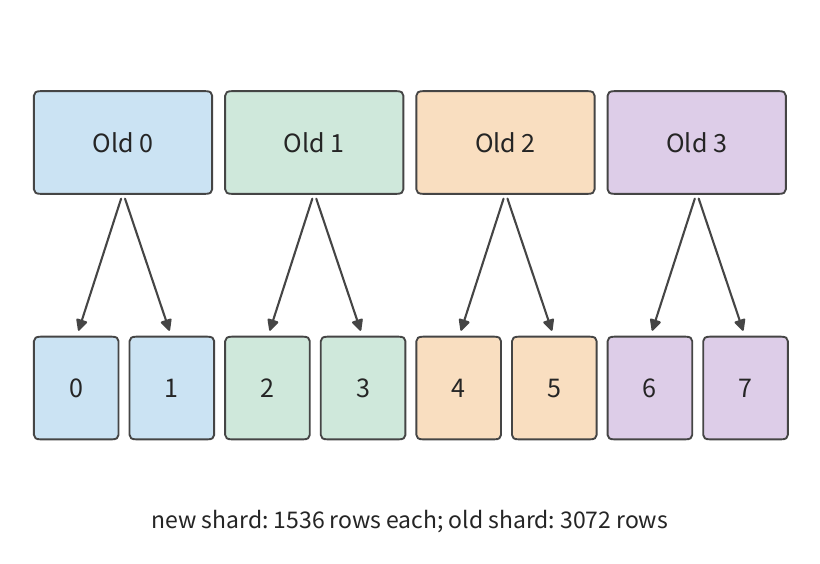
Theo các mũi tên trong Hình 10-31, chương trình phục hồi có thể tìm phạm vi hàng gốc tương ứng với mỗi mảnh mới. Weight master FP32 và hai trạng thái Adam cũng được chia theo cùng phạm vi hàng, mỗi cái lớn gấp đôi weight BF16. Tổng trạng thái của ma trận này trong checkpoint vì vậy là MiB. Các hệ thống như ByteCheckpoint mô tả các tensor này bằng hình dạng toàn cục, độ lệch (offset) và độ dài mảnh, cho phép chương trình phục hồi đọc đúng phạm vi cần thiết theo bố cục đích. Shard file là một cách sắp xếp lưu trữ, còn tọa độ toàn cục cho biết một mảnh thuộc tensor nào và chiếm những hàng, cột nào.
Weight có thể được lắp ráp lại dùng số hàng của ma trận gốc, nhưng các chuỗi training cũng cần đủ thông tin được giữ lại để dựng lại cùng một dữ liệu vào. Dữ liệu trong Hình 10-30 đã được chuẩn bị nhưng chưa được dùng trong training cũng cần được định vị lại chính xác lúc phục hồi. Ngoài vị trí batch, các kết quả trung gian của tiền xử lý dữ liệu cũng phải được giữ lại.
Nếu packer giữ 2.000 token, và batch dữ liệu tiếp theo cung cấp 6.192, hai phần cùng nhau tạo thành chuỗi 8.192 token tiếp theo. Nếu 2.000 token này bị mất, phải lấy thêm token từ dữ liệu phía sau để lấp đầy chuỗi tiếp theo, từ đó thay đổi tiền tố, quan hệ attention và nhãn của nó. Lưu cùng lúc vị trí dữ liệu đã dùng cho training, các token chưa tạo thành một chuỗi hoàn chỉnh và kết quả cập nhật tham số cho phép dựng lại cùng một batch dữ liệu sau khi khôi phục.
10.4.3 Lưu đồng bộ, lưu bất đồng bộ và tranh chấp băng thông
Mục này bàn về cách quá trình lưu tiến hành song song với training, và khi nào một snapshot thực sự trở nên dùng được.
Lưu đồng bộ trước tiên tạo ra một snapshot có nội dung cố định, và training chỉ tiếp tục sau khi việc ghi hoàn tất. Lưu bất đồng bộ sao chép snapshot sang một buffer bộ nhớ độc lập, rồi để một tiến trình nền ghi nó ra, cho phép training tiếp tục thực thi sớm hơn. Khi training tiếp tục thực thi, snapshot có thể chưa được ghi đầy đủ; chỉ khi việc ghi hoàn tất và được commit, snapshot này mới có thể được dùng cho phục hồi sự cố.
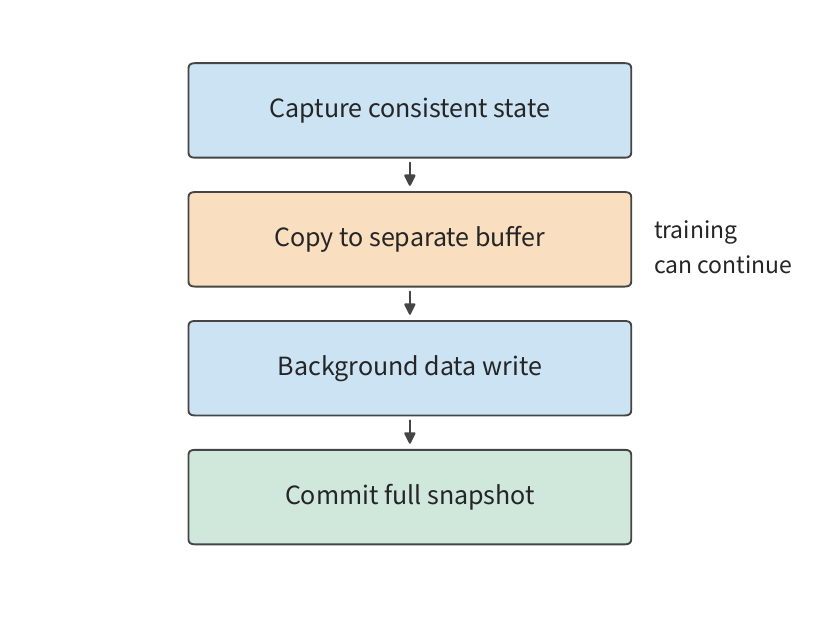
Ví dụ: tốc độ tải lên checkpoint quyết định lượng công việc làm lại sau sự cố như thế nào? Lấy các snapshot 112 GB mỗi cái. Kiến trúc tham chiếu DGX SuperPOD đưa ra các bậc hiệu năng lưu trữ theo khối lượng công việc; training NLP tương ứng với bậc Good, trong đó một SU (một đơn vị mở rộng gồm 32 hệ thống DGX) có thông lượng ghi lưu trữ gộp 7 GB/s; ở tốc độ này, ghi một snapshot mất 16 s. Tạo ra một snapshot mỗi 10 s cho tốc độ sản xuất dữ liệu 11,2 GB/s, và hàng đợi cứ tăng. Đổi sang một snapshot mỗi 20 s hạ nhu cầu trung bình xuống 5,6 GB/s, để lưu trữ hoàn tất việc ghi snapshot trước đó trước khi snapshot kế tiếp đến.
Chụp hai snapshot ở giây thứ 20 và 40, mỗi cái mất 0,5 s để sao chép sang buffer trước khi tải lên, hoàn thành ở 36,5 và 56,5 s. Nếu sự cố xảy ra ở giây thứ 50, snapshot thứ hai vẫn đang tải lên, nên phục hồi chỉ có thể quay về giây thứ 20, làm lại 30 s. Chuyển sang thông lượng ghi gộp 20 GB/s của bậc Better, mỗi snapshot chỉ mất 5,6 s, hoàn thành lần lượt ở 26,1 và 46,1 s; cùng sự cố có thể khôi phục về giây thứ 40, chỉ làm lại 10 s.
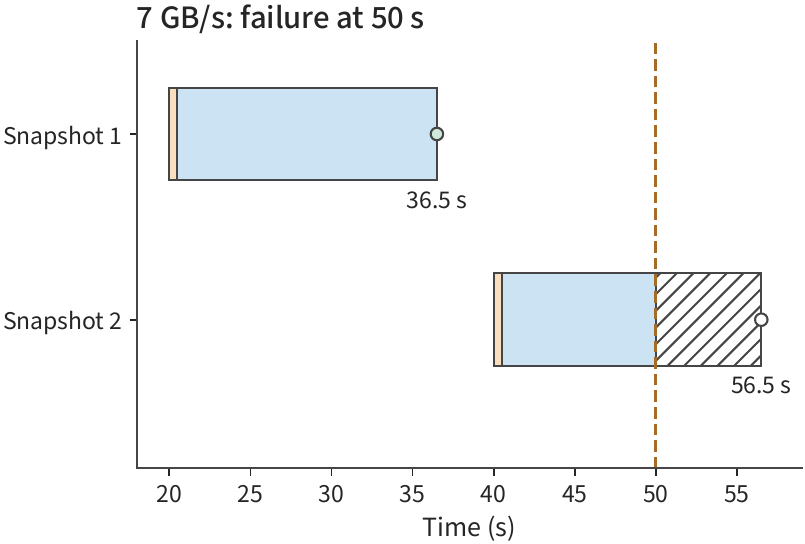
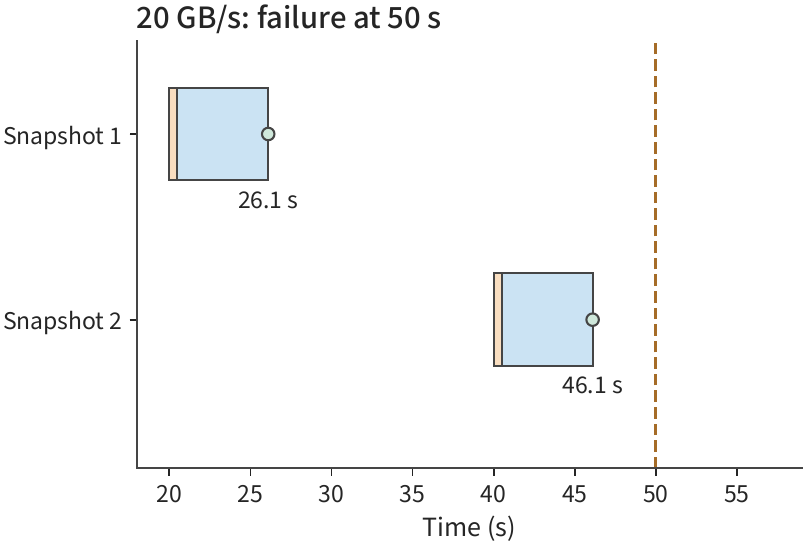
Cả hai sơ đồ đều có cùng mức tạm dừng tiền cảnh: hai lần tạm dừng 0,5 s mỗi lần, tổng 1 s. Ghi nhanh hơn cho phép phục hồi chạm một trạng thái training gần sự cố hơn, làm lại ít hơn 20 s. Điểm commit của lần lưu bất đồng bộ vì thế ảnh hưởng trực tiếp đến tiến độ dài hạn: tốc độ ghi nền ảnh hưởng lượng công việc làm lại sau sự cố, còn thời lượng tạm dừng trong lúc lưu kéo dài thời gian chạy bình thường.
Ngoài việc ghi các file dữ liệu, các hệ thống thực còn cần commit siêu dữ liệu mô tả snapshot hoàn chỉnh. Trong một bộ thí nghiệm CPU, lời gọi API lưu trả về trong khoảng 7 ms, trong khi siêu dữ liệu phục hồi mất khoảng 48 ms để commit; nếu tiến trình kết thúc trước lúc commit, chương trình phục hồi chọn checkpoint hoàn chỉnh cuối cùng. Các file dữ liệu và bản ghi commit cùng nhau tạo thành một snapshot dùng được, và chương trình phục hồi dùng điều đó để xác định checkpoint nào đã được lưu trọn vẹn.
10.4.4 Phạm vi sự cố, chu kỳ lưu và tiến độ training hiệu dụng
Hình 10-33 cố định thời điểm của hai lần lưu và so sánh tác động của tốc độ ghi. Khoảng cách giữa các lần lưu cũng có thể được thay đổi: khoảng cách ngắn giữ sự cố gần snapshot cuối hơn; khoảng cách dài nghĩa là ít lần tạm dừng để lưu trong lúc training bình thường. Hai chi phí này chuyển động ngược chiều nhau, nên tồn tại một điểm đánh đổi.
Gọi là thời gian mỗi lần lưu đồng bộ, là số giây training hữu ích hoàn thành giữa các lần lưu, là tỷ lệ sự cố của công việc, và là thời gian phục hồi. Giả định sự cố xảy ra hiếm và độc lập, mô hình bậc nhất cho chi phí thêm trên mỗi đơn vị thời gian training hữu ích là
Hạng tử đầu đến từ việc lưu một lần mỗi giây. Một sự cố có thể rơi vào bất kỳ điểm nào giữa hai lần lưu, trung bình mất nửa khoảng cách, cho hạng tử thứ hai. Hạng tử thứ ba là số lần phục hồi dự kiến trên mỗi đơn vị thời gian training hữu ích nhân với thời gian phục hồi mỗi lần. Hai hạng tử đầu lần lượt giảm và tăng, và điểm tối ưu thỏa mãn
Ví dụ: số thẻ và tỷ lệ sự cố quyết định chu kỳ lưu checkpoint như thế nào? Số liệu của Meta trên các công việc training của một cluster nghiên cứu cho thấy một công việc 1024 thẻ bị gián đoạn trung bình mỗi 7,9 giờ một lần, và tỷ lệ gián đoạn tỷ lệ thuận với số thẻ, tương đương khoảng một sự cố mỗi thẻ mỗi 337 ngày. Bất kỳ sự cố thẻ đơn lẻ nào cũng làm gián đoạn toàn bộ công việc. Một checkpoint khoảng 115 GB được lưu ở 7 GB/s cho s. Giả định phục hồi mất 120 s, thay vào cho chu kỳ tối ưu khoảng 965 s, tức khoảng 16 phút.
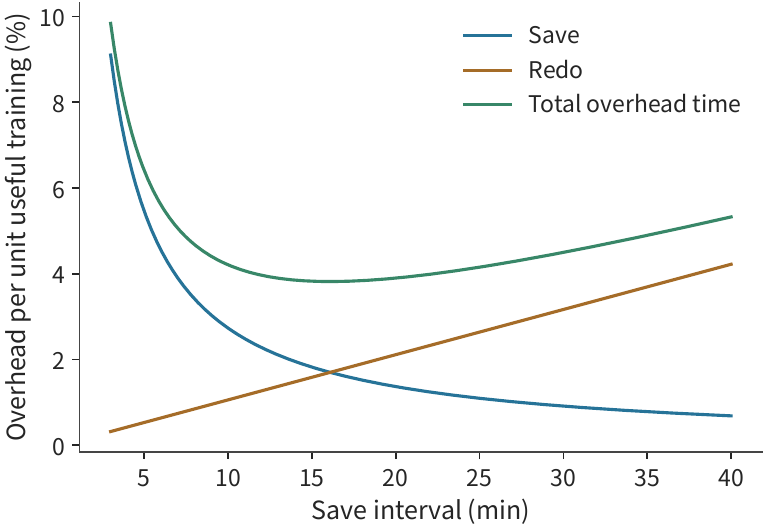
Điểm tối thiểu trong Hình 10-35 khá bằng phẳng, nên có thể chọn một khoảng cách thuận tiện gần đó trong cấu hình. Bảng dưới so sánh năm, mười lăm và ba mươi phút, cho thấy chi phí nào tăng khi khoảng cách rời xa điểm tối thiểu.
| Khoảng training hữu ích | Chi phí lưu | Chi phí làm lại | Chi phí phục hồi | Tổng |
|---|---|---|---|---|
| 300 s | 5.5% | 0.5% | 0.4% | 6.4% |
| 900 s | 1.8% | 1.6% | 0.4% | 3.8% |
| 1800 s | 0.9% | 3.2% | 0.4% | 4.5% |
Kéo dài chu kỳ lưu từ năm phút lên mười lăm phút tiết kiệm nhiều thời gian lưu hơn thời gian làm lại phải thêm; kéo tiếp lên ba mươi phút, thời gian làm lại thêm vượt quá thời gian lưu tiết kiệm được. Các tổng trong bảng được tính từ các giá trị chưa làm tròn. Nhân đôi số thẻ nhân đôi tỷ lệ sự cố, rút ngắn chu kỳ tối ưu xuống giá trị ban đầu; nhân đôi tốc độ lưu rút ngắn chu kỳ tối ưu cùng một thừa số, vì mỗi lần lưu tốn ít thời gian hơn.
Tình huống thiết kế trong chương này dùng ít thẻ hơn, theo giả định khoảng một sự cố mỗi thẻ mỗi 337 ngày (thời gian trung bình giữa các sự cố mỗi thẻ, MTBF), thời gian phục hồi 120 s và thời gian lưu khoảng 16,4 s, lấy khoảng training hữu ích 1800 s. Với 32 thẻ, chi phí gộp lưu, làm lại và phục hồi cộng thêm khoảng 1,02% thời gian; với 48 thẻ, khoảng 1,08%. Sơ đồ 48 thẻ có xác suất bị sự cố thẻ gián đoạn cao hơn, nhưng phần thêm chỉ khoảng 0,06 điểm phần trăm, nhỏ hơn nhiều so với lợi ích từ việc rút ngắn thời gian tính toán của một thẻ. Dung lượng, thời gian training mỗi bước và chi phí thêm dài hạn giờ đã đủ; Mục 10.6 sẽ gộp chúng thành thời gian hoàn thành.
10.4.5 Straggler và node chậm
Mô hình ở mục trước coi sự cố là một sự kiện gián đoạn công việc. Còn có một loại suy giảm xảy ra thường xuyên hơn nhưng không gián đoạn công việc: một thẻ tính toán chậm trong một bước nhất định. Trong data parallelism đồng bộ, mỗi bước phải chờ thẻ chậm nhất hoàn thành; thẻ làm chậm cả bước được gọi là straggler (thẻ chậm), nên thời gian bước được quyết định bởi cực đại trên các thẻ chứ không phải trung bình. Gọi thời gian tính toán mỗi thẻ là i.i.d. với trung bình và độ lệch chuẩn ; với thẻ, phần tính toán của thời gian bước là cực đại của mẫu. Lấy s (thời gian tính toán mỗi thẻ của sơ đồ 48 thẻ) cộng 0,58 s truyền thông và chờ dữ liệu vào mỗi bước, ta lấy lần lượt là 2% trung bình (1,04 s) và 5% (2,61 s).
Cực đại dự kiến của mẫu chuẩn độc lập bằng cộng một số bội của : với , các bội lần lượt khoảng 1,42, 2,23 và 3,25. Thay vào cho thời gian mỗi bước dự kiến:
| Thẻ | (bội của ) | Mỗi bước, / s | Mỗi bước, / s |
|---|---|---|---|
| 8 | 1.42 | 54.3 | 56.5 |
| 48 | 2.23 | 55.1 | 58.6 |
| 1024 | 3.25 | 56.2 | 61.3 |
Không có biến động, mỗi bước mất khoảng s. Càng nhiều thẻ, cực đại dự kiến càng lớn: với 48 thẻ và , mỗi bước mất thêm khoảng 5,8 s, tiêu thụ hai phần năm biên dư khoảng 14,4 s từ Mục 10.6; với 1024 thẻ, thêm khoảng 8,5 s. Thẻ chậm có thể được phát hiện từ thời gian chờ truyền thông: thời gian chờ của mỗi thẻ trên AllReduce bucket gradient bằng thời điểm kết thúc của bước trừ thời điểm kết thúc tính toán của chính nó; với một thẻ có thời gian tính toán đúng bằng trung bình, kỳ vọng của lần chờ này chính xác là .
Một khi phát hiện thẻ chậm, có ba cách ứng phó: chờ, phân bổ lại và loại bỏ. Chờ: bước hiện tại kết thúc theo thời gian của thẻ chậm. Một thẻ chậm xuống khiến phần còn lại chờ thêm bao nhiêu phụ thuộc vào cực đại của thẻ còn lại vốn đã lớn cỡ nào: ở , 8 thẻ chờ thêm khoảng (1,72 s), 48 thẻ chờ thêm khoảng (0,81 s), và ở 1024 thẻ cực đại của các thẻ còn lại đã vượt , nên lần chờ thêm bằng không. Phân bổ lại: công việc của thẻ chậm được trải đều lên thẻ còn lại, làm trung bình thành . Vẫn lấy và bỏ qua chi phí di trú, 48 thẻ cho khoảng 56,2 s mỗi bước, và 8 thẻ tăng lên khoảng 61,6 s, cả hai đều cao hơn thời gian bước dự kiến khi chờ ở cùng (55,1 s và 54,3 s): trải tải làm mỗi thẻ làm thêm công việc, và mức tăng này vượt quá lần chờ do một thẻ chậm gây ra, với khoảng cách lớn hơn khi ít thẻ hơn. Loại bỏ: thẻ chậm bị loại khỏi công việc, và công việc khởi động lại từ checkpoint cuối, với chi phí là công việc mất dự kiến cộng thời gian phục hồi . Lấy chu kỳ lưu ngắn hơn 1800 s của tình huống thiết kế, s, với s, cho chi phí 420 s, tức khoảng tám bước ở 52,8 s mỗi bước của sơ đồ 48 thẻ. Một lần chập chờn chỉ tốn vài giây, nên loại bỏ chỉ đáng khi một thẻ chậm kéo dài nhiều bước. Các cluster thực có thẻ chậm: MegaScale báo cáo khoảng 0,5% máy chậm rõ rệt; số liệu cluster Meta trong Mục 10.4.4 cho quan hệ giữa quy mô công việc và sự gián đoạn — công việc 1024 thẻ có thời gian trung bình giữa các sự cố 7,9 giờ, còn công việc 8 thẻ có 47,7 ngày.
Ngoài sự cố phần cứng, còn một loại sự kiện khác đòi hỏi quay lui checkpoint: loss spike (gai loss, nhọn loss) từ Mục 10.1.2. Loss spike không làm hỏng phần cứng, nhưng được xử lý theo cùng cách — loại bỏ các tham số hiện tại và trở về snapshot cuối — và nó ảnh hưởng đến chu kỳ lưu giống như một sự cố phần cứng. Coi việc quay lui do loss spike là một cú sốc tác động đồng thời lên toàn bộ công việc, xảy ra trung bình mỗi một lần, mô hình bậc nhất ở mục trước được hiệu chỉnh thành
Dùng tỷ lệ sự cố phần cứng của 48 thẻ (MTBF mỗi thẻ khoảng 337 ngày), và giả định loss spike gây quay lui trung bình mỗi bảy ngày một lần: vẫn ở s, phần thêm tăng từ 2,80% lên 2,87%, và chu kỳ lưu tối ưu thu nhỏ từ khoảng 4.458 s xuống khoảng 3.150 s. Ở chu kỳ 1800 s của tình huống thiết kế, phần thêm thay đổi từ 1,08% lên khoảng 1,25%, tăng thời gian hoàn thành khoảng 0,03 ngày, không thay đổi lựa chọn sơ đồ trong Mục 10.6. Điều kiện đảo chiều được cho bởi độ lớn tương đối của hai tỷ lệ: spike càng thường xuyên, chu kỳ tối ưu càng ngắn; khi , chu kỳ lưu gần như hoàn toàn do độ ổn định số học quyết định; khi khoảng quay lui vào bậc tháng, nó gần như không ảnh hưởng đến phần thêm 1,08%.
10.5 Training với Reinforcement Learning (học tăng cường)
Bốn mục trước giả định dữ liệu training đã được cho sẵn. RL cho phép model tham gia sản xuất batch dữ liệu tiếp theo: model sinh các trajectory (quỹ đạo), hệ thống tính reward (phần thưởng) hoặc kết quả xác minh, các trajectory sau đó được dùng cho training, và weight được cập nhật lại làm thay đổi lượt generation tiếp theo. Hệ thống thay đổi từ một pipeline training xử lý dữ liệu cố định thành một vòng phản hồi, và các vấn đề mới tập trung vào tốc độ xử lý của từng giai đoạn, sự chồng lấp trạng thái trong các lần chuyển đổi, và chính xác phiên bản policy nào đã sinh ra một mẫu nhất định. Phía inference sinh trajectory và phía training tính loss cũng phải cho ra các xác suất có thể đối chiếu cho cùng một trajectory — đây là training-serving consistency (tính nhất quán training–phục vụ) của mục này. Training-serving consistency ảnh hưởng trực tiếp đến việc các cập nhật tham số có theo đúng kỳ vọng của thuật toán hay không, và ràng buộc lợi ích của tăng tốc giai đoạn cũng như thực thi bất đồng bộ.
10.5.1 Một vòng sinh phản hồi, xác minh và cập nhật tham số
Quá trình hoàn thành một vòng của vòng phản hồi như sau. Bắt đầu từ bốn prompt, sinh hai phản hồi mỗi câu hỏi, cho tám trajectory. Reward mô tả kết quả của các phản hồi này, và advantage đo mức phản hồi tốt hơn đường cơ sở được chọn, được dùng để xác định hướng và độ lớn của việc điều chỉnh xác suất phản hồi. Phía training dựng loss trên các token hiệu dụng và hoàn tất một lần cập nhật tham số. Một khi weight mới được trao cho phía generation, lượt mẫu tiếp theo đến từ policy đã cập nhật. Generation, reward và learning mỗi phía dùng các dạng dữ liệu khác nhau, và định danh mẫu nối cả ba với nhau.
Nguồn dữ liệu ở đây khác với tập dữ liệu cố định thường dùng trong SFT. SFT dự đoán token tiếp theo trên một tiền tố thực tế, tức dùng teacher forcing; nhưng khi triển khai, model tiếp tục phản hồi dựa trên tiền tố do chính nó sinh ra. Một khi một đoạn sinh sớm sai, phần sinh sau có thể đi vào các ngữ cảnh ít được dữ liệu training bao phủ, và lỗi tích lũy khi quá trình sinh tiến triển. Sự lệch phân phối này giữa tiền tố training và tiền tố lúc dùng là một hạn chế của SFT dữ liệu cố định. Gradient vẫn tương ứng chính xác với loss hiện tại, nhưng các tình huống được bao phủ trong training khác với những tình huống model thực sự gặp phải.
Để xử lý sự lệch phân phối tiền tố này, OPD để model học sinh (student) hiện tại tự sinh trajectory của chính nó, và một giáo viên (teacher) sau đó cung cấp sự giám sát cho các tiền tố mà học sinh thực sự sinh ra, ví dụ phân phối xác suất token tiếp theo. Học sinh nhờ đó có thể học tại những vị trí nó hay sai, giảm lệch phân phối tiền tố; phản hồi theo token của giáo viên cũng cho tín hiệu học tinh hơn một reward đầu cuối đơn lẻ. DeepSeek V4 dùng OPD đa giáo viên để gộp năng lực của các expert theo miền vào một model thống nhất, và Chương 3 đã liệt kê forward pass của giáo viên như một khối lượng tính toán độc lập.
So với SFT dữ liệu cố định, lợi thế tiềm năng của OPD là số mẫu học hoặc số lần cập nhật cần để đạt một năng lực mục tiêu có thể giảm bớt. Nó đồng thời tăng chi phí sinh online của học sinh, forward pass của giáo viên và đồng bộ weight, và việc nó có giảm tổng GPU-hours hay thời gian hoàn thành hay không vẫn cần được đo bằng thực nghiệm. SFT mô tả một mục tiêu có giám sát, còn offline mô tả dữ liệu có được cố định trước hay không; cũng có thể thu thập dữ liệu online rồi dùng một loss có giám sát. Online nghĩa là dữ liệu được sản xuất liên tục khi training tiến hành, còn on-policy thêm yêu cầu phân phối lấy mẫu phải khớp với policy đang được tối ưu. RL online bất đồng bộ có thể dùng một policy trễ (lagged policy), và OPD cũng gặp sự khác biệt tính toán giữa engine generation và engine training. Vì vậy, lấy mẫu online được dùng để làm giảm lệch phân phối dữ liệu, trong khi training-serving consistency còn đòi hỏi căn chỉnh các quy trình tính toán ở phía generation và phía training.
Quay lại tám trajectory từ vòng đầu của mục này, xét cách phía training dựng loss trên các token hiệu dụng. Ví dụ tám phản hồi từ Mục 10.3.1 đến từ độ dài phản hồi trong một thí nghiệm model nhỏ: các phản hồi chứa tổng cộng 20 token hiệu dụng, gồm cả token EOS đánh dấu kết thúc chuỗi; phần vào đóng góp 366 token hiệu dụng cho tính toán. Cả prompt lẫn phản hồi đều tham gia tính toán forward, trong khi loss được chuẩn hóa trên các token phản hồi được chọn. Độ dài sinh vì vậy ảnh hưởng chi phí tính toán; loss mask cho biết mỗi token có tính vào loss hay không, quyết định token nào tham gia tính gradient. Hai vai trò là khác nhau.
Ngoài loss, reward tương đối trong cùng một prompt cũng quyết định advantage. Ví dụ, nếu hai phản hồi cùng nhận reward 1, trừ trung bình nhóm cho ra không cho cả hai; nếu reward trở thành 1 và 0, việc lấy trung tâm (centering) cho ra 0,5 và −0,5, và chỉ khi đó policy mới có một hướng để phân biệt hai phản hồi. Ngay cả sau khi hệ thống hoàn tất forward pass, backward pass và lời gọi optimizer, nó vẫn có thể gặp một batch trong đó loại tình huống thứ nhất — mọi advantage bằng không — xảy ra. Khi đo thông lượng training, nên đếm số trajectory hoặc token thực tế được dùng cho training mỗi giây; việc năng lực model có cải thiện hay không nên được kiểm tra bằng các nhiệm vụ đánh giá cố định.
Tình huống: tham số đã thay đổi, vì sao năng lực model không cải thiện? Trong một thí nghiệm model nhỏ cố định chạy phối hợp giữa framework training RL verl và inference engine vLLM: một reward khớp chính xác (exact-match) trên các bài toán số học cho reward giống nhau với các phản hồi trong cùng nhóm, nên advantage và policy gradient đều bằng không, và thay đổi tham số duy nhất đến từ weight decay của AdamW. Ngoài bước cập nhật gradient của Adam, AdamW còn thu nhỏ riêng các weight bằng một thừa số tỷ lệ; ngay cả khi policy gradient hiện tại bằng không, bước này vẫn thay đổi tham số. Đổi sang một reward dấu cố định, cả hai bước training đều cho gradient và cập nhật weight khác không, nhưng xác minh số học chỉ đúng 2/4. Cách xây dựng reward quyết định hướng học; thực thi hệ thống chịu trách nhiệm áp dụng nhất quán hướng đó lên các tham số.
10.5.2 Phân bổ tài nguyên và đồng bộ weight giữa các giai đoạn
Giờ đã hiểu mẫu trở thành gradient như thế nào, ta có thể bàn mỗi giây huấn luyện được bao nhiêu mẫu. Giai đoạn phản hồi của RL có thể thực thi xác minh dựa trên quy tắc hoặc một reward model (model chấm điểm phản hồi), còn OPD đòi hỏi một giáo viên cung cấp sự giám sát; cả hai nên phân bổ tài nguyên theo thông lượng thực tế của công việc phản hồi. Generation, verification và learning giống như ba giai đoạn kế tiếp của một quy trình: giai đoạn trước chạy nhanh hơn chỉ tăng đầu ra cuối cùng nếu giai đoạn sau có thể hấp thụ được nó. Trước tiên chuyển thông lượng của ba giai đoạn về cùng một đơn vị công việc. Gọi lần lượt là thông lượng của ba giai đoạn, và gọi là tỷ lệ vượt qua xác minh và thỏa mãn yêu cầu phiên bản policy; dưới thực thi pipeline ổn định trên các tài nguyên độc lập, cận trên số mẫu dùng được cho training mỗi giây là
Ví dụ: trong ba giai đoạn generation, verification và learning của RL, nên mở rộng giai đoạn nào trước? Generation cung cấp 12 trajectory cùng độ dài mỗi giây, verification xử lý sáu, và giai đoạn learning xử lý tám; một phần tư trajectory đã xác minh bị loại vì quá lệch phiên bản policy. Chỉ trajectory mỗi giây đi vào learning. Nhân đôi generation lên 24/s, nút thắt verification vẫn giới hạn mẫu đi vào learning ở 4,5/s; nhân đôi verification lên 12/s, số trajectory có thể gửi cho training đạt chín mỗi giây, lúc đó phía training chỉ xử lý được tám mỗi giây, trở thành nút thắt của cả pipeline. Vì vậy, tài nguyên mới nên được phân bổ cho giai đoạn hiện đang chậm nhất; sau khi giai đoạn đó tăng tốc, nút thắt nên được đánh giá lại để xem nó đã dịch chuyển tới đâu.
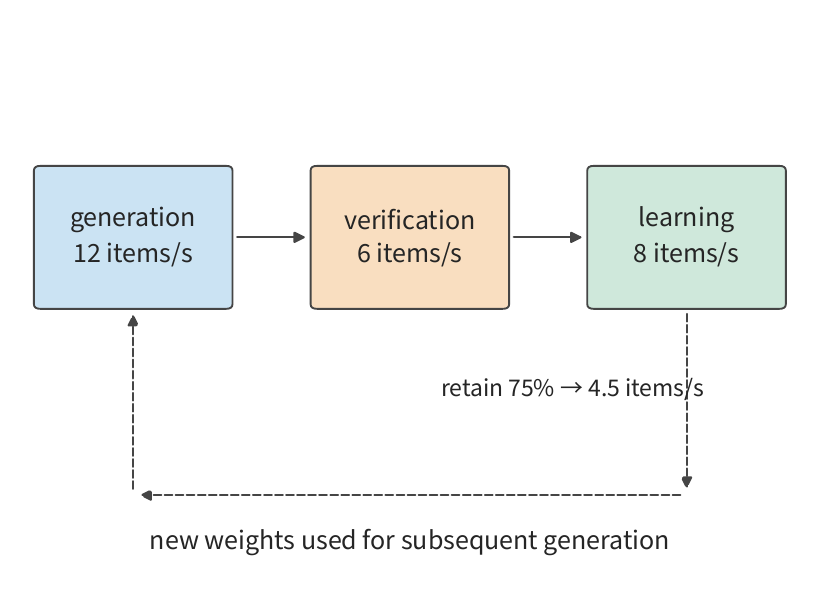
Hình 10-36 trước tiên vẽ ba giai đoạn trên các tài nguyên độc lập. Chuyển sang cùng một nhóm thẻ chạy lần lượt từng giai đoạn sẽ giảm số thẻ cần, nhưng generation và learning sẽ phải chuyển toàn bộ bộ dữ liệu trong bộ nhớ GPU giữa chúng.
Accelerator dùng chung cho phép cùng một nhóm thẻ luân phiên giữa training và generation, tiết kiệm tài nguyên trùng lặp; triển khai độc lập cho phép cả hai phía chạy độc lập, giành cơ hội chồng lấp, nhưng đòi hỏi gửi weight giữa hai nhóm thẻ. Chi phí chính của accelerator dùng chung nằm ở lúc chuyển đổi: trạng thái cũ chưa được giải phóng trong khi trạng thái mới đã bắt đầu được tải, và dù mỗi giai đoạn riêng lẻ có đủ bộ nhớ GPU khi chạy một mình, việc chuyển đổi có thể vượt dung lượng vì cả hai bộ dữ liệu cùng chiếm bộ nhớ.
Gọi các thẻ dùng chung là H100 SXM, danh nghĩa 80 GB, khoảng 74,5 GiB. Trạng thái training chiếm 40 GiB bộ nhớ. Generation cần khoảng 15,3 GiB weight BF16 và một hồ KV cache 24 GiB, cộng 4 GiB chi phí chung cho cả hai giai đoạn. Chỉ riêng training dùng 44 GiB, và chỉ riêng generation dùng khoảng 43,3 GiB, cả hai đều dưới 74,5 GiB. Nếu weight và KV của generation được khôi phục trước và trạng thái training giải phóng sau, đỉnh là GiB, vượt dung lượng của một H100.
Đổi thứ tự — tải trước weight cần cho generation, chưa cấp phát KV — cho đỉnh GiB. Sau đó giải phóng 40 GiB trạng thái training hạ mức dùng bộ nhớ xuống khoảng 19,3 GiB, rồi mới cấp phát KV, đi vào trạng thái generation khoảng 43,3 GiB. Cả hai đường đều đạt cùng trạng thái cuối, nhưng các đỉnh chênh nhau 24 GiB, đúng một hồ KV.
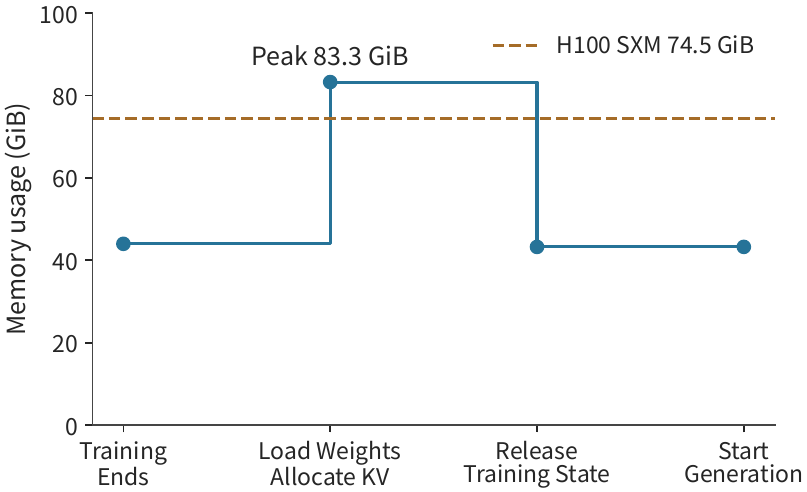
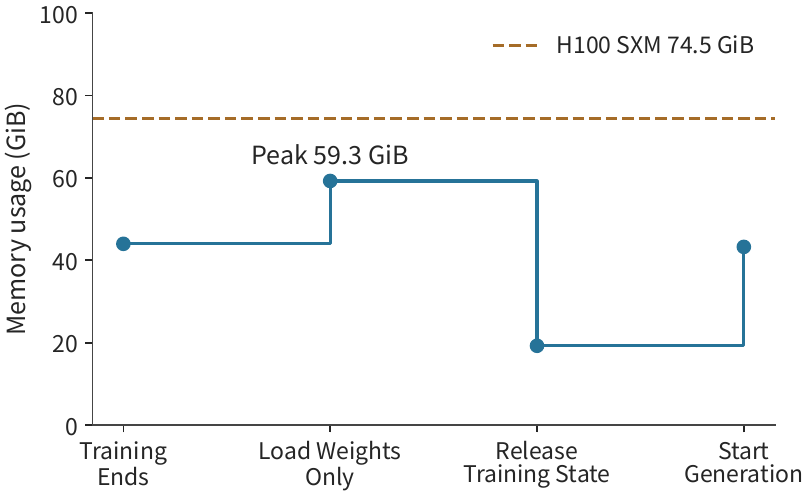
Chi phí của triển khai độc lập thay vào đó được quyết định bởi phạm vi truyền weight. Weight expert BF16 của Qwen3-235B-A22B tổng cộng 423 GiB; với expert parallelism (song song expert) 16 chiều (EP16), mỗi bên nhận chỉ cần khoảng 26,4 GiB. Gửi toàn bộ tập expert riêng lẻ cho 16 bên nhận tổng cộng GiB; gửi mảnh riêng của mỗi bên nhận tổng cộng 423 GiB. Trước tiên xác định mảnh tham số mà mỗi bên nhận cần, rồi tổ chức việc phân phối, có thể đồng thời giảm buffer nhận và khối lượng truyền của bên gửi.
Ở đây, cả hai phương pháp phân tích của chương này lại được dùng: accelerator dùng chung đòi hỏi phân tích vòng đời tensor, còn triển khai độc lập đòi hỏi phân tích truyền dữ liệu và thời gian xử lý của từng giai đoạn. Một khi các giai đoạn độc lập, sự khác biệt phiên bản policy nảy sinh; mục tiếp theo phân tích loại khác biệt phiên bản này ảnh hưởng thế nào đến số mẫu dùng được cho training.
Còn có một loại weight với vòng đời khác trong đồng bộ weight: các accelerator trọng số cố định từ Mục 4.7.3 có thể chạy các model trong một pipeline RL có weight không đổi trong thời gian dài. Ví dụ, khi thuật toán dùng một reference model cố định, weight của nó có thể nằm trong lưu trữ chuyên dụng và được đọc đi đọc lại; còn policy model được cập nhật liên tục dùng lưu trữ weight ghi được và công bố các phiên bản mới cho phía generation. Hình 10-39 vẽ các đường weight cho hai vòng đời này.
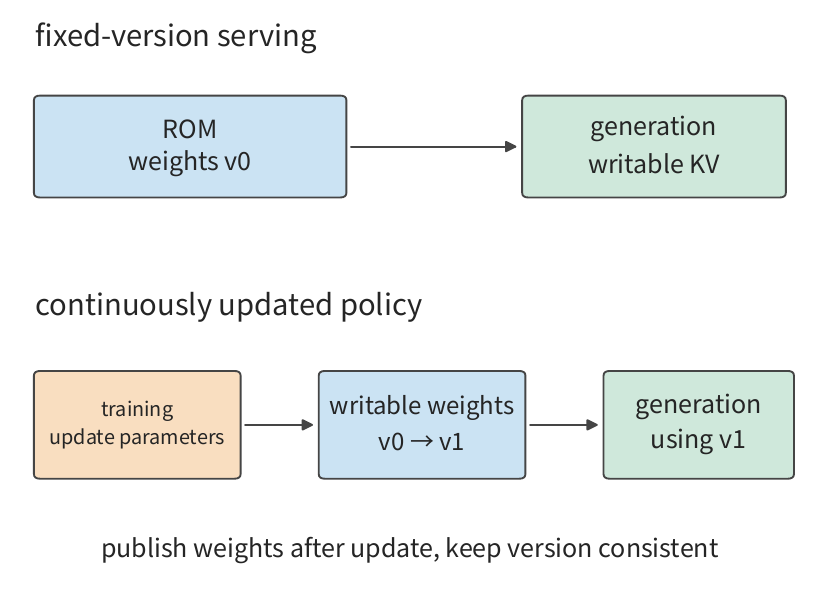
10.5.3 Training bất đồng bộ, phiên bản policy và khôi phục trajectory dài
Triển khai độc lập trong Mục 10.5.2 còn cho phép các batch xen kẽ: trong khi phía learning đang xử lý batch mẫu trước đó, phía generation đã bắt đầu sinh batch tiếp theo. Một vòng lặp đồng bộ thay vào đó chờ learning và đồng bộ weight hoàn tất trước khi sản xuất batch mẫu tiếp theo. Một vòng lặp bất đồng bộ cho phép generation và learning chồng lấp, và phía generation có thể vẫn đang dùng weight cũ. Để tính đóng góp của một mẫu vào lần cập nhật tham số hiện tại, xác suất dưới policy lấy mẫu thực tế phải được giữ lại.
Sau một lần cập nhật weight, policy của model thay đổi tương ứng. Dưới đây ta phân biệt ba phiên bản policy theo thứ tự các mẫu chảy qua.
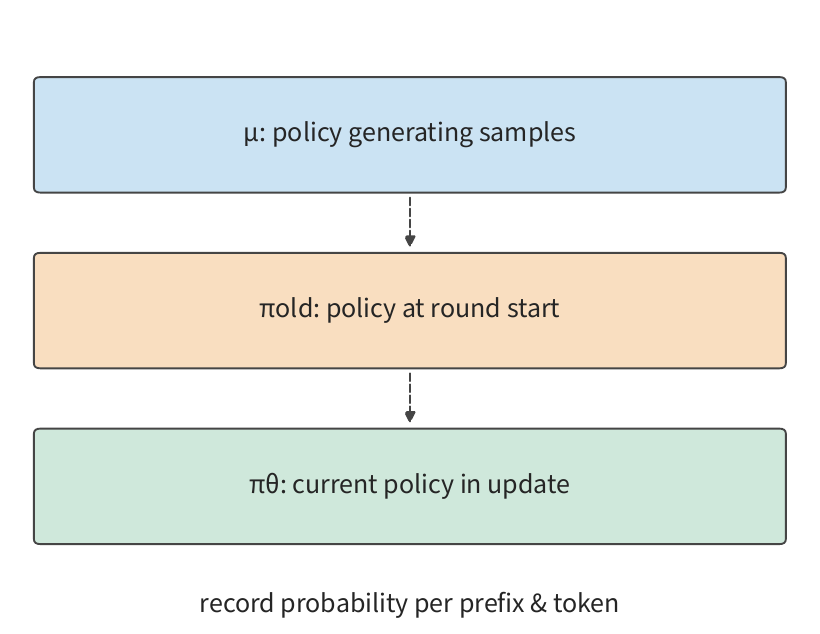
Gọi là phân phối hành vi thực tế, là policy khởi đầu của vòng tối ưu này, và là policy đang được tối ưu. Policy khởi đầu được cập nhật mỗi vòng tối ưu, còn reference model dùng cho việc chuẩn hóa KL-divergence giữ nguyên cố định. Với cùng token và tiền tố, tại các vị trí cả ba xác suất đều được định nghĩa và mẫu số khác không, tỷ số xác suất thỏa mãn
Hạng tử thứ nhất ở vế phải mô tả sự thay đổi xác suất do vòng tối ưu tham số này mang lại, và hạng tử thứ hai mô tả độ lệch giữa phân phối lấy mẫu thực tế và policy khởi đầu của vòng này, có thể bao gồm cả độ trễ phiên bản policy lẫn khác biệt từ cấu hình lấy mẫu hoặc tính toán xuyên engine. Nếu cả policy hành vi lẫn policy hiện tại đều cho token này log probability (logprob) là , tỷ số tổng là 1; nếu một log probability được tính lại sai được dùng thay cho giá trị mà policy hành vi ghi lại ban đầu, và nó ra , tỷ số trở thành . Tham số chưa đổi, vậy mà trọng số mẫu đã tăng khoảng 28%. Giữ lại xác suất hành vi cho phép phía training phân biệt thay đổi policy với sai lệch tính toán.
Ngay cả khi weight được đồng bộ trước mỗi vòng, hạng tử thứ hai vẫn không nhất thiết bằng 1. Phía generation thường giải mã (decode) từng token một và đọc từ KV cache, còn phía training đưa toàn bộ trajectory vào song song, tính lại xác suất tại mỗi vị trí token trước khi lan truyền ngược. Các triển khai attention khác nhau, thứ tự giảm, hình dạng batch hoặc độ chính xác weight/KV đều có thể làm logprob khác nhau với cùng weight và cùng tiền tố. Mục 5.2.4 đã đo một trường hợp như vậy: giảm cùng một hàng dữ liệu vào qua số đoạn khác nhau cho tổng bình phương chênh nhau 166 ULP, và số đoạn đến lượt nó phụ thuộc vào kích thước batch tại thời điểm đó. Forward computation là nơi hai phía phân kỳ trước tiên; backward pass sau đó mang độ lệch loss do forward của training dựng nên vào gradient. Routing rời rạc của MoE càng khuếch đại độ lệch này, như mục tiếp theo sẽ cho thấy.
Một phần hạng tử thứ hai cũng đến từ cấu hình lấy mẫu: xác suất hành vi được tính theo đúng quy tắc lấy mẫu thực tế. Temperature scaling, top-k hoặc top-p truncation thay đổi phân phối softmax thô của model, nên xác suất đã biến đổi và cấu hình lấy mẫu đều nên được lưu. Phía training phải dựng lại dữ liệu vào bằng tokenization, chat template, đánh số vị trí, attention mask và vị trí EOS/truncation tương ứng để tính tỷ số xác suất cho cùng một sự kiện.
Trong các bản cập nhật như proximal policy optimization (PPO), tỷ số xác suất quyết định trọng số mà advantage mang trong gradient, và cũng tham gia vào quyết định clipping: khi tỷ số xác suất lệch khỏi 1 quá một khoảng đã đặt, clipping cắt bỏ đóng góp của nó vào gradient. Nếu một sai lệch triển khai bị nhầm là một cập nhật tham số, đóng góp của một mẫu có thể bị khuếch đại hoặc triệt tiêu sai, và clipping có thể được kích hoạt sai; nếu dùng tỷ số xác suất mức chuỗi, các khác biệt logprob theo token cũng cộng dồn lại. Các trajectory dài hơn vì thế tích lũy nhiều lệch xác suất hơn, khiến các bản cập nhật dễ dao động hơn.
Importance weighting dùng tỷ số xác suất để điều chỉnh đóng góp của các sự kiện đã được lấy mẫu, nên phân phối lấy mẫu phải bao phủ các sự kiện đích. Các token bị loại bởi lấy mẫu cắt ngắn không thể được phục hồi qua tỷ số xác suất của các mẫu hiện có; khi các phân phối khác nhau quá nhiều, phương sai của các trọng số cũng tăng. Clipping có thể chặn các trọng số cực trị nhưng gây chệch (bias), và cắt riêng hai thừa số tạo ra một loss khác với việc cắt tỷ số gộp. Thực thi bất đồng bộ làm tăng độ trễ thời gian của phiên bản policy; phép tính lợi ích dưới đây hạch toán cả phần mẫu dùng được lẫn chu kỳ thực thi.
Ví dụ: một pipeline bất đồng bộ chịu được tỷ lệ loại mẫu cũ cao đến mức nào? Mỗi batch mất 40 s để sinh, 16 s để học, và một lần đồng bộ weight chặn cả hai phía mất 4 s, cho một chu kỳ đồng bộ 60 s. Nếu generation và learning dùng tài nguyên độc lập trong khi đồng bộ weight vẫn chiếm độc quyền 4 s, chu kỳ bất đồng bộ ở trạng thái ổn định là s.
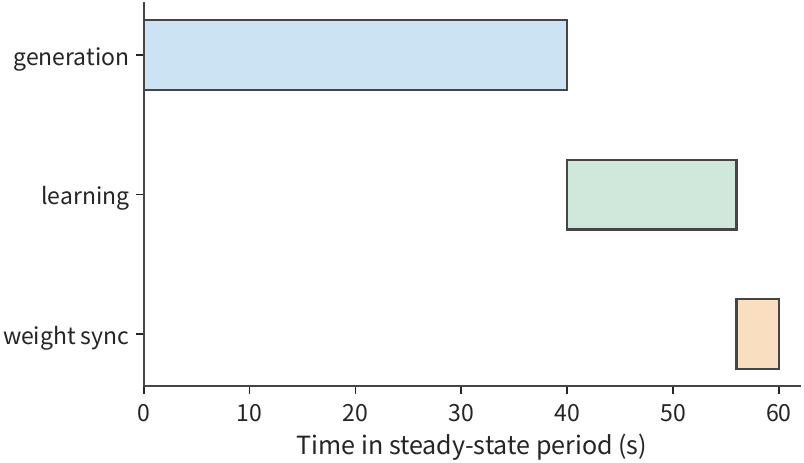
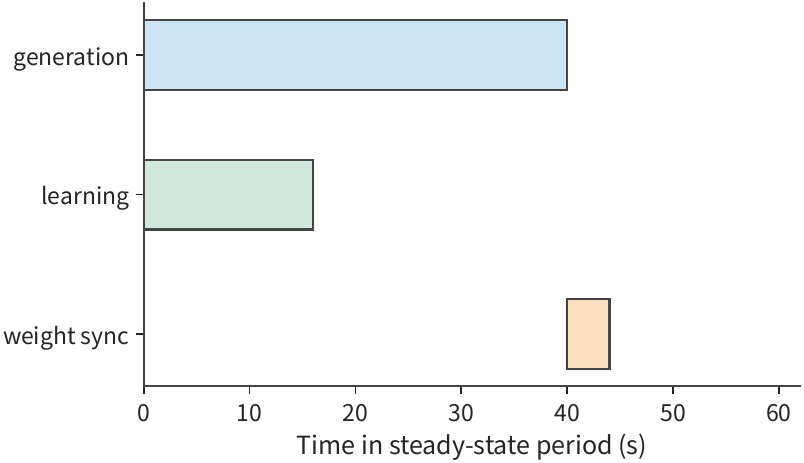
Chuyển từ thực thi đồng bộ trong Hình 10-41 sang thực thi bất đồng bộ trong Hình 10-42 giảm thời gian hai phía learning và generation lần lượt chờ nhau. Nhưng sinh sớm hơn cũng nghĩa là các mẫu có thể dùng weight cũ hơn, nên các mẫu bị loại vẫn phải được trừ đi.
Nếu mỗi batch ban đầu có trajectory tương đương, và sau thực thi bất đồng bộ một phần trong đó được giữ lại cho training, thì thông lượng mẫu hiệu dụng của thực thi đồng bộ và bất đồng bộ lần lượt là và . Để thực thi bất đồng bộ nhanh hơn cần
Ở , thông lượng mẫu hiệu dụng cải thiện khoảng 9%; ở , dù mỗi batch hoàn thành sớm hơn, thông lượng mẫu hiệu dụng thực tế giảm khoảng 5%. Vì vậy, khi tính lợi ích của thực thi bất đồng bộ, các mẫu bị loại vì phiên bản policy quá cũ cũng phải được trừ đi.
Giai đoạn generation trong hình được vẽ như một khối công việc liên tục. Trajectory càng dài, khối này càng dễ trải qua một lần cập nhật tham số hoặc gặp một sự gián đoạn, nên ngoài việc lọc các mẫu đã hoàn thành, người ta còn phải xét cách tiếp tục một trajectory chưa hoàn chỉnh. Trajectory dài cũng kéo dài khoảng cách thời gian giữa lúc sinh một mẫu và lúc huấn luyện trên nó. KV là kết quả thực thi một tiền tố dưới một bộ weight cho trước: khi tiếp tục với cùng weight, KV đã lưu có thể được dùng tiếp, nhưng sau một lần đổi weight, tiền tố phải được thực thi lại để tái sinh KV tương ứng. KV BF16 8K của Qwen3-8B chiếm 1,125 GiB; lưu và lấy lại KV cache đòi hỏi không gian lưu trữ và thời gian truyền, còn dựng lại KV cache đòi hỏi thực thi lại tính toán prefill. Sơ đồ khôi phục được chọn bằng cách so sánh thời gian lấy lại với thời gian dựng lại tương ứng.
Nếu các trajectory bị gián đoạn luôn bị loại và lấy mẫu lại, trajectory dài hơn khả năng bị loại cao hơn đơn giản vì chúng mất nhiều thời gian thực thi hơn. Gọi là tỷ lệ gián đoạn trong lúc generation; xác suất một trajectory có thời lượng hoàn thành generation không bị gián đoạn là , và khi tăng, tỷ lệ dữ liệu đến được learning giảm. Ghi lại tiến độ generation và phiên bản policy theo từng token cho phép việc sinh cùng một trajectory tiếp tục sau khi khôi phục, giảm độ chệch theo độ dài do sự gián đoạn hệ thống gây ra. Việc khôi phục tài nguyên xuyên vai trò được mở rộng trong chương tiếp theo.
Việc khiến training và triển khai dùng cùng một đường thực thi đã thấy trong các model thực. DeepSeek V4.1 gấp phương pháp truy cập thưa và khôi phục dùng lúc triển khai vào training. Attention thưa dùng chuỗi 64K ngay từ đầu training, và post-training thêm các giới hạn ứng viên cấp layer, nên training và inference dùng cùng miền tìm kiếm; quantization-aware training (training mô phỏng sai số của lượng tử hóa độ chính xác thấp) cho phép model thích nghi với KV chính FP4; chỉ một đoạn dữ liệu vào có độ dài hạn chế được phát lại để dựng lại trạng thái SWA của decoder, và quá trình này cũng được mô phỏng trong post-training. Model nhờ đó học dùng biểu diễn và trạng thái cục bộ mà đường triển khai thực sự cung cấp.
10.5.4 Expert routing replay và training-serving consistency
MoE biến các khác biệt số học của Mục 10.5.3 thành các khác biệt đường rời rạc hơn nữa: ngay cả với weight giống hệt nhau, khác biệt tính toán số học giữa phía generation và phía training có thể thay đổi việc chọn expert. Vì việc chọn expert là rời rạc, một thay đổi số nhỏ có thể đẩy một token sang một đường tính toán khác. Lấy hai expert có điểm cao nhất làm ví dụ: khi ba điểm expert cao nhất là 0,500, 0,301 và 0,300, lựa chọn là expert 1 và 2; nếu điểm thứ ba đổi thành 0,302 do một thứ tự tính toán khác, lựa chọn trở thành expert 1 và 3. Một thay đổi điểm rất nhỏ có thể khiến phép tính chuyển sang ma trận weight của một expert khác, và tác động có thể tiếp tục lan qua các layer sau.
Routing replay (phát lại định tuyến) ghi lại các ID expert logic được chọn trong lúc generation. Trong training, các expert được chọn theo các ID này, và điểm routing, đầu ra expert và gradient sau đó được tính với weight hiện tại. Mẫu, vị trí token và số layer cùng nhau định vị bản ghi này. Bằng cách này, generation và training đi qua cùng một đường expert rời rạc, trong khi tính toán số học tiếp tục phản ánh các tham số hiện tại.
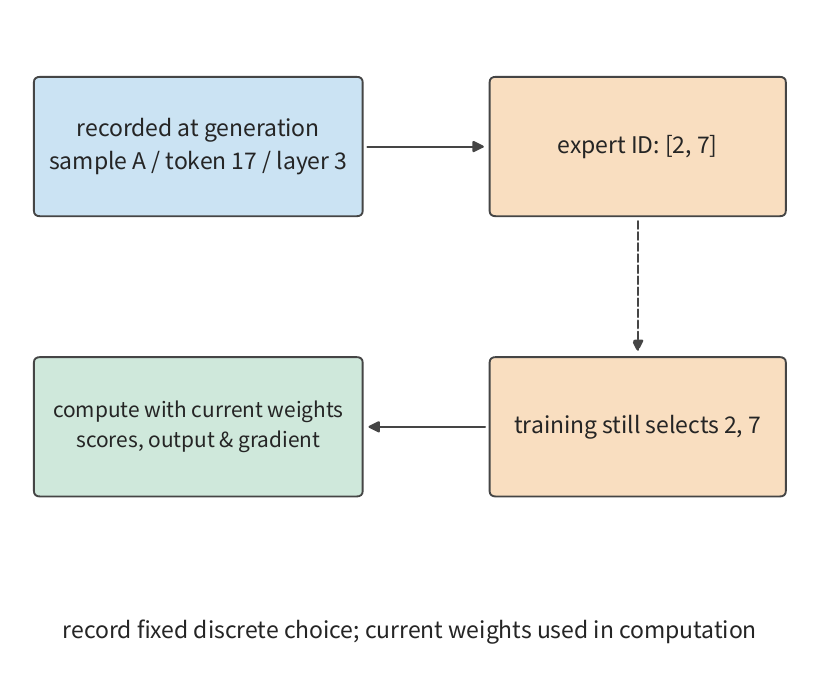
Trước tiên, tính bản ghi này chiếm bao nhiêu không gian. 48 layer của Qwen3-30B-A3B mỗi layer ghi lại ID của 8 expert có điểm cao nhất. Với 8.192 token, lưu mỗi ID expert ở định dạng uint16 (một số nguyên không dấu chiếm 2 byte) cho kích thước
Dùng định dạng int32, chiếm 4 byte mỗi số nguyên, cho 12 MiB. Bản ghi cũng phải di chuyển cùng với token: packing chuỗi đổi vị trí của một token, chia ngữ cảnh đổi thẻ mà một token nằm trên, và recomputation đọc lại bản ghi của cùng layer. Chỉ khi để ID và vị trí gốc của token đi qua các biến đổi này cùng nhau, phía training mới có thể chọn đúng tập expert ban đầu.
Tình huống: tác động của routing replay lên sai số xác suất, thời gian training và reward. Báo cáo xác minh được NVIDIA công bố về routing replay (R3, tức Rollout Routing Replay) có bốn nhóm so sánh bật/tắt, mỗi nhóm được huấn luyện 100 bước. Với replay bật, sai số log-probability trung vị được ghi trong log giảm mỗi lần, thời gian mỗi bước trung vị dài hơn một chút, và training reward không cho thấy cải thiện nhất quán. Replay giảm phân kỳ routing, nhưng lưu bản ghi và thực thi replay cũng thêm thời gian. Khi so sánh hai sơ đồ, hãy quan sát riêng sai số xác suất, thời gian training và hiệu năng trên một nhiệm vụ đánh giá cố định.
Dưới cùng weight và cùng batch token, khác biệt logprob giữa phía generation và phía training phản ánh tác động của đường tính toán và định nghĩa lấy mẫu; ID expert của MoE cho biết routing rời rạc có nhất quán hay không. Việc số học có nhất quán không, và policy lấy mẫu tụt sau policy hiện tại bao xa, cùng nhau quyết định số mẫu training hiệu dụng.
RL tổ chức generation, xác minh môi trường và cập nhật tham số thành một quá trình phản hồi hoàn chỉnh duy nhất. Phía generation cung cấp xác suất lấy mẫu và lựa chọn expert; phía training tổ chức các bản cập nhật dựa trên chúng; lập lịch tài nguyên sau đó sắp xếp sự chồng lấp của các giai đoạn khác nhau. Nối thông tin này từ đầu đến cuối giúp có thể tối ưu đồng thời việc bàn giao dữ liệu, tính nhất quán thực thi và mức sử dụng tài nguyên. Các ví dụ chu kỳ bất đồng bộ và routing replay của mục này lần lượt định lượng thời gian chờ tiết kiệm được và chi phí giữ bản ghi phải trả thêm; vòng phản hồi tổng thể cuối cùng được đánh giá bằng mẫu hiệu dụng và tiến độ training.
10.6 Từ sơ đồ hệ thống đến hạn chót và lựa chọn phần cứng
10.6.1 Gộp dung lượng, độ trễ mỗi bước, tạm dừng và phục hồi
Phần dưới đây tập hợp phép tính thời gian hoàn thành cho nhiệm vụ training được giới thiệu ở đầu chương. Cả hai sơ đồ đều xử lý 100B token, với mỗi bước gồm 384 chuỗi 8.192 token, tổng cộng 31.790 vòng lặp training. Gọi thời gian training mỗi bước đã bao gồm tính toán mỗi thẻ, chờ truyền thông và chờ dữ liệu vào; gọi là tỷ trọng thời gian thêm cho lưu và phục hồi; và gọi là thời gian tạm dừng theo kế hoạch. Mô hình thời gian hoàn thành bậc nhất của chương này khi đó là
Mỗi hạng tử đến từ một mức phân tích khác nhau trong chương này: phân tích vòng đời của một tensor xác nhận bộ nhớ GPU có đủ hay không; phân tích đường tới hạn cho ra ; mô hình checkpoint cho ra ; và thời gian tạm dừng theo kế hoạch là ngày. Tập hợp các kết quả này lại cho phép so sánh thời gian hoàn thành của hai sơ đồ; các tổng trong bảng được tính từ các giá trị chưa làm tròn.
| Hạng mục thiết kế | Sơ đồ 32 thẻ | Sơ đồ 48 thẻ |
|---|---|---|
| Số host tám thẻ | 4 | 6 |
| ZeRO-3 toàn nhóm, số micro-batch một chuỗi mỗi thẻ | 12 | 8 |
| Mức dùng bộ nhớ GPU ước tính mỗi thẻ / GiB | 13.8 | 12.5 |
| Bộ nhớ GPU sẵn có mỗi thẻ / GiB | 22 | 22 |
| Tính toán mỗi thẻ mỗi bước / s | 78.3 | 52.2 |
| Thời gian liên kết ZeRO-3 mỗi bước (PCIe 4.0 x16) / s | 17.9 | 12.0 |
| Thời gian chờ truyền thông mỗi bước / s | 0.08 | 0.08 |
| Thời gian chờ dữ liệu vào mỗi bước / s | 0.5 | 0.5 |
| Thời gian training mỗi bước (gồm 0,5 s chờ dữ liệu vào) / s | 78.9 | 52.8 |
| Thời gian thêm cho lưu, làm lại và phục hồi | 1.02% | 1.08% |
| Thời gian training cơ bản / ngày | 29.0 | 19.4 |
| Gồm lưu/phục hồi và 5 ngày dự trữ / ngày | 34.3 | 24.6 |
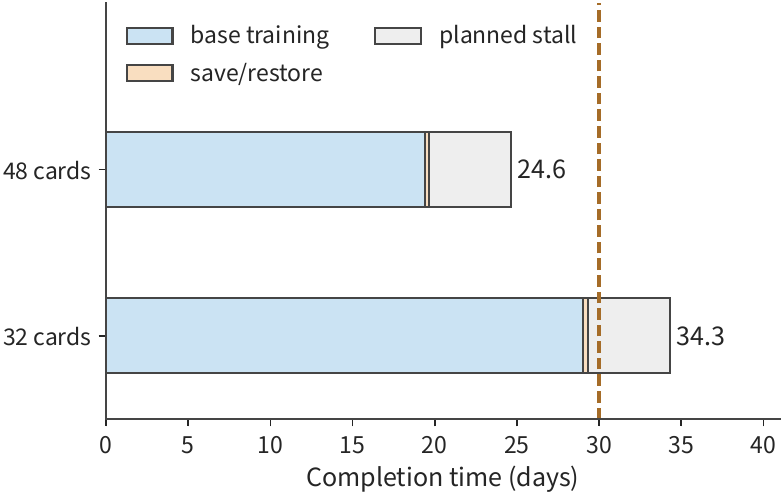
Trong Hình 10-44, hai sơ đồ có cùng thời gian tạm dừng theo kế hoạch, và lưu cùng phục hồi chỉ chiếm một đoạn rất nhỏ. Khác biệt chính nằm ở thời gian training cơ bản màu xanh: sơ đồ 48 thẻ phân phối các micro-batch cho nhiều thẻ hơn để xử lý song song, rút ngắn đáng kể đoạn này.
Dưới bộ điều kiện thiết kế này, sơ đồ 48 thẻ được chọn. Cả hai đều thỏa mãn yêu cầu dung lượng; thời gian hoàn thành của sơ đồ 32 thẻ vượt 30 ngày và bị loại; sơ đồ 48 thẻ hoàn thành trong khoảng 24,6 ngày, để lại khoảng 5,4 ngày dư. Giá trị chính của việc thêm thẻ là giảm công việc training mà mỗi thẻ gánh; chi phí sự cố thêm vào chỉ bù một phần nhỏ lợi ích này.
10.6.2 Phạm vi khả thi của một cluster 4090
Hình 10-44 cho biên dư khoảng 5,4 ngày. Khấu hao biên dư này ngược về từng vòng lặp cho thấy mỗi bước có thể chịu thêm bao nhiêu thời gian chờ, từ đó đưa ra một chỉ tiêu hiệu năng dùng được cho việc tinh chỉnh thực tế. Thời gian training mỗi bước của sơ đồ 48 thẻ phải thỏa mãn
Sơ đồ này hiện đạt khoảng 52,8 s, để lại biên dư khoảng 14,4 s mỗi bước. Cố định thời gian tính toán mỗi thẻ ở khoảng 52,2 s và chờ dữ liệu vào ở 0,5 s, tổng thời gian chờ truyền thông nhiều nhất khoảng 14,5 s; theo phân tích chồng lấp trong Mục 10.3.3, hiện chỉ khoảng 0,08 s bị lộ ra. Ngay cả khi nạp trước hỏng hoàn toàn, lộ toàn bộ thời gian liên kết 12,0 s, mỗi bước sẽ mất khoảng 64,8 s, vẫn nằm trong cận trên.
Ngược lại, sơ đồ 32 thẻ cần hiệu quả tính toán mỗi thẻ cao hơn. Sau khi trừ phục hồi, 0,08 s truyền thông và 0,5 s dữ liệu vào, khoảng 66,7 s có thể được phân cho tính toán mỗi thẻ, trong khi hiệu quả 40% đòi hỏi khoảng 78,3 s. Cùng một khối lượng công việc đòi hỏi nâng hiệu quả tính toán mỗi thẻ lên khoảng , đã cao hơn mức tối đa 43% được báo cáo cho Llama 3. Vậy hai đường cải thiện có thể so sánh trực tiếp: thêm hai host nữa, hoặc nâng hiệu quả tính toán mỗi thẻ trên các thẻ hiện có từ 40% lên khoảng 47%.
Ngân sách truyền thông cũng phải được neo vào giao diện vật lý. Thời gian liên kết 12,0 s trong Mục 10.3.3 giả định một NIC 200 Gbit/s mỗi thẻ. Nếu tám thẻ trong một host chỉ dùng chung một NIC 200 Gbit/s, mép của truyền thông tập thể dạng vòng đi vào và rời host đó phải mang đầy đủ khối lượng gửi/nhận của mọi thẻ trên đó (tập cắt từ Ví dụ 7.1 trong Chương 7); trong sơ đồ 48 thẻ, khoảng 385 GB mỗi bước phải đi qua NIC 25 GB/s đơn lẻ này, cho thời gian liên kết khoảng 15,4 s, vượt trần truyền thông 14,5 s. Thời gian liên kết mỗi micro-batch khoảng 1,92 s, vẫn ngắn hơn 6,53 s tính toán, nên khi nạp trước hiệu quả, chỉ lần truyền thông đầu và cuối bị lộ; nhưng một khi nạp trước hỏng, mỗi bước mất khoảng 68,1 s, và sơ đồ trượt hạn chót. Với một NIC mỗi thẻ, 12,0 s vẫn nằm trong trần kể cả khi bị lộ hoàn toàn. Khác biệt giữa hai cấu hình là một NIC dùng chung đặt cược việc kịp hạn vào khả năng chồng lấp, còn một NIC mỗi thẻ không phụ thuộc vào chồng lấp.
Theo cách này, chỉ tiêu hiệu năng ánh xạ thành một quá trình thực thi cụ thể: mỗi bước cho phép nhiều nhất 67,2 s, trong đó tính toán cần khoảng 52,2 s, để phần còn lại cho truyền thông và chờ dữ liệu vào. Khi tinh chỉnh, trước tiên rút ngắn đoạn nào của đường tới hạn vượt ngân sách; nếu bộ nhớ GPU đã đủ chứa các tensor cần thiết, không cần làm thêm công việc chỉ để tiết kiệm bộ nhớ.
10.6.3 Nút thắt và lựa chọn sau khi thay phần cứng
Khi thay accelerator, ngân sách ở mục trước vẫn có thể được dùng để đánh giá tính toán nhanh hơn sẽ rút ngắn đoạn nào, và băng thông thấp hơn sẽ kéo dài đoạn nào. Một accelerator mới thay đổi đồng thời tính toán mỗi thẻ, dung lượng và liên kết. Chia thời gian mỗi bước gốc thành tính toán, chờ truyền thông và các phần khác giúp đánh giá một thay đổi phần cứng nhất định đáng giá bao nhiêu. Gọi là tỷ trọng thời gian mỗi bước gốc bị một tài nguyên nhất định chiếm, và gọi năng lực xử lý của nó thay đổi thành lần so với gốc, với mọi thực thi và phụ thuộc khác giữ nguyên. Khi đó
Đây là định luật Amdahl áp dụng theo tỷ trọng của từng thành phần thời gian. Nếu chờ truyền thông chỉ 5 ms trong 100 ms gốc, giảm nửa băng thông đổi tổng thành ms; nếu truyền thông ban đầu chiếm 50 ms, cùng phép giảm cho ms. Thời gian của nhiệm vụ thứ nhất tăng 5%, nhiệm vụ thứ hai tăng 50%, vì tỷ trọng thời gian chờ tài nguyên đó trong bản gốc chênh nhau một thừa số mười.
Trong sơ đồ 48 thẻ của chương này, truyền thông bị lộ chỉ khoảng 0,08 s, khoảng 0,14% mỗi bước. Nếu băng thông PCIe giảm một nửa, thời gian liên kết mỗi micro-batch tăng lên khoảng 3,0 s, vẫn ngắn hơn 6,53 s tính toán; phần bị lộ tăng gấp đôi lên khoảng 0,15 s, và thời gian mỗi bước tăng từ khoảng 52,8 s lên 52,9 s — gần như không đổi. Nếu hiệu quả tính toán mỗi thẻ giảm từ 40% xuống 30%, thời gian tính toán mỗi thẻ trở thành khoảng 69,6 s, và cộng truyền thông cùng dữ liệu vào tổng khoảng 70,2 s, vượt chỉ tiêu 67,2 s. Với sơ đồ này, hiệu quả tính toán mỗi thẻ, chứ không phải băng thông, quyết định hạn chót có được đáp ứng hay không; băng thông chỉ trở thành hạng tử có lớn hơn trong công thức khi nạp trước hỏng và truyền thông bị lộ hoàn toàn.
Khi so sánh A100, A800, H20 hoặc các accelerator khác, người ta có thể thay thời gian tính toán mỗi thẻ, thời gian truyền giao diện và dung lượng của chúng vào cùng phân tích. Trong số các sơ đồ thỏa mãn hạn chót, so sánh tiếp chi phí thuê accelerator, năng lượng và chuẩn bị. Việc một con số mạnh hơn trên một thông số đơn lẻ có đáng trả hay không phụ thuộc vào nó tiết kiệm được bao nhiêu thời gian hoàn thành hoặc bao nhiêu thẻ.
10.6.4 Độ nhạy với quy mô model, khối lượng dữ liệu và hạn chót
Các mục trước giữ model cố định trong khi so sánh số thẻ và dòng accelerator. Cuối cùng, mở rộng cùng phương pháp sang quy mô model, và xem tính toán tăng thế nào khi model được phóng to. Dùng công thức tính thô cho model đặc (dense), , và cố định khối lượng dữ liệu ở T token, MFU ở 40%, và hạn thực thi sẵn có ở , số thẻ cần để đáp ứng hạn chót là
Hình 10-46 vẽ hạn 90 ngày thành một ranh giới số thẻ. Một khi quy mô model được chọn, các tài nguyên tính toán phía trên ranh giới có thể hoàn thành công việc ở hiệu quả đó, còn các tài nguyên phía dưới cần hiệu quả cao hơn hoặc hạn chót dài hơn.
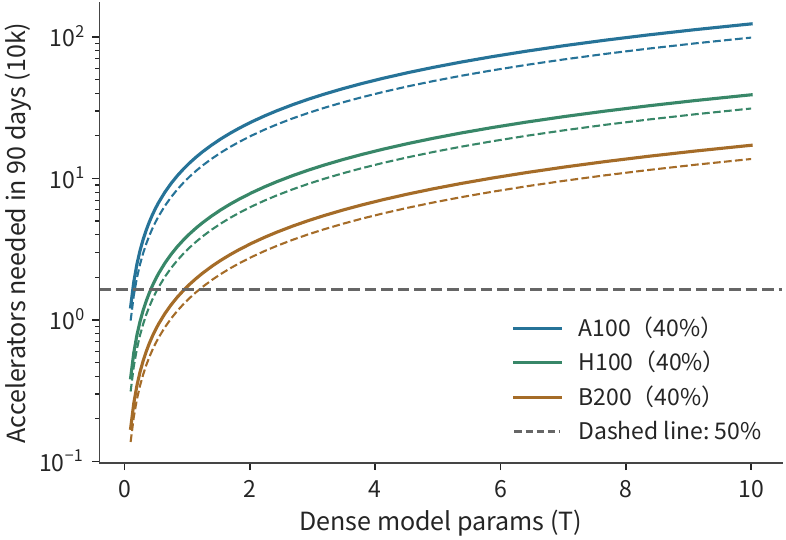
Với một model 1T tham số, 16.384 thẻ A100, H100 và B200 ở MFU 40% lần lượt cần khoảng 679, 214 và 94 ngày. Dưới ngân sách thực thi 90 ngày, cả ba đều nằm dưới ranh giới tính toán: ngay cả B200 cũng vượt khoảng 4 ngày, đòi hỏi tăng lên khoảng 17.147 thẻ. Chỉ khi MFU đạt 50%, B200 mới giảm xuống khoảng 75 ngày, nằm trong hạn chót, với khoảng 15 ngày còn lại cho tạm dừng theo kế hoạch và phục hồi. Chênh 10 điểm phần trăm MFU quyết định 16.384 thẻ B200 có thể hoàn thành training một model 1T trong 90 ngày hay không.
Ở khối lượng dữ liệu cố định, tăng số tham số lên gấp năm cũng tăng tính toán gấp năm; nhưng nếu khối lượng dữ liệu đồng thời thỏa mãn , thì , và tăng số tham số gấp năm làm tính toán tăng gấp 25 lần. Câu trả lời cho một câu hỏi mở rộng quy mô được quyết định chung bởi model và dữ liệu. MoE, trái lại, tính trạng thái của mọi tham số có thể huấn luyện tách khỏi công việc thực thi của đường được kích hoạt, rồi đặt việc trao đổi expert trên đường tới hạn.
Một khi thiết kế hoàn tất, người ta vẫn phải kiểm tra thực thi dài hạn có đạt kỳ vọng hay không. Các log training công khai là một cửa sổ quan sát thực thi dài hạn. Nếu training tiếp tục từ một checkpoint, số token mới thêm cho lần chạy này bằng số tích lũy cuối trừ số tích lũy tại điểm bắt đầu phục hồi; chia khối lượng mới thêm cho thời gian của lần chạy này cho ra tỷ lệ dài hạn tương ứng. Tỷ lệ này có thể được dùng trực tiếp để kiểm tra toàn bộ hệ thống có duy trì được tiến độ training hiệu dụng giả định trong thiết kế hay không.
Nhìn lại cả chương: Hình 10-10 đến Hình 10-14 giải thích dữ liệu chiếm bộ nhớ GPU và chảy qua các liên kết như thế nào; Hình 10-17 đến Hình 10-35 cho thấy các thao tác này tạo ra sự chờ và do đó ảnh hưởng đến training dài hạn ra sao; Hình 10-44 sau đó tập hợp mọi thành phần thời gian này vào thời gian hoàn thành của nhiệm vụ được giới thiệu ở đầu chương. Sắp xếp trạng thái, thứ tự thực thi và phương pháp phục hồi nhờ đó được nối thành một bài toán thiết kế duy nhất. RL thay đổi nguồn công việc thành một vòng phản hồi, nhưng vẫn dùng cùng phương pháp để so sánh tài nguyên và tiến độ training hiệu dụng. Chương tiếp theo bàn sâu hơn về việc các công việc và giai đoạn này chia sẻ một hồ tài nguyên như thế nào.
Ngộ nhận và cạm bẫy
Ngộ nhận: nhân đôi số shard làm giảm một nửa bộ nhớ training đỉnh. Sharding chỉ trực tiếp thu nhỏ trạng thái training cư trú được gán cho mỗi thẻ. Trong ví dụ model nhỏ, trạng thái training cư trú giảm từ 18 MiB xuống 9 MiB, nhưng các tensor và buffer khác dùng trong lúc thực thi vẫn chiếm khoảng 21 MiB, nên đỉnh chỉ giảm từ 39 MiB xuống 30 MiB. Điều quyết định yêu cầu dung lượng là tổng vết bộ nhớ GPU tại một thời điểm duy nhất.
Ngộ nhận: thời gian xử lý truyền thông ngắn hơn nghĩa là thời gian bước training ngắn hơn. Tổng thời gian xử lý của ba bucket nhỏ khoảng 4,59 ms, dài hơn 4,55 ms của một bucket lớn duy nhất, nhưng ba bucket mỗi cái có thể dùng một cửa sổ rảnh tính toán riêng để hoàn tất truyền của mình. Chính thời điểm truyền thông hoàn tất quyết định nó có kéo dài bước training hay không.
Ngộ nhận: một khi lời gọi lưu bất đồng bộ trả về, mọi tiến độ trước đó đều có thể được khôi phục. Trong sự cố ở giây thứ 50, điểm phục hồi sẵn có phụ thuộc vào snapshot nào đã được commit. Cùng 1 s tạm dừng tiền cảnh có thể tương ứng với 30 s hoặc 10 s công việc làm lại, khác biệt đến từ thời điểm việc ghi nền hoàn tất.
Ngộ nhận: nâng thông lượng generation giúp RL học nhanh hơn. Với generation ở 12 chuỗi/s, verification ở 6 chuỗi/s và tỷ lệ giữ mẫu 75%, phía learning chỉ nhận 4,5 trajectory mỗi giây. Thêm tài nguyên generation không thể gỡ nút thắt ở giai đoạn verification; chỉ nâng năng lực verification mới dịch chuyển ràng buộc sang phía training.
Ngộ nhận: nhân đôi số thẻ và tăng batch size theo tỷ lệ sẽ làm thời gian hoàn thành giảm một nửa. Một khi batch size vượt critical batch size, số bước cần để đạt cùng loss không còn giảm đáng kể. Với thang nhiễu hai triệu token, tăng batch size mỗi bước từ 3,15 triệu lên khoảng một trăm triệu token (1536 thẻ) chỉ giảm thời gian hoàn thành từ 19,4 ngày xuống 12,1 ngày, một trần tăng tốc 1,64x. Mở rộng batch size bị giới hạn bởi gradient noise scale; strong scaling, vốn giữ batch size cố định và chỉ thêm thẻ, không bị giới hạn bởi nó.
Bài tập chương và tái lập kết quả
Mười bài tập dưới đây tiến triển từ tính toán cơ bản qua phân tích cơ chế đến thiết kế toàn diện. Mọi điều kiện cần cho các bài toán tính đều được cho trong văn bản chính; các phần thí nghiệm dùng các bản ghi kèm theo hoặc dữ liệu đo độc lập.
Bài tập 10-1 · Cơ bản: sharding trạng thái training và bộ nhớ đỉnh mỗi thẻ
Đổi gradient của chương này sang FP32 và tính trạng thái training cư trú của Qwen3-8B. Sau đó tìm dung lượng mỗi thẻ cho ZeRO-1, ZeRO-2 và ZeRO-3 tám thẻ. Giả định thực thi liên quan 6 GiB activation và hai buffer module 3 GiB mỗi cái; tính bộ nhớ GPU đỉnh cả khi hai buffer chiếm bộ nhớ đồng thời lẫn khi chúng được tái sử dụng tuần tự.
Bài tập 10-2 · Cơ bản: hiệu quả tính toán mỗi thẻ cần bao nhiêu để hoàn thành training đúng hạn
Dùng nhiệm vụ training của chương này, đặt global batch size thành 384 chuỗi và tính các ngân sách mỗi bước tương ứng với 30 ngày và 25 ngày. Với 32 thẻ, trước tiên theo Mục 10.3.3 tìm thời gian liên kết ZeRO-3 mỗi bước và phần chờ truyền thông bị lộ, rồi cộng 0,5 s chờ dữ liệu vào; trước tiên bỏ qua phục hồi, tìm hiệu quả tính toán mỗi thẻ tối thiểu cần để hoàn thành training trong 25 ngày; rồi cộng chi phí phục hồi của chương này. Cuối cùng, lấy gradient noise scale là hai triệu token, dùng quan hệ trong Mục 10.1.1 tìm trần tăng tốc weak scaling, cùng thời gian hoàn thành cho 96 và 1536 thẻ dưới weak scaling và strong scaling; tính lại trần sau khi đổi thang nhiễu thành hai mươi triệu token.
Bài tập 10-3 · Thiết kế toàn diện: chọn sơ đồ training giữa dung lượng, hạn chót và chi phí accelerator
So sánh thời gian hoàn thành training của sơ đồ 32 thẻ và 48 thẻ, cùng tổng GPU-hours sử dụng. Nâng yêu cầu đỉnh cho activation và buffer tạm mỗi bước từ 10 GiB lên 20 GiB và đánh giá lại dung lượng. Nếu bản sao weight BF16 thay vào đó được lưu bằng định dạng FP8 theo khối có scale từ Mục 10.1.2, tính lại trạng thái cư trú mỗi thẻ và biên dư dung lượng của mỗi sơ đồ. Nếu chỉ thuê được bốn host tám thẻ, hãy tính riêng nhiệm vụ phải giảm bao nhiêu khối lượng, hạn chót phải kéo dài bao nhiêu, hoặc hiệu quả tính toán phải nâng lên bao nhiêu để hoàn thành training. Với phần thí nghiệm, chọn một hướng để đo trong thực tế, và thay các tham số đã cho của chương này bằng các giá trị đo được.
Bài tập 10-4 · Phân tích: số micro-batch và recomputation activation thay đổi chi phí pipeline như thế nào
Với một model bốn giai đoạn có forward pass 10 ms và backward pass 20 ms, tìm mức sử dụng lý tưởng cho 1, 4, 8 và 16 micro-batch. Dùng Hình 10-19, giải thích lần chờ 93–95 ms đến từ phụ thuộc nào. Sau đó, với tám micro-batch, so sánh interleaved 1F1B () với lập lịch zero-bubble (ZB-H1, ): tính thời gian bubble của mỗi lịch trình bằng các công thức trong văn bản chính, đối chiếu với thời gian hoàn thành 298 ms và 283 ms do mô hình sự kiện cho, và giải thích vì sao sơ đồ interleaved làm tăng số lần truyền xuyên biên. Giả sử tích có thể dựng lại của mỗi layer cho mỗi micro-batch chiếm 10 MiB; trong sơ đồ gốc, bốn micro-batch chưa thực thi lan truyền ngược, và mỗi micro-batch phải giữ các tích này cho chín layer. Đổi lại sao cho chỉ tích cần cho một micro-batch trong một layer được dựng lại tại một thời điểm, và được giải phóng ngay sau khi dùng. Tính lượng dữ liệu sơ đồ mới cần giữ ít đi bao nhiêu, và kích thước tập làm việc cần cho việc dựng lại tuần tự từng layer; rồi bàn tập làm việc thay đổi thế nào khi hai layer thực thi lan truyền ngược đồng thời.
Bài tập 10-5 · Phân tích: khi tiến trình chuẩn bị dữ liệu tạm dừng, phải nạp trước bao nhiêu chuỗi
Sơ đồ 48 thẻ xử lý 384 chuỗi mỗi bước, với thời gian training mỗi bước khoảng 52,8 s; bốn tiến trình chuẩn bị dữ liệu mỗi tiến trình chuẩn bị hai chuỗi mỗi giây. Nếu một tiến trình chuẩn bị dữ liệu tạm dừng 60 s, dùng tốc độ tiêu thụ trung bình của phía training, tìm số chuỗi tối thiểu phải được lưu trước để duy trì tốc độ training ban đầu, và sau khi cả bốn tiến trình chuẩn bị hoạt động trở lại, sẽ mất bao lâu để nạp lại hàng đợi nạp trước về mức trước khi tạm dừng. Sau đó, dùng tốc độ ghi lưu trữ gộp 7 GB/s từ Mục 10.4.3, tìm chu kỳ lưu tối thiểu tránh tồn đọng ghi cho một checkpoint khoảng 115 GB.
Bài tập 10-6 · Phân tích: tần suất lưu checkpoint và chi phí làm lại sự cố
Dùng mô hình xấp xỉ bậc nhất của chương này, suy ra chu kỳ lưu tối ưu, và tính chi phí thời gian do lưu checkpoint và làm lại sự cố gây ra cho một công việc 1024 thẻ ở các chu kỳ lưu 300, 900 và 1800 s. Thêm một sự gián đoạn dùng chung xảy ra mỗi ngày một lần và ảnh hưởng đồng thời toàn bộ công việc, và tính lại tỷ lệ sự cố cùng chu kỳ tối ưu. Sau đó, coi việc quay lui do loss spike xảy ra trung bình mỗi bảy ngày một lần là một cú sốc ảnh hưởng đồng thời toàn bộ công việc, cộng nó vào mô hình 48 thẻ, và tính lại chu kỳ lưu tối ưu cùng tỷ trọng thời gian thêm ở chu kỳ 600 s. Với phần thí nghiệm, tiêm sự cố cả trước và sau một lần lưu, và so sánh điểm phục hồi cùng công việc phải làm lại.
Bài tập 10-7 · Thiết kế toàn diện: tỷ trọng giai đoạn RL và thông lượng mẫu hiệu dụng
Gọi tốc độ xử lý của các giai đoạn generation, verification và learning lần lượt là 12, 6 và 8 chuỗi/s, với tỷ lệ giữ mẫu sau xác minh là 75%; so sánh lợi ích của việc nhân đôi dung lượng chỉ một giai đoạn tại một thời điểm. Cũng áp dụng một mô hình chu kỳ với 40 s generation, 16 s learning và 4 s đồng bộ weight. Giả định số mẫu sinh ra mỗi batch là một hằng số như nhau trong suốt, tính thông lượng mẫu hiệu dụng dưới thực thi bất đồng bộ khi tỷ lệ giữ mẫu là 80% và 70%, và so sánh với thực thi đồng bộ không loại mẫu; kết quả có thể được biểu thị là phần một batch được xử lý mỗi giây. Với phần thí nghiệm, truy vết định danh, reward, vị trí loss hiệu dụng và weight của bên nhận của một batch mẫu.
Bài tập 10-8 · Phân tích: bản ghi routing và sự tương ứng của nó với các mẫu
Giả sử một chuỗi chứa 8K token, model có 48 layer, và mỗi layer chọn 8 expert cho mỗi token. Tính dung lượng bản ghi cần thiết dùng mã hóa uint16 và int32 cho các ID expert. Sau khi packing hai chuỗi lại với nhau rồi chia chúng theo ngữ cảnh thành bốn phần, mô tả các ID expert bị sắp xếp lại cùng với các token như thế nào. Dựng một ví dụ trong đó vị trí của một token bị lệch, giải thích phía training khi đó sẽ dùng sai expert ra sao, và thiết kế một phép kiểm tra để định vị lỗi này.
Bài tập 10-9 · Phân tích: truyền thông, hiệu quả tính toán và chờ dữ liệu vào ảnh hưởng hạn chót training như thế nào
Trong tình huống thiết kế 48 thẻ của chương này, giảm riêng một nửa băng thông PCIe (xét cả trường hợp nạp trước vẫn hiệu quả lẫn trường hợp hỏng hoàn toàn), hạ hiệu quả tính toán mỗi thẻ xuống 30%, và nâng chờ dữ liệu vào lên 5 s; tính lại thời gian hoàn thành training trong từng trường hợp, và đánh giá hạn chót có còn được đáp ứng hay không. Sau đó thêm biến động độc lập với độ lệch chuẩn 5% vào thời gian tính toán của mỗi thẻ, tìm thời gian mỗi bước dự kiến cho sơ đồ 48 thẻ, và đánh giá sơ đồ này có còn đạt hạn chót hay không. Giả định mọi suy giảm trên xảy ra đồng thời, nhưng tài nguyên thêm chỉ có thể khôi phục một trong số chúng về giá trị gốc, hãy so sánh lượng thời gian đường tới hạn có thể thu lại được khi khôi phục từng hạng mục riêng lẻ. Sau đó chọn một thông số kỹ thuật phần cứng hoặc một bản ghi thực thi, và thay một trong các đầu vào đã cho của chương này bằng một giá trị có nguồn gốc.
Bài tập 10-10 · Thiết kế toàn diện: cần bao nhiêu accelerator, và với chi phí nào, để đáp ứng một hạn chót training
Với các model dense có số tham số 1T, 5T và 10T, dùng để tính compute training dưới hai chế độ khối lượng dữ liệu: dữ liệu training cố định ở 20T token; và số token training thỏa mãn . Sau đó, ở các mức MFU 40% và 50%, tìm số thẻ A100, H100 và B200 tối thiểu cần để hoàn thành training trong 90 ngày và 180 ngày cho từng trường hợp. So sánh, theo tổng GPU-hours, hai sơ đồ đều đáp ứng hạn chót, và giải thích thời gian chuẩn bị cùng các tham số phục hồi sẽ thay đổi kết luận như thế nào. Với phần thí nghiệm, chọn một log công khai đánh dấu điểm bắt đầu phục hồi của nó, trừ đi số token đã hoàn thành tại thời điểm phục hồi, và tính tốc độ xử lý trung bình của các token mới được huấn luyện trong khoảng quan sát.
Chú thích nguồn
- Critical batch size: Tính toán lại critical batch size và so sánh với thang nhiễu hai mươi triệu token. Định nghĩa gradient noise scale được cho trong Phương trình (2.8) của mô hình thực nghiệm cho training batch lớn; quan hệ số bước với số mẫu, Phương trình (5.1), định nghĩa critical batch size, Phương trình (5.2), và khoảng một đến hai triệu token lúc hội tụ được cho trong bài báo Scaling Laws. là giá trị dùng trong ví dụ này và chưa được đo trên model của chương này; cả weak scaling lẫn strong scaling đều không bao gồm sự thay đổi hiệu quả song song hóa.
- Độ chính xác: Bài báo training độ chính xác hỗn hợp (cơ chế loss scaling, các thừa số scaling từ 8 đến 32K, phạm vi biểu diễn FP16), bài báo về các định dạng FP8 (mã hóa E4M3/E5M2 và các giá trị chuẩn lớn nhất), báo cáo kỹ thuật DeepSeek-V3 §3.3 (scaling khối activation và khối weight , nâng lên tích lũy FP32 mỗi 128 phần tử, sai số loss tương đối dưới 0,25%). So sánh số mũ và phần định trị giữa FP16 và BF16 được cho trong Mục 4.6.1.
- Các lịch trình pipeline: Mô hình sự kiện interleaved, mô hình sự kiện zero-bubble, mô hình sự kiện DualPipe, và các biến thể mười sáu micro-batch (interleaved, zero-bubble, DualPipe). Các công thức bubble: 1F1B và interleaved được cho trong bài báo Megatron-LM ( và ); ZB-H1/H2 được cho trong Bảng 2 của bài báo zero-bubble; số tham số và cách chia activation cho DualPipe được cho trong Bảng 2 của báo cáo kỹ thuật DeepSeek-V3; định nghĩa trạng thái ổn định cho 1F1B được cho trong PipeDream. Thứ tự slot của zero-bubble theo nửa trên của Hình 3 trong bài báo cho ZB-H1; với các sơ đồ interleaved và DualPipe, văn bản lưu trữ chỉ cho các ý tưởng chia khối và cấp hai chiều, và thứ tự slot theo declared_schedule_rule ghi trong từng file kết quả; tỷ lệ chia ms là giá trị dùng trong ví dụ này; các thời gian hoàn thành được suy ra từ mô hình sự kiện theo các phụ thuộc, không phải đo được.
- Dung lượng expert: Capacity factor và tính lại drop. Quy tắc dung lượng được cho trong Phương trình (3) của Switch Transformer (dung lượng mỗi expert = token mỗi batch / số expert × capacity factor) và trong GShard (dung lượng lấy là O(N/E), với biểu diễn của token tràn được truyền sang layer tiếp theo qua kết nối dư); cân bằng dựa trên bias không auxiliary loss được cho trong báo cáo kỹ thuật DeepSeek-V3. Phân phối trong đó nửa số expert nóng gấp 1,5x là giá trị dùng trong ví dụ này, cho cùng tỷ lệ 3:1 như ví dụ 96/32 trong văn bản chính.
- Straggler: Mô hình cực đại straggler (σ là 2% trung bình) và (σ là 5% trung bình). Quan sát khoảng 0,5% máy chậm rõ rệt được cho trong MegaScale; thời gian trung bình giữa các sự cố 7,9 giờ cho công việc 1024 thẻ và 47,7 ngày cho công việc 8 thẻ được cho trong bài báo độ tin cậy cluster Meta, và tỷ lệ sự cố mỗi thẻ trong mục chu kỳ lưu được chuyển trực tiếp từ con số 7,9 giờ của 1024 thẻ. Độ lệch chuẩn thời gian tính toán mỗi thẻ và khoảng quay lui do loss spike là các giá trị dùng trong ví dụ này; cực đại dự kiến thu được bằng tích phân số dựa trên thống kê thứ tự, không mô hình hóa tương quan, chập chờn định kỳ hay thẻ chậm dai dẳng.
- Trạng thái training: Tham số chính thức và tính lại trạng thái Adam/ZeRO; biến thể gradient FP32. Chương này dùng biểu diễn trạng thái năm hạng mục đã chỉ định; các optimizer khác và trạng thái độ chính xác thấp phải được tính riêng.
- Hạn chót và cận dưới thiết bị: Hạn chót training và cận dưới thiết bị và biến thể theo thời gian lịch. Độ chính xác, độ thưa và nguồn phần cứng được ghi từng mục trong JSON. Các con số MFU BF16 38%–43% được cho trong §3.3.2 và Bảng 4 của báo cáo Llama 3; giao diện PCIe 4.0 và việc RTX 4090 không có NVLink được cho trên trang thông số RTX 4090.
- FSDP: Bản ghi FSDP2 CPU bốn cấu hình. Bốn cấu hình trên model CPU nhỏ cho tham số nhất quán với kết quả tham chiếu không shard; bộ nhớ đỉnh cấp phát trong training là 39,16/30,14 MiB.
- Pipeline và recomputation: Mô hình sự kiện fill-drain, mô hình sự kiện 1F1B, quan hệ giữ lại cho các tensor đầu vào GEMM, recomputation có chọn lọc. Các đầu vào GEMM dùng biểu diễn tham chiếu FP32; các tích có thể dựng lại cho chín layer tổng cộng 90 MiB, với tập làm việc dựng lại tối đa mỗi layer là 6 MiB. Sơ đồ pipeline dùng các kết quả trung gian được lưu bởi chiến lược save_nonlinear và các buffer gửi/nhận của chúng.
- Offload chuyển đổi: Tính toán lại chuyển đổi gradient, biến thể liên kết nhanh, tình huống đọc và chuyển đổi SuperOffload, bản ghi offload CPUAdam. Đường chuyển đổi bắt đầu từ lúc gradient sẵn sàng trên GPU và kết thúc với gradient FP32 đọc được trên CPU; cả hai đường đều dùng bộ nhớ host khóa trang (page-locked) làm buffer. Thông lượng chuyển đổi GPU dùng băng thông bộ nhớ 1008 GB/s của RTX 4090 (calculations/configs/hardware.json); thông lượng chuyển đổi CPU dùng DDR5-4800 tám kênh từ thông số Xeon Platinum 8480+, B GB/s; cả hai đều là cận trên tính từ băng thông bộ nhớ. NVLink-C2C ở 450 GB/s mỗi hướng được ghi trong mô tả kiến trúc GH200.
- MegaScale và tăng tốc mở rộng: Bài báo báo cáo độ trễ mỗi bước 23,66/6,34 s, với hiệu quả mở rộng khoảng 93,3%; điều này tương ứng với thí nghiệm mở rộng toàn hệ thống với global batch size cố định. Bài báo MegaScale chính thức và nhiệm vụ cố định, cấu hình lịch sử và ghi chú đo.
- MoE và truyền thông: Báo cáo kỹ thuật DeepSeek-V3, tình huống trao đổi expert và gộp bucket backward. 72 MiB chia thành ba bucket, ring AllReduce bốn thành viên, khởi động 0,02 ms và ba khoảng trống 2 ms là các đầu vào đã cho; cấu hình một NIC 200 Gbit/s mỗi thẻ được cho trong phân tích cấu hình cluster 4090, và 400 Gbit/s được cho trong datasheet ConnectX-7. Cân bằng tải và cơ chế routing expert theo DeepSeek-V3; lập lịch chia khối theo tình huống được liên kết.
- Độ dài và khối lượng tính toán: Ước lượng khối lượng công việc training và phân phối độ dài.
- Dữ liệu vào và lưu trữ dùng chung: Mô hình dữ liệu vào training và lưu trữ dùng chung, thí nghiệm dữ liệu vào và lưu cùng tồn tại. Mô hình sự kiện dùng các tham số quy mô nhỏ để minh họa hàng đợi nạp trước bị cạn khi checkpoint và dữ liệu vào chia sẻ lưu trữ; tình huống thiết kế trong chương này dùng bốn tiến trình chuẩn bị dữ liệu, mỗi tiến trình chuẩn bị hai chuỗi/s.
- Checkpoint và shard lại: Bố cục checkpoint, ByteCheckpoint và đọc lưu nền, tính toán shard lại logic, dòng thời gian 112 GB.
- Phục hồi dữ liệu: Bản ghi phục hồi DCP, phục hồi pipeline văn bản thực. Con số 2.000+6.192 là một ví dụ giảng dạy minh họa token thừa trong packing. Model nhỏ DCP khôi phục hai bản sao shard hàng thành ba bản sao shard cột cộng trạng thái đầy đủ; tham số, trạng thái Adam, trạng thái ngẫu nhiên và kết quả cập nhật tham số tiếp theo khớp với training không gián đoạn.
- Lưu bất đồng bộ và sự cố: Thí nghiệm lưu bất đồng bộ và sự cố trước commit và so sánh không-lưu/đồng bộ/bất đồng bộ. API đường bình thường gốc mất khoảng 7,25 ms, với commit siêu dữ liệu khoảng 48,30 ms; thí nghiệm sự cố đặt một barrier trước commit và kết thúc tiến trình.
- Chu kỳ lưu: Chu kỳ lưu và mô hình retry Poisson. Khối lượng dữ liệu chính xác là 114.670.295.040 byte; ở tốc độ ghi 7 GB/s, chi phí lưu khoảng 16,381 s; điểm tối ưu bậc nhất khoảng 965,29 s, và mô hình retry Poisson gồm cả sự cố trong lúc lưu cho khoảng 954,40 s. Con số 7 GB/s là thông lượng ghi gộp của một SU duy nhất trong bậc Good của Bảng 6 trong kiến trúc tham chiếu DGX SuperPOD; một công việc 1024 thẻ bị gián đoạn trung bình mỗi 7,9 giờ một lần, và thời gian trung bình giữa các sự cố tỷ lệ nghịch với số thẻ, theo bài báo độ tin cậy cluster Meta. Lựa chọn trong chương này chỉ cần phân biệt năm, mười lăm và ba mươi phút.
- verl và vLLM: Vòng kín thực model nhỏ verl cố định, xác minh mã nguồn của loss và cập nhật. Cấu hình training cố định Qwen2.5-0.5B-Instruct dùng single-card NO_SHARD với no_sync=False; mã nguồn và khóa phiên bản được ghi trong tài liệu được liên kết. 0,32/0,30/0,04 được suy ra dùng cấu trúc độ dài thực với một loss vô hướng giảng dạy.
- Chuyển giao weight: Đỉnh thiết bị dùng chung Qwen3-8B, đồng bộ weight shard Qwen3-235B-A22B. 40 GiB là đầu vào đã cho cho vết bộ nhớ GPU sau sharding/offloading; hai đỉnh chuyển đổi chính xác khoảng 83,256/59,256 GiB, so với danh nghĩa 80 GB (74,506 GiB) của H100 SXM.
- OPD: Báo cáo kỹ thuật DeepSeek V4, §5.1 về expert theo miền và OPD đa giáo viên; phân chia công việc giai đoạn theo Chương 3.
- Trạng thái RL và tính tái lập: Trạng thái RL, tỷ số xác suất và phiên bản, báo cáo kỹ thuật DeepSeek V4.
- Routing replay: Ngân sách siêu dữ liệu routing, log và phân tích do tác giả R3 công bố. Bốn cấu hình ghép cặp dùng chung seed42; reward là một chỉ số mức batch training, còn logprob là một thống kê mức log từ các tác giả R3.
- Quy mô dense và hạn chót: Quy mô dense và hạn chót, biến thể với khối lượng dữ liệu mở rộng tỷ lệ với tham số. Ở 16.384 H100, DP=128 và độ dài chuỗi 8K, MFU BF16 41% được báo cáo trong Bảng 4 của báo cáo Llama 3.
- Bản ghi training công khai: Xác minh bản ghi training gốc SmolLM3. Bản ghi SmolLM3 gồm các giai đoạn rank ở 384, 288 và 192, với lần tiếp tục cuối thực sự chạy 14.000 bước; số token tích lũy tại điểm cuối gồm cả công việc trước đó.
- Tình huống thiết kế: Đầu vào, suy dẫn và tính lại cho tình huống thiết kế của chương này. Dự trữ dung lượng, chờ dữ liệu vào và tạm dừng theo kế hoạch cho 32/48 thẻ là các đầu vào đã cho; hiệu quả tính toán mỗi thẻ dùng MFU của Llama 3; công việc ma trận của model đến từ phép tính hạn chót training sẵn có, và khối lượng truyền thông ZeRO-3 được suy ra từ cùng bảng tham số. PCIe 4.0 không NVLink của RTX 4090 được cho trong trang thông số RTX 4090; việc không hỗ trợ P2P giữa các thẻ và tám NIC 200 Gbit/s mỗi host tám thẻ được cho trong phân tích cấu hình cluster 4090; trong một bước, chỉ AllGather đầu tiên và ReduceScatter cuối cùng không thể bị che, theo MegaScale §3.2. Các giá trị chi tiết và tính lại độc lập được lưu trong design-case.json.
- DeepSeek V4.1: Báo cáo kỹ thuật chính thức DeepSeek V4.1, các mục 1, 2, 3 và 6; điều kiện cố định và tính lại qua các phiên chương.
Tóm tắt chương
Dung lượng bộ nhớ cần cho training được quyết định chung bởi định dạng lưu trữ của trạng thái, cách phân bổ của nó trên các thẻ, và vòng đời của nó. ZeRO giảm sự nhân bản trạng thái, recomputation giảm dữ liệu phải được lưu giữa forward và backward pass, và offloading chuyển trạng thái training tạm thời không dùng sang bộ nhớ host; cả ba đều đổi tính toán hoặc truyền thêm lấy không gian bộ nhớ GPU. Khi thực thi, độ sẵn sàng của dữ liệu và tính sẵn có của tài nguyên cùng nhau quyết định thời điểm bắt đầu, và độ trễ tích lũy dọc theo chuỗi phụ thuộc cho tới lúc cập nhật tham số kết thúc quyết định độ trễ mỗi bước.
Khi ước lượng thời gian hoàn thành dài hạn, người ta còn phải cộng thời gian chuẩn bị dữ liệu, lưu checkpoint và thử lại sau sự cố không nằm trong độ trễ mỗi bước. Một checkpoint lưu cả trạng thái optimizer lẫn vị trí của dữ liệu training đã hoàn thành; chu kỳ lưu cân chi phí ghi trong vận hành bình thường với chi phí thử lại sau sự cố. Training đồng bộ còn bị ảnh hưởng bởi ba yếu tố thực tế: batch size có thể mở rộng theo số thẻ hay không được quyết định bởi critical batch size, độ trễ mỗi bước được quyết định bởi thẻ chậm nhất, và tỷ lệ quay lui từ loss spike đi vào mô hình chu kỳ lưu cùng với tỷ lệ sự cố phần cứng. RL còn đòi hỏi truy vết định danh mẫu, phiên bản policy và xác suất hành vi, và căn chỉnh các đường tính toán của generation và training. Lấy mẫu online làm cho dữ liệu theo policy đang thay đổi, OPD để sự giám sát của giáo viên bao phủ các tiền tố mà học sinh thực sự sinh ra, và thực thi xuyên engine cũng phải đảm bảo training-serving consistency. Một khi sự lệch phân phối dữ liệu và sai số thực thi được kiểm soát, người ta có thể đánh giá việc chồng lấp giai đoạn tăng tốc learning nhanh đến đâu dựa trên thông lượng mẫu hiệu dụng và đánh giá nhiệm vụ.
Trong tình huống thiết kế của chương này, cả hai cấu hình RTX 4090 32 thẻ và 48 thẻ đều có thể chứa trạng thái training, nhưng với cùng mục tiêu training và hiệu quả thực thi, thời gian hoàn thành lần lượt khoảng 34,3 ngày và 24,6 ngày. Cấu hình 48 thẻ đáp ứng hạn chót 30 ngày, với cận trên thời gian training mỗi bước khoảng 67,2 s; thời gian liên kết ZeRO-3 mỗi bước 12,0 s phần lớn được tính toán che phủ, và kể cả khi bị lộ hoàn toàn cũng không vượt cận trên này. Kết luận này đến từ một chuỗi suy dẫn liên tục về dung lượng, thực thi và phục hồi; chính mô hình phân tích này cũng cho các giá trị tới hạn tại đó sơ đồ có hoặc không thể đáp ứng hạn chót khi hiệu quả, truyền thông và điều kiện sự cố thay đổi.