Chương 8 · Tối ưu Inference
Kỹ thuật tối ưu inference: batching, quản lý bộ nhớ KV, offload, lượng tử và speculative decoding — hiệu quả khi nào và chi phí ra sao.
~85 phút đọc · Thuật ngữ
Tối ưu Inference
Cùng một model chạy trên cùng một accelerator có thể chỉ trả về vài chục token mỗi giây cho một người dùng, nhưng lại đạt tổng thông lượng hàng nghìn token mỗi giây trên toàn bộ người dùng. Điều này xảy ra vì nhiều request có thể được tính toán cùng lúc, chia sẻ một lần đọc trọng số (weights). Đồng thời, độ dài context, thời gian xếp hàng và thứ tự thực thi của mỗi request quyết định thời điểm người dùng thực sự nhận được câu trả lời. Chương này thảo luận cách tổ chức các request này sao cho trả về nhiều câu trả lời đúng hơn trong một ngân sách thời gian cho trước.
Một instance inference có thể chạy trên một card đơn, hoặc được thực thi đồng thời bởi nhiều card hoặc nhiều server. Chương 6 và 7 đã giải thích cách phép tính của model được tách nhỏ và cách các accelerator giao tiếp với nhau. Chương này lấy một tổ hợp accelerator cho trước làm điểm xuất phát và nghiên cứu batching (gom lô), lập lịch request, quản lý bộ nhớ, nén, offload và giải mã phỏng đoán (speculative decoding), so sánh hiệu quả thực thi của các cấu hình runtime khác nhau. Chương 9 sau đó thảo luận về nơi nên phân bổ tính toán và trạng thái, cách tổ chức các bản sao hoàn chỉnh, các nhóm dịch vụ phân tầng và phân công lao động theo toán tử, cùng cách xác định quy mô dịch vụ tương ứng.
Chương này bắt đầu từ một bài toán thiết kế cụ thể. Ví dụ instance Qwen3-8B chạy trên một GPU RTX PRO 6000 Blackwell Workstation Edition: 96 GB bộ nhớ GPU, băng thông 1792 GB/s, đỉnh dày đặc 503.8 TFLOP/s với đầu vào BF16 và tích lũy FP32, giới hạn công suất 600 W. Ngoại trừ Thí nghiệm 8-7 chạy trên Apple M2 Max, tất cả các thí nghiệm trong chương này đều chạy trên card này. Trọng số model dùng định dạng dấu phẩy động BF16 với 2 byte mỗi phần tử, chiếm khoảng 15.3 GiB. KV cache lưu khóa (K) và giá trị (V) của các token context, phục vụ cho các lần đọc sau này trong quá trình tính toán attention. Như trong Thí nghiệm 8-9, instance này được cấp 32 GiB bộ nhớ GPU, trong đó 12 GiB dành riêng cho KV cache và các buffer phụ trợ, phần còn lại khoảng 4.7 GiB dùng cho activations, các buffer cố định của tái phát đồ thị tính toán (computation graph replay) (Mục 5.5) và các không gian làm việc thực thi khác.
Instance xử lý hai loại request: hội thoại ngắn với đầu vào 2048 token, và các request context dài với đầu vào 8192 token; cả hai đều xuất ra 256 token. 6144 token đầu tiên của request dài là một system prompt và các định nghĩa công cụ (tool) giống hệt nhau. Mỗi request phải trả về một câu trả lời đầy đủ và đúng trong vòng 7 giây kể từ khi đến. Một request ngắn chạy một mình trên card này mất khoảng 6.95 giây (Mục 8.1.1), chỉ chừa lại khoảng 0.05 giây biên so với hạn chót này. Các điều kiện này sẽ được sử dụng lặp lại trong phần sau.
| Điều kiện thiết kế | Hội thoại ngắn | Context dài |
|---|---|---|
| Độ dài đầu vào | 2048 token | 8192 token |
| Độ dài đầu ra | 256 token | 256 token |
| Độ dài tiền tố chung | 0 | 6144 token |
| Hạn chót hoàn thành | 7 s | 7 s |
Trước tiên chúng ta tính xem instance có thể đồng thời chứa KV cache tương ứng với bao nhiêu request, sau đó tính xem một batch lớn hơn tiết kiệm được bao nhiêu lượng đọc trọng số cho mỗi token đầu ra. Tiếp đó chúng ta giới thiệu paging, chia sẻ tiền tố, nén, offloading và giải mã phỏng đoán, phân tích từng kỹ thuật tiết kiệm được gì và thêm vào chi phí gì. Ở cuối chương, các phân tích này được áp dụng cho một câu hỏi duy nhất: nên chọn cấu hình nào khi 16 request dài đến đồng thời?
8.1 Quá trình thực thi và yêu cầu tài nguyên của các request inference
8.1.1 Tài nguyên thực thi và vòng đời của request
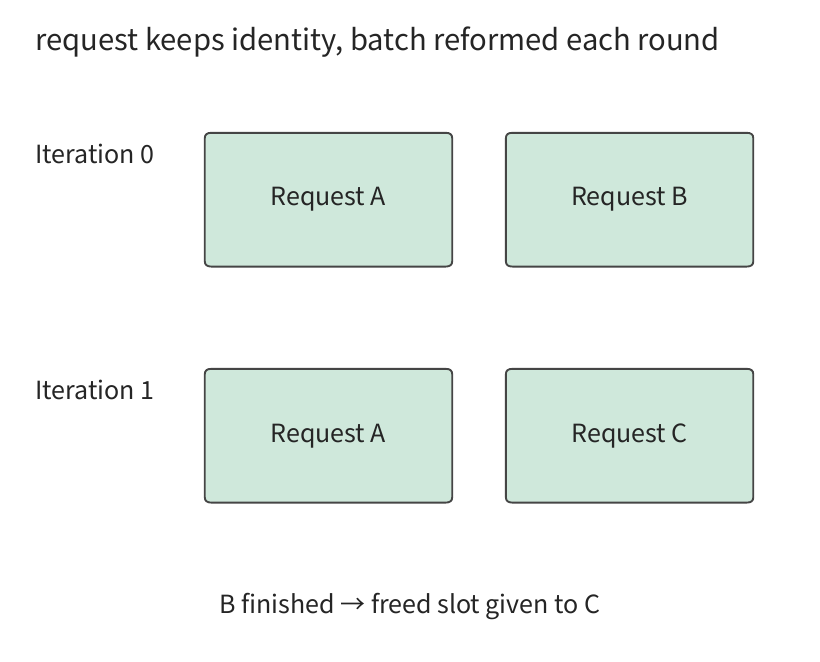
Một request là một đơn vị công việc inference có đầu vào, đầu ra và điều kiện hoàn thành riêng. Batch được thảo luận trong chương này đề cập đến nhóm các token đầu vào được tính toán cùng nhau trong một lần thực thi trên accelerator; một vòng lập lịch (scheduling iteration) là một chu kỳ trong đó bộ lập lịch (scheduler) chọn công việc của vòng hiện tại, đệ trình để thực thi và xử lý kết quả. Một request có thể trải qua nhiều vòng lặp, và các request khác được gom vào cùng batch với nó có thể thay đổi từ vòng này sang vòng khác.
Sau khi một request đến, nó trước tiên đi vào hàng đợi chờ. Chỉ sau khi bộ lập lịch thêm nó vào một batch và cấp không gian KV, model mới bắt đầu xử lý đầu vào — giai đoạn prefill. Vì các token đầu vào được cung cấp toàn bộ ngay từ đầu, model có thể tính toán nhiều token cùng một lúc và lưu khóa cùng giá trị của từng layer. Sau khi token cuối cùng của prompt được tính xong, model sinh ra token đầu ra đầu tiên.
Instance sau đó chuyển sang giai đoạn decode. Model lấy token vừa sinh ra làm đầu vào cho lượt lan truyền tiếp theo, đọc context KV và sinh token tiếp theo. Một request phải thực hiện các bước này một cách tuần tự, nhưng các bước hiện tại của các request khác nhau có thể được tính toán cùng nhau. Vì vậy dù một request chỉ có thể sinh token từng cái một, một instance vẫn có thể tăng tổng thông lượng bằng cách gom lô (batching).
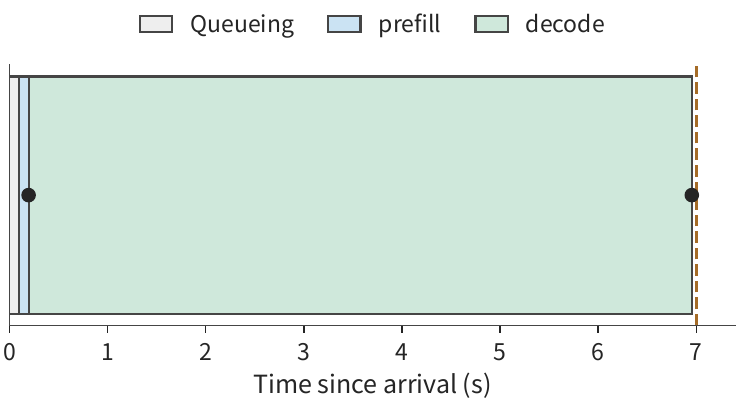
Trên card này, Thí nghiệm 8-1 chạy đơn lẻ một request ngắn đầu vào 2K: prefill và trả về token đầu tiên mất khoảng 0.096 giây, sau đó trung bình mỗi 26.5 ms trả về một token. Giả sử request này chờ xếp hàng 0.1 giây đầu tiên, người dùng nhận được token đầu tiên sau 0.196 giây kể từ lúc đến. Với tổng cộng 256 token đầu ra, có 255 khoảng đầu ra, nên tổng thời gian của request là
Request này hoàn thành trong 7 giây. Nếu prefill của một request ngắn khác được chèn vào giữa quá trình sinh, một khoảng đầu ra phải chờ thêm khoảng 0.096 giây, kéo dài từ 26.5 ms lên khoảng 123 ms, và tổng thời gian tăng lên 7.05 giây. Phép tính cho mỗi token hoàn toàn không thay đổi — chỉ cần sắp xếp lại thứ tự thực thi cũng có thể đẩy một request vượt qua hạn chót của nó.
Hình 8-2 vẽ 6.95 giây này thành một trục thời gian. Khoảnh khắc token đầu tiên được trả về chia trục thời gian thành hai đoạn: mọi thứ trước nó — xếp hàng và xử lý đầu vào — quyết định khi nào người dùng thấy phản hồi, và 255 khoảng sau nó quyết định khi nào người dùng nhận được câu trả lời hoàn chỉnh. Mọi tối ưu hóa lập lịch được thảo luận sau này đều có thể được hiểu là làm thay đổi độ dài của một trong hai đoạn này.
Khi một request hoàn thành, bộ lập lịch không còn lập lịch tính toán cho nó, và trình quản lý trạng thái quyết định xử lý KV để lại như thế nào. KV chỉ riêng của request đó được giải phóng khi request kết thúc, trong khi KV của một tiền tố chung được chia sẻ có thể được giữ lại để tái sử dụng cho các request sau, tiếp tục được quản lý theo chính sách cache. Mục 8.3 giải thích thêm khi nào cache này được chia sẻ và khi nào nó được giải phóng.
8.1.2 Yêu cầu dung lượng lưu trữ đối với trọng số, KV và các buffer runtime
Để đẩy nhiều request tiến triển theo trục thời gian riêng, một instance phải đồng thời giữ trọng số, trạng thái request và các kết quả tính toán trung gian. Ví dụ trong mục này dùng một card đơn, nên chỉ liệt kê footprint bộ nhớ trên chính card này. Một instance nhiều card phải liệt kê riêng các mảnh trọng số (weight shards), KV và buffer được giữ trên từng card: bộ nhớ trống trên một card chỉ có thể được dùng cho phép tính trên card khác nếu vị trí dữ liệu được thay đổi.
Gọi là dung lượng của trọng số thường trú, là tổng dung lượng khối KV vật lý sau khi khử trùng lặp các tham chiếu được chia sẻ (KV được cấp theo các khối kích thước cố định, và các khối được nhiều request chia sẻ chỉ được đếm một lần), là dung lượng của activations và không gian làm việc chung, và là dung lượng của các buffer khác như tái phát đồ thị tính toán. Tổng các footprint bộ nhớ này phải nhỏ hơn hoặc bằng dung lượng khả dụng của accelerator:
Trong số các footprint bộ nhớ này, trọng số được nạp vào bộ nhớ trước khi bất kỳ request nào đến, trong khi KV tiếp tục tăng khi các request đến và sinh đầu ra. Để xác định instance có thể xử lý đồng thời bao nhiêu request, trước tiên ta tính mỗi token cần lưu bao nhiêu KV. Qwen3-8B có 36 layer, 8 KV head mỗi layer, và chiều head là 128. Mỗi token phải lưu K và V tại mọi layer, và BF16 dùng 2 byte mỗi phần tử, nên dung lượng KV cần thiết mỗi token là
Đầu vào 2048 token chiếm 288 MiB KV; đầu vào 8192 token chiếm 1152 MiB. Tất cả các request chia sẻ khoảng 15.3 GiB trọng số, nhưng mỗi request dài bổ sung với context độc lập thêm 1.125 GiB KV. Mười sáu request dài chỉ riêng để giữ KV đầu vào đã cần 18 GiB, vượt quá 12 GiB dành riêng.
KV tiếp tục tăng khi đầu ra được sinh ra. Prefill tạo ra token đầu ra đầu tiên, sau đó 255 token đầu ra trước đó được đưa ngược vào model từng cái một để sinh 255 token còn lại. Một request ngắn tính tổng cộng token, và một request dài tính tổng cộng token. Với 16 token mỗi khối, chúng cần không gian được cấp để chứa lần lượt 2304 và 8448 token.
| Request độc lập | KV sau prefill | KV được cấp sau 256 token đầu ra | Số request khớp trong 12 GiB đồng thời |
|---|---|---|---|
| Hội thoại ngắn | 288 MiB | 324 MiB | 37 |
| Context dài | 1152 MiB | 1188 MiB | 10 |
Cột cuối cùng đến từ và tương ứng. Nếu chỉ tính dựa trên kích thước KV tại cuối prefill, 12 GiB có thể chứa 42 request ngắn; nhưng một khi tất cả các request này đã sinh đủ 256 token đầu ra, không gian cần thiết tăng lên 13,608 MiB. Việc dành trước không gian cần cho giai đoạn sinh tại thời điểm request được tiếp nhận giúp tránh phát hiện thiếu hụt bộ nhớ giữa chừng quá trình thực thi.
Chia sẻ một tiền tố chung có thể tiết kiệm thêm bộ nhớ. 6144 token đầu tiên của một request dài chiếm 864 MiB KV, và phần đầu vào còn lại chiếm 288 MiB. Nếu 16 request mỗi cái lưu bản sao tiền tố của riêng mình, 16 bản sao KV giống hệt nhau được lưu; nếu chúng thay vào đó tham chiếu cùng một KV, không gian tiết kiệm được có thể dùng cho phần hậu tố riêng của từng request. Mục 8.3 sẽ mô tả sơ đồ ánh xạ khối cụ thể và tính tổng dung lượng tại cuối giai đoạn sinh.
8.1.3 Từ thời gian của một request đến các mục tiêu dịch vụ
Bây giờ chúng ta chuyển hai đoạn của trục thời gian trong Mục 8.1.1 thành các chỉ số có thể dùng để đặt hạn chót. Gọi là thời điểm request đến, là tổng số token đầu ra, và , là các thời điểm token đầu tiên và cuối cùng được trả về cho người dùng. Khi đó
và khoảng đầu ra thứ là . Cộng thời gian trước và sau token đầu ra đầu tiên, tổng thời gian của request là
Trong ví dụ ở Mục 8.1.1, TTFT là 0.196 giây, và 255 khoảng đầu ra tiếp theo tổng cộng 6.76 giây. TTFT ngắn hơn giúp người dùng thấy phản hồi sớm hơn, các khoảng đầu ra đều đặn giúp việc đọc liên tục dễ dàng hơn, và tổng thời gian quyết định khi nào câu trả lời hoàn chỉnh có sẵn. Một SLO biến các yêu cầu này thành các hạn chót. Ví dụ mở đầu của chương này yêu cầu tổng thời gian không vượt quá 7 giây; các ví dụ lập lịch dưới đây cũng sẽ so sánh khoảng đầu ra dài nhất.
Các chỉ số này áp dụng cho một request; đầu ra tổng thể của instance cũng phụ thuộc vào số request được xử lý cùng lúc — batch size (sau đây gọi là batch). Thông lượng là lượng công việc hoàn thành trong một đơn vị thời gian. Khi Thí nghiệm 8-1 xử lý đồng thời 16 request 2K, mỗi vòng decode mất khoảng 27.44 ms và tạo ra 16 token mỗi vòng, cho thông lượng sinh khoảng token/s; khi một request đơn tạo ra một token mỗi 26.26 ms, giá trị này chỉ khoảng 38. Tăng số đầu ra mỗi vòng hoặc rút ngắn thời gian mỗi vòng đều làm tăng thông lượng; người dùng thực sự phải chờ bao lâu còn phụ thuộc vào thời gian xếp hàng trước khi request bắt đầu thực thi.
Đánh giá chất lượng dịch vụ cũng đòi hỏi kiểm tra xem câu trả lời có đúng không. Cố định độ dài đầu ra giúp so sánh thời gian thực thi dễ hơn trong cùng khối lượng công việc; để model dừng tự nhiên thay vào đó cho phép quan sát độ đúng của câu trả lời, độ dài phản hồi và số lần thử lại. Mục 8.6 tính số request hoàn thành đúng và đúng hạn trong một đơn vị thời gian, đánh giá chung cả tốc độ lẫn chất lượng.
8.2 Batching và lập lịch request
8.2.1 Việc tái sử dụng trọng số cải thiện hiệu quả batching như thế nào
Xét phép nhân ma trận , với ma trận đầu vào có hàng. Cùng một phần tử trọng số tham gia vào phép tính cho mọi hàng, nên xử lý nhiều hàng cùng nhau cho phép hoàn thành nhiều phép nhân-cộng hơn cho mỗi lần đọc trọng số. Giả sử mỗi phần tử trọng số chỉ được đọc một lần mỗi batch, mỗi phép nhân-cộng tính là hai phép toán, và mỗi phần tử trọng số chiếm byte. Chỉ tính riêng lượng đọc trọng số, cường độ số học (arithmetic intensity) là
Với BF16, . Tăng số request cùng thực thi một bước decode từ 1 lên 16 — mỗi request cung cấp một token mới, và vector đặc trưng của mỗi token tạo thành một hàng của ma trận đầu vào — làm ma trận lớn lên từ một hàng thành 16 hàng, nên lượng công việc thực hiện trên mỗi lần đọc trọng số tăng lên 16 lần giá trị ban đầu. Các request khác nhau chia sẻ ma trận trọng số, nhưng phép tính attention vẫn phải đọc riêng context KV của từng request.
Điều kiện tiên quyết để chia sẻ là nhóm batch này dùng cùng một bộ trọng số. Low-rank adaptation (LoRA) nới lỏng điều kiện tiên quyết này: nó biểu diễn một hiệu chỉnh trọng số thành tích của hai ma trận nhỏ trong khi giữ nguyên trọng số nền, nên các tác vụ khác nhau có thể chia sẻ một model nền và mỗi tác vụ chỉ gắn thêm một adapter nhỏ (một module tham số huấn luyện được gắn vào model nền). Với projection Q và V của Qwen3-8B, dùng rank thấp chiều 16 và BF16, một adapter chiếm 14.6 MiB, và 100 adapter cùng nhau chiếm 1.43 GiB — nhỏ hơn nhiều so với 14.1 GiB trọng số ma trận.
Nếu một batch gồm các request từ các adapter khác nhau, thứ duy nhất còn được chia sẻ là trọng số nền. Phép tính rank thấp phải được nhóm theo adapter, và số hàng của mỗi nhóm là số request trong batch này thuộc về adapter đó; adapter càng phân tán thì càng ít hàng mỗi nhóm, và khả năng tái sử dụng trọng số cho phần tính toán này càng kém. Vậy nên có bao nhiêu adapter và đặt bao nhiêu request vào một batch là hai quyết định riêng biệt.
Dung lượng cũng phải được tính riêng. 100 adapter chiếm 1.43 GiB, trong khi 100 context 8K không chia sẻ lẫn nhau chiếm tổng cộng 112.5 GiB KV. Bao nhiêu adapter vừa đủ được quyết định bởi các ma trận nhỏ, trong khi bao nhiêu request có thể được phục vụ đồng thời vẫn được quyết định bởi KV; dư địa lớn ở trước không hàm ý dư địa lớn ở sau.
Gọi là kích thước các trọng số ma trận cần đọc chính xác một lần mỗi vòng, mỗi request có token context không chia sẻ KV với nhau, và là dung lượng KV mỗi token. Tổng lượng đọc cho một vòng, và lượng đọc trung bình quy cho mỗi token đầu ra, lần lượt là
Trong lượng đọc mỗi token đầu ra, số hạng thứ nhất là lượng đọc trọng số được phân bổ, và số hạng thứ hai là lượng đọc context KV của request này. Qwen3-8B có khoảng 14.1 GiB, và KV cho context 2K là 0.28125 GiB. Khi batch tăng từ 1 lên 16, lượng đọc trọng số phân bổ cho mỗi token đầu ra giảm xuống còn khoảng 0.88 GiB; khi batch tăng lên 64, nó giảm tiếp xuống khoảng 0.22 GiB. Tại thời điểm này, mỗi token đầu ra đọc nhiều KV hơn trọng số.
Hình 8-3 cho thấy sự thay đổi này. Các vạch liền kề trên trục hoành biểu thị việc nhân đôi batch size, nên số hạng trọng số giảm một nửa mỗi lần; số hạng KV không đổi, và tổng của hai số hạng dần tiến về đường ngang chỉ riêng KV. Với context 2K, khi batch tăng từ 1 lên 64, lượng đọc mỗi token đầu ra giảm từ khoảng 14.38 GiB xuống 0.50 GiB — khoảng 1/29 giá trị ban đầu. Khi độ dài context tăng lên 8K, dung lượng KV trở nên lớn gấp bốn lần, và ngay cả sau batching, mỗi token đầu ra vẫn phải đọc nhiều dữ liệu hơn.
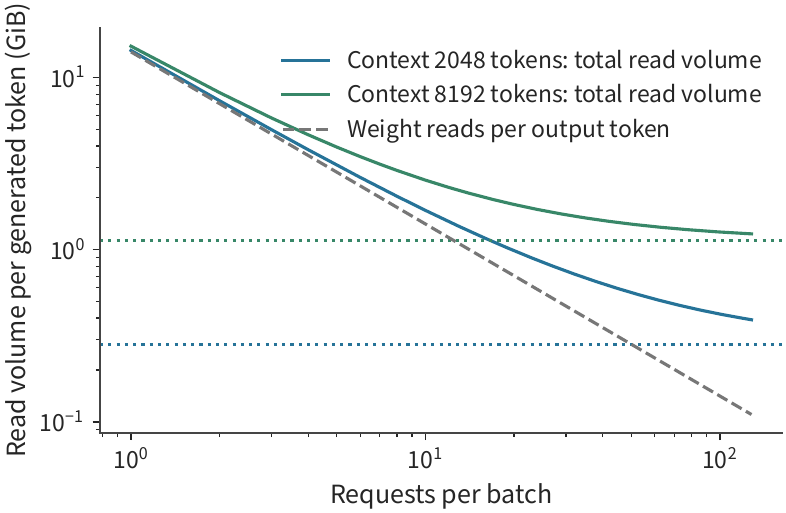
Khi batch tăng, lợi ích từ việc phân bổ trọng số dần giảm đi. Điều này có thể được mô tả bằng batch tại đó lượng đọc trọng số bằng lượng đọc KV. Batch tối thiểu tại đó tổng lượng đọc KV đạt hoặc vượt lượng đọc trọng số dùng chung là
Tính với số byte trọng số chưa làm tròn, kết quả là 51 cho context 2K và 13 cho context 8K. Khi độ dài context tăng gấp bốn lần, lượng đọc KV vượt lượng đọc trọng số ở batch nhỏ hơn nhiều. Đồng thời, batch lớn hơn cũng cần nhiều bộ nhớ hơn: 64 request 2K, cùng với trọng số và KV sau một bước decode, chiếm tổng cộng khoảng 35.7 GB. Batching giảm lượng đọc cho mỗi token đầu ra, nhưng tăng lượng dữ liệu cư trú cùng lúc.
Bây giờ chúng ta ước tính thời gian cần cho các lần đọc này. Gọi là phép tính cho một request, là số phép toán accelerator hoàn thành mỗi giây, và là băng thông bộ nhớ. Tính riêng thời gian cần cho phép tính và cho việc đọc, rồi lấy giá trị lớn hơn trong hai giá trị để ước tính thời gian một vòng:
Đặt hai số hạng bằng nhau và biến đổi cho ta . Mỗi request bổ sung thêm vào thời gian tính toán và vào thời gian đọc KV. Khi số hạng trước lớn hơn, thời gian tính toán tăng theo batch size cho đến khi bắt kịp thời gian đọc; ngược lại, việc đọc vẫn là số hạng tốn thời gian hơn trong suốt quá trình. Các giá trị 51 và 13 ở trên so sánh khối lượng của hai loại dữ liệu được đọc; phương trình này thay vào đó so sánh cách tính toán và băng thông bộ nhớ mỗi loại giới hạn thời gian thực thi như thế nào.
Cả hai số hạng đều được tính bằng đỉnh tính toán và đỉnh băng thông tương ứng, cho cận dưới vật lý của card này trong các điều kiện này. Tỉ số giữa cận dưới này và thời gian đo được của một vòng chính là MFU và MBU được định nghĩa ở Mục 1.2.2; Mục 8.6.3 sẽ dùng các bản ghi từng vòng để hiệu chỉnh hai tỉ số này, rồi áp dụng chúng cho các ví dụ còn lại của chương này.
Việc quy đổi điều này sang thời gian request cũng yêu cầu kiểm tra xem batch lớn hơn có làm trễ token đầu tiên không, và khoảng cách giữa các đầu ra liên tiếp có dài hơn không. Thí nghiệm quét batch ghi lại đồng thời cả hai thay đổi này. Với Qwen3-8B đầu vào 2K và đầu ra 256 token, khi batch tăng từ 1 lên 64, tổng thông lượng tăng từ khoảng 37 lên 1165 token/s; nhưng thời gian trả về token đầu tiên bị trễ từ khoảng 96 ms lên 3.29 giây, và khoảng đầu ra trung bình tăng từ khoảng 27 lên 40 ms. Dù mỗi vòng tạo ra nhiều đầu ra hơn, việc xử lý nhiều đầu vào hơn và chạy batch lớn hơn cũng tốn nhiều thời gian hơn. Trong thí nghiệm này, mỗi batch các request đến cùng lúc; một dịch vụ trực tuyến còn chờ để lấp đầy batch sẽ thêm thời gian chờ này vào độ trễ token đầu tiên.
Bài tập 8-1 · Tính toán: lượng đọc thay đổi thế nào khi batch tăng? Lấy byte và KiB, và tính lượng đọc mỗi token đầu ra cho context 2K và 8K tại các batch size 1, 4, 16 và 64. Với mỗi độ dài context, tìm batch nguyên nhỏ nhất tại đó lượng đọc KV lần đầu đạt hoặc vượt lượng đọc trọng số được phân bổ. Sau đó, dùng 12 GiB bộ nhớ KV khả dụng, 16 token mỗi khối và 256 token đầu ra, tìm số request độc lập tối đa có thể được chứa cho mỗi độ dài context. So sánh số request tối đa này với batch size tại đó hai lượng đọc trở nên bằng nhau, và xác định xem ràng buộc dung lượng có ngăn batch tăng lớn đến mức đó ngay từ đầu hay không.
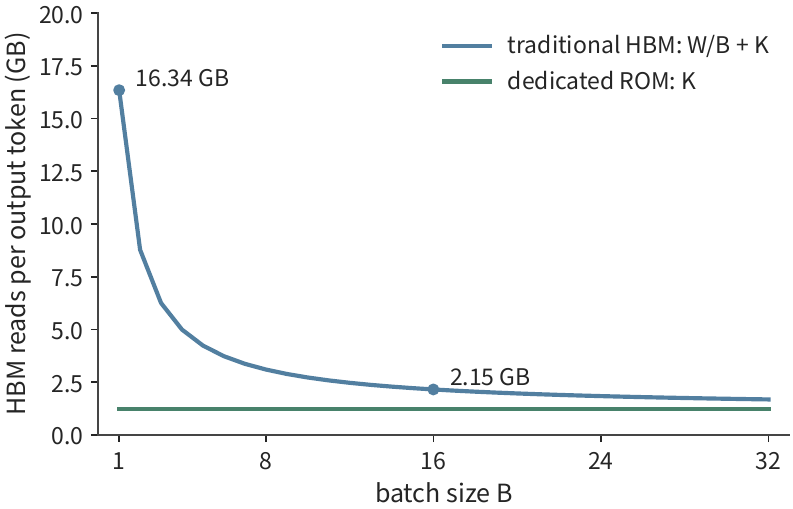
Nếu thay vào đó trọng số được phục vụ từ một bộ lưu trữ độc lập đủ nhanh, thời gian đọc sẽ giảm, và lợi ích của batching cần được tính lại. Theo ví dụ 8K trong Chương 4, gọi là số byte trọng số được đọc trong toàn bộ batch, là số request trong batch, và là số byte KV được đọc cho mỗi request trong bước này. Trong sơ đồ thông thường, lượng đọc HBM được phân bổ cho mỗi token đầu ra là ; khi trọng số được phục vụ từ một ROM độc lập đủ nhanh, HBM vẫn phải đọc cho mỗi token đầu ra. Trong Hình 8-4, khoảng cách giữa hai đường thu hẹp khi batch tăng, cho thấy lợi ích trước đây đạt được bằng cách dùng batch size để pha loãng lượng đọc trọng số đang biến mất.
Tuy nhiên, batch size vẫn ảnh hưởng đến mức độ phép tính ma trận tận dụng các đơn vị tính toán, cũng như lượng đọc KV trong batch. Thay lượng đọc mới vào mô hình thời gian ở trên cho phép ta tìm điểm giao nhau giữa phép tính và lượng đọc KV, rồi chọn batch size dựa trên độ trễ token đầu tiên và khoảng đầu ra.
8.2.2 Từ batch cố định đến continuous batching
Hai request bắt đầu sinh cùng lúc; một request cần tám token, request kia chỉ cần hai. Khi request ngắn hoàn thành, request dài vẫn còn sáu bước. Nếu ta khăng khăng chờ cả hai request hoàn thành trước khi bắt đầu nhóm tiếp theo, vị trí thực thi được giải phóng bởi request ngắn sẽ ngồi không suốt thời gian đó. Fixed batching tiếp nhận và hoàn thành cả một nhóm cùng nhau; continuous batching thay vào đó tổ chức lại các request đang hoạt động tại mỗi ranh giới vòng lặp, tiếp nhận các request mới ngay khi một vị trí được mở ra.
Phân tích batch trong Mục 8.2.1 giả định request tham gia tính toán mỗi vòng, nhưng trong thực tế số hàng thay đổi khi các request hoàn thành và các request mới được tiếp nhận. Vị trí thực thi trong Hình 8-1 tương ứng với một hàng tính toán ở đây, một tài nguyên khác với các vị trí request giao tiếp được ghi lại trong Chương 7. Việc các request mới có thể được tiếp nhận kịp thời hay không quyết định bao nhiêu hàng có thể tham gia tính toán trong vòng tiếp theo.
Tiếp nhận các request mới sớm hơn cũng có nghĩa là phép tính đầu vào của chúng chiếm accelerator sớm hơn. Nếu một request mới mang prompt dài, prefill của nó kéo dài khoảng chờ giữa hai bước decode của các request hiện có. Bộ lập lịch do đó phải phân chia thời gian accelerator giữa hai việc: xử lý đầu vào của các request mới, và để các request hiện có tiếp tục sinh.
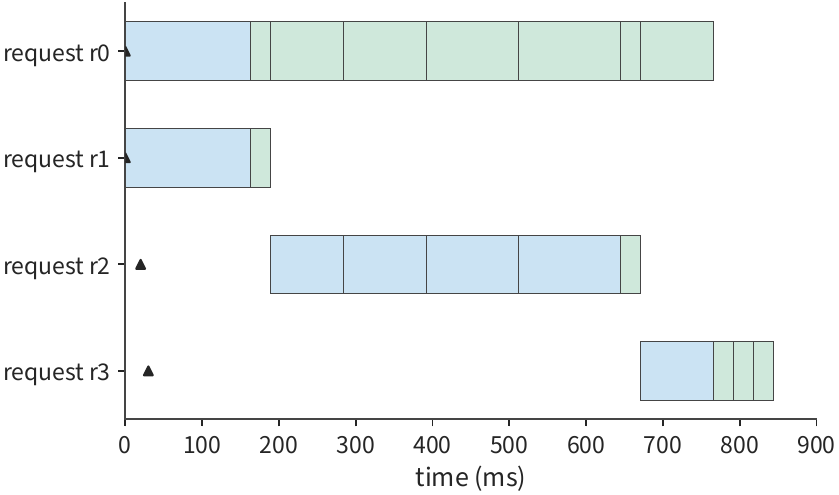
Ví dụ: vì sao continuous batching rút ngắn tổng thời gian nhưng lại kéo dài các khoảng đầu ra? Có nhiều nhất hai request chạy cùng lúc. r0 và r1 đến tại thời điểm 0, mỗi cái có đầu vào 2048 token, lần lượt xuất ra 8 và 2 token; r2 đến tại 20 ms với đầu vào 8192 token và xuất ra 2 token; r3 đến tại 30 ms với đầu vào 2048 token và xuất ra 4 token. Thời gian mỗi vòng được khớp từ các phép đo batch-1 trong Thí nghiệm 8-1: 26.22 ms cố định, cộng 30.4 μs cho mỗi token mới, cộng 3 ns cho mỗi cặp query-key thỏa mãn quan hệ nhân quả. Các tham số này tái tạo 26.26 ms đo được của một vòng decode và 94.8 ms của prefill khi một request 2K chạy một mình. Thành phần cố định là phần của một vòng không phụ thuộc vào số token, bao gồm đọc toàn bộ bộ trọng số (khoảng 8.4 ms tại băng thông đỉnh 1792 GB/s) và chi phí đệ trình kernel từng cái một.
Fixed batching khiến r2 và r3 phải chờ toàn bộ nhóm r0/r1 hoàn thành, cho tổng thời gian khoảng 870 ms. Continuous batching tiếp nhận r2 ngay khi r1 hoàn thành, giảm tổng thời gian xuống khoảng 766 ms; nhưng đầu ra tiếp theo của r0 phải chờ prefill 8K của r2, và khoảng đầu ra lớn nhất tăng từ khoảng 26 ms lên 376 ms. Tổng thời gian giảm khoảng 12%, trong khi một lần dừng đầu ra tăng lên 14 lần độ dài ban đầu.
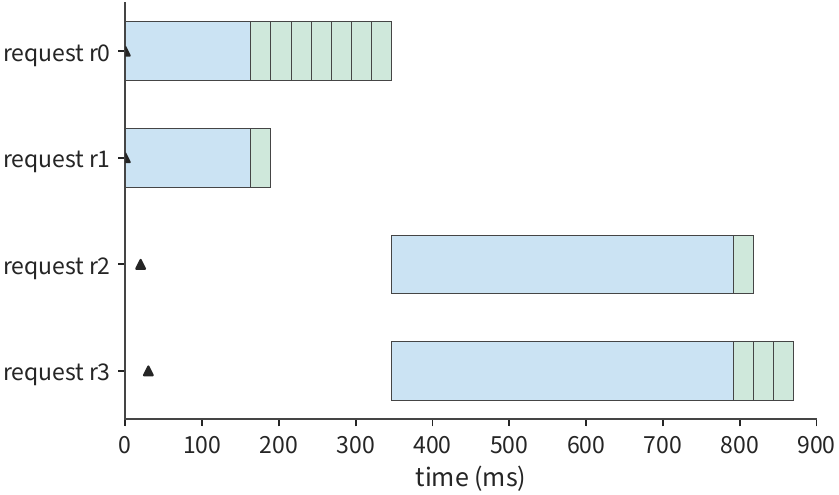
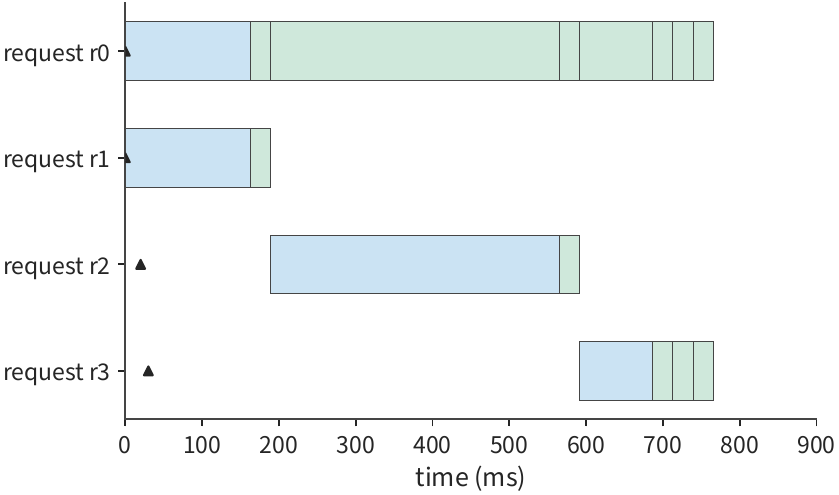
Tiến xa hơn, chia prefill của r2 thành các khối 2048 token mỗi khối, xử lý nhiều nhất 4096 token mỗi vòng (cùng cài đặt như trong Thí nghiệm 8-1), và để các request hiện có tiếp tục decode trước khi mỗi khối đầu vào mới được xử lý, khoảng đầu ra lớn nhất giảm xuống khoảng 133 ms, và tất cả các request hoàn thành với tổng thời gian khoảng 844 ms. Sau khi chia khối, bộ lập lịch có thể thường xuyên hơn để các request hiện có tiếp tục sinh, làm cho các khoảng đầu ra đều đặn hơn.
8.2.3 Sự can nhiễu của prefill dài với quá trình sinh, và thực thi chia khối
Khối prefill được xử lý cùng lúc càng lớn, số vòng xử lý đầu vào mà một request mới cần càng ít; khối càng nhỏ, các request đang chạy càng sớm có cơ hội thực thi tiếp theo. Các bộ lập lịch thường lập lịch trước các request đang decode, sau đó dùng phần còn lại của ngân sách token của vòng này để xử lý prefill. Các đầu vào dài do đó được trải rộng ra trên phép tính của nhiều khoảng đầu ra.
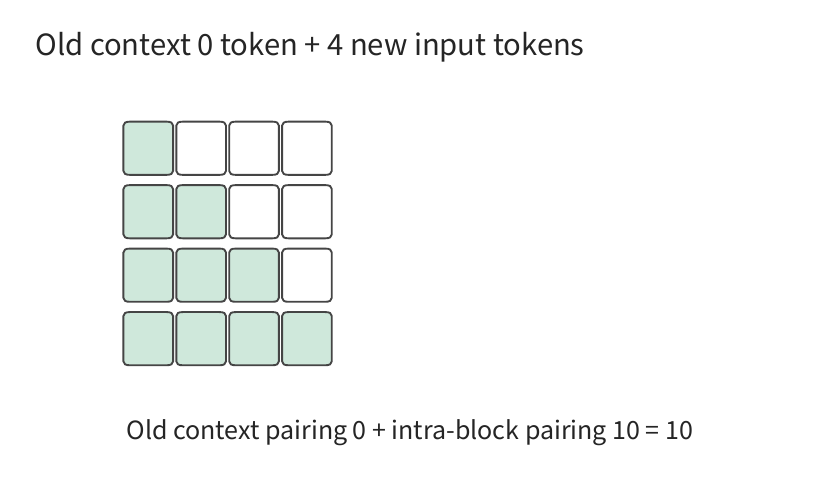
Ngay cả với độ dài khối cố định, khối lượng công việc attention vẫn tăng theo độ dài context. Giả sử khối hiện tại chứa token mới, với độ dài context hiện có là . Token mới đầu tiên attention đến token, token thứ hai đến , và token cuối đến . Cộng từng cặp lại từng số hạng:
Số hạng đến từ việc các token mới truy cập context cũ, và số hạng tam giác đến từ attention nhân quả trong khối. Lấy : 131,328 cặp của khối đầu tiên đến hoàn toàn từ bên trong khối; khối cuối cùng của một đầu vào 8K đã có 7680 token context, và số cặp của nó tăng lên 4,063,488 — khoảng 31 lần khối đầu tiên.
Hình 8-8 mô tả số cặp dưới dạng diện tích: mỗi token mới phải truy cập toàn bộ context cũ, tạo thành hình chữ nhật bên trái; trong khối, một token chỉ có thể attention đến các vị trí tại hoặc trước vị trí của chính nó, tạo thành hình tam giác bên phải. Với độ dài khối cố định, hình tam giác bên phải không đổi, trong khi hình chữ nhật bên trái mở rộng khi context tăng. Đây là lý do khối cuối cùng cần nhiều phép tính attention hơn.
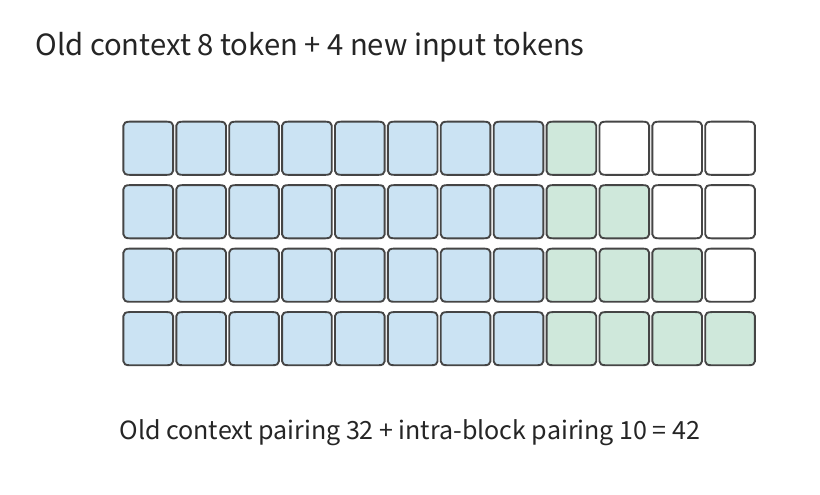
Model cũng phải chạy các projection và FFN; phép biến đổi đặc trưng theo token này xử lý 512 token mới mỗi khối, nên khối lượng công việc của nó gần như không đổi. Trong các bản ghi từng khối đã thu thập, phép tính ma trận thân model (model backbone) của khối cuối cùng lớn hơn khoảng 32% so với khối đầu tiên, với thời gian thực thi trung vị tăng từ khoảng 25.3 ms lên 35.1 ms — tăng khoảng 39%. Thời gian thực thi tổng thể của khối do đó được quyết định chung bởi hai phần: một phần thay đổi chủ yếu theo số token mới, và một phần khác cũng tăng theo độ dài context hiện có.
Sự tăng trưởng của context giải thích vì sao các khối cùng kích thước ngày càng chậm; thu nhỏ độ dài khối lại mang đến một loại chi phí khác. Chia một khối 256 token thành hai khối 128 token tăng gấp đôi số cơ hội lập lịch và giảm một nửa số hàng ma trận, nhưng mỗi khối nhỏ hơn vẫn phải dùng cùng một bộ trọng số. Lấy trọng số FFN 288 MiB của một layer làm ví dụ: nếu hai lần thực thi mỗi lần đọc riêng chúng từ bộ nhớ GPU, phần đọc này tăng từ 288 lên 576 MiB. Các khối nhỏ hơn cho các request đang chạy cơ hội thực thi sớm hơn, nhưng cũng tăng số lần thực thi; bộ lập lịch nên chọn khối lớn nhất vẫn thỏa mãn yêu cầu khoảng đầu ra, để giảm thiểu các lần khởi chạy và đọc thêm.
8.2.4 Ngân sách token, shape động và thời gian thực thi
Các bộ lập lịch thường đặt giới hạn trên cho số token được xử lý mỗi vòng, gọi là ngân sách token; 4096 token được xử lý tối đa mỗi vòng trong ví dụ chia khối ở Mục 8.2.2 là một trường hợp của điều này. Tuy nhiên, thực thi thực tế phải ghép các vector đặc trưng của các token này thành một ma trận và chọn một kernel hoặc một CUDA Graph đã được ghi trước (Mục 5.5.2). Ma trận thực sự được thực thi có thể lớn hơn thứ vòng này thực sự cần, nên xử lý bớt một token không nhất thiết có nghĩa là làm ít phép tính hơn.
Ví dụ, giả sử các graph được ghi trước cho 16 hàng và 32 hàng, và các đầu vào từ 17 đến 32 hàng đều được padding lên 32 hàng. Giảm khối lượng công việc từ 18 hàng xuống 17 hàng vẫn thực thi graph 32 hàng; chỉ khi giảm tiếp từ 17 hàng xuống 16 hàng, graph nhỏ hơn mới được dùng. Ghi một graph riêng cho 17 hàng sẽ loại bỏ 15 hàng padding, nhưng việc ghi graph đó cần thời gian chuẩn bị, và buffer dùng để tái phát cũng phải được giữ trong bộ nhớ lâu dài. Do đó, khi chọn các shape định sẵn cho CUDA Graphs, chi phí bộ nhớ runtime từ Mục 8.1 cũng phải được tính đến.
Shape thực thi quyết định một vòng mất bao lâu, trong khi giới hạn token quyết định vòng này giao bao nhiêu công việc cho các request mới. Nâng giới hạn giúp các đầu vào dài hoàn thành xử lý sớm hơn, nhưng các request đang chạy phải chờ đến khi vòng này kết thúc mới có thể tiếp tục sinh đầu ra. Trong một bản ghi tái phát của sáu request, các request đến mỗi 80 ms. Khi giới hạn token mỗi vòng tăng từ 512 lên 8192, thời gian xếp hàng trong engine cho các request đến sau giảm từ khoảng 149 ms xuống dưới 0.1 ms, trong khi khoảng đầu ra dài nhất thay vào đó tăng từ khoảng 32 ms lên 183 ms. Giới hạn càng cao, một vòng hoàn thành càng nhiều đầu vào, các request mới rời hàng đợi càng sớm — và các request đang chạy chờ đầu ra tiếp theo càng lâu.
Việc quyết định xử lý bao nhiêu token mỗi vòng do đó có thể được thực hiện theo hai bước. Đầu tiên xác định một vòng được phép chạy bao lâu dựa trên khoảng đầu ra cho phép, sau đó kết hợp điều này với độ dài context và shape thực thi định sẵn để quy đổi thành số token mới có thể xử lý. Trong cùng một khoảng thời gian, các request có context dài hơn có thể xử lý ít token mới hơn, trong khi các request có context ngắn hơn có thể dùng các khối lớn hơn. Khi lịch thực thi được quyết định, không gian KV vẫn phải được cấp cho các request này; mục tiếp theo thảo luận cách cấp phát và tái sử dụng bộ nhớ này.
Bài tập 8-2 · Cốt lõi · Phân tích: xác định kích thước khối prefill từ ràng buộc khoảng đầu ra. Dùng bốn request và mô hình thời gian thực thi từ Mục 8.2.2, tính bằng tay thời gian prefill ban đầu và bước decode tiếp theo của r0 và r1, sau đó tính thời lượng của vòng trong đó continuous batching tiếp nhận r2. Giải thích nguồn gốc của khoảng đầu ra dài nhất. Với độ dài khối mới cố định là , tính số cặp attention cho các độ dài context hiện có và tương ứng. Cuối cùng, phân tích bản ghi tái phát sáu request kèm theo, chọn giới hạn token mỗi vòng dưới mỗi một trong hai mục tiêu “khoảng dài nhất dưới 50 ms” và “tiếp nhận các request đến sau càng sớm càng tốt”, và xác định chi phí thời gian nào quyết định mỗi lựa chọn.
8.3 Cấp phát, tái sử dụng và giải phóng KV cache
8.3.1 Dành trước, phân mảnh và cấp phát phân trang (paged allocation)
Mục 8.1 dành trước không gian cho mỗi request dựa trên độ dài đầu ra tối đa, đảm bảo nó có thể tiếp tục sinh. Nếu một request kết thúc sớm, phần đuôi không gian dành trước của nó sẽ vĩnh viễn bỏ phí. Một phương án thay thế là mở rộng bộ nhớ dần khi quá trình sinh tiến hành, nhưng nếu không gian phải liên tục, các vùng liền kề bị các request khác chiếm giữ sẽ đòi hỏi phải di chuyển dữ liệu hoặc chờ đợi.
Loại cấp phát này có thể được ví như một quyển sổ lỏng lẻo: thứ tự đọc được cố định bởi số trang, nhưng các trang không cần nằm ở các vị trí vật lý liền kề — người ta chỉ cần nhớ mỗi trang nằm ở đâu. Khi một chuỗi tăng trưởng, một trang mới có thể được đặt vào bất kỳ vị trí trống nào với vị trí của nó được ghi lại, tránh việc phải dịch chuyển toàn bộ quyển sổ chỉ để giữ cho các trang liên tục.
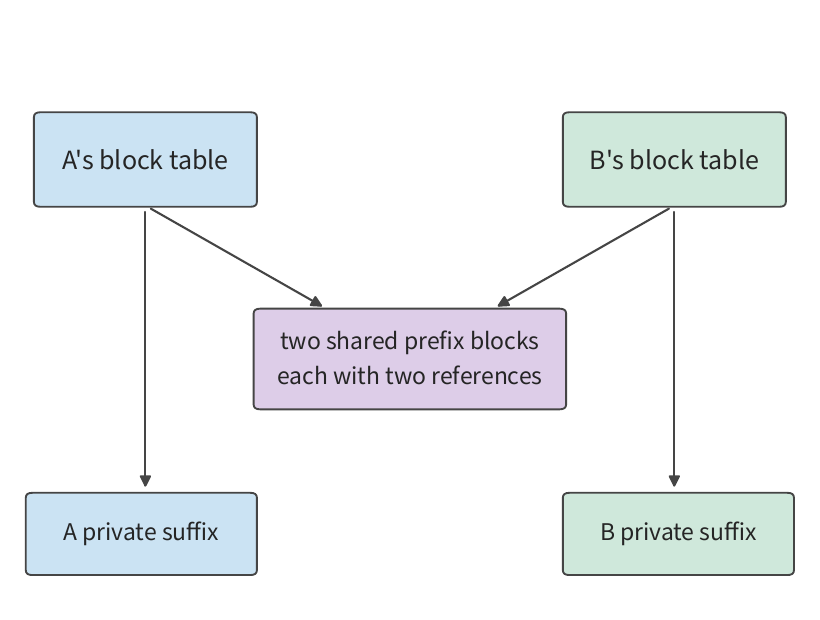
Paged allocation chia một chuỗi thành các khối kích thước cố định. Một khối logic được đánh số theo vị trí trong chuỗi, tương tự như số trang; một khối vật lý là vùng bộ nhớ thực sự chứa KV; một bảng khối (block table) theo từng request ghi lại mỗi khối logic ánh xạ đến khối vật lý nào. Khi một chuỗi tăng trưởng đủ để cần một khối mới, engine cấp một khối vật lý từ nhóm tự do và thêm ánh xạ. Phép tính attention tra bảng khối để tìm KV tại vị trí cần thiết, nên các khối vật lý có thể nằm rải rác trong bộ nhớ. Điều được thảo luận ở đây là định địa chỉ KV theo khối trong bộ nhớ; việc swap-in và swap-out giữa các tầng của phân cấp bộ nhớ được để lại cho Mục 8.3.4 và 8.4.3.
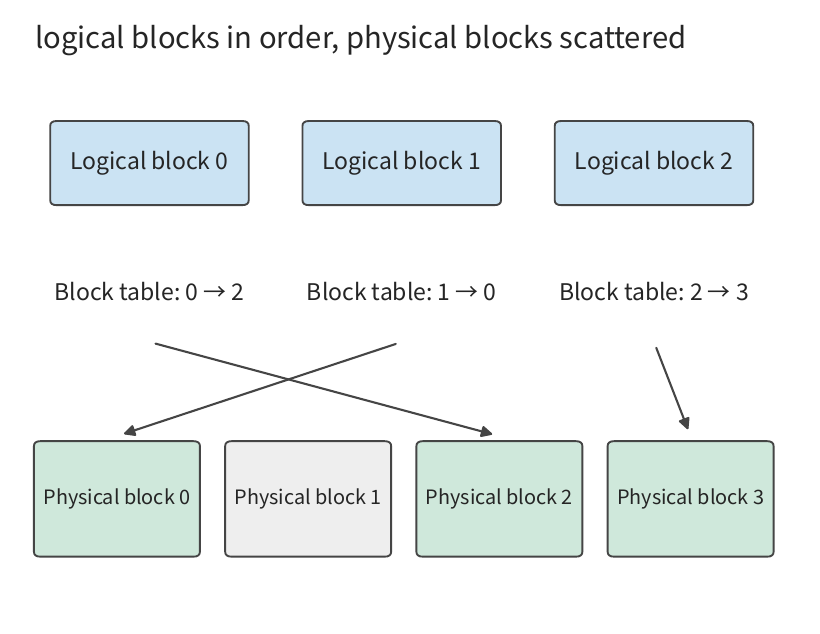
Gọi mỗi khối chứa KV của token, và độ dài hiện tại là ; khi đó cần khối. Chỉ khối cuối cùng có các vị trí KV trống ở phần đuôi, lãng phí
nhiều nhất KV tương đương token. Khối càng nhỏ, cận trên này càng thấp, nhưng càng nhiều mục bảng khối và phép toán cấp phát. Năm 2023, các nhà nghiên cứu tại Berkeley và các tổ chức khác đề xuất PagedAttention trong vLLM, áp dụng ý tưởng quản lý bộ nhớ phân trang kiểu hệ điều hành vào KV cache, giảm ràng buộc mà không gian dành trước và phân mảnh bộ nhớ đặt lên concurrency phục vụ. PagedAttention đưa phép ánh xạ này vào chính việc thực thi attention; FlashAttention, ngược lại, tổ chức tính toán theo khối và các kết quả trung gian bên trong toán tử — hai cách này tác động lần lượt lên việc cấp phát trạng thái và lên việc truy cập bộ nhớ tính toán.
Ví dụ làm việc: KV paged allocation có thể tiết kiệm bao nhiêu không gian dành trước? Giả sử A, B, C, D hiện có độ dài 9, 13, 5, 15, mỗi cái được phép tối đa 16 token. Với dành trước trọn phạm vi, bốn request cùng nhau dành trước không gian KV cho 64 token; với phân trang , chúng được cấp lần lượt 12, 16, 8, 16, cho tổng không gian KV là 52 token. Trong số này, KV thực sự được lưu vẫn tương ứng với 42 token, nên dung lượng không dùng giảm từ 22 token xuống 10 token.
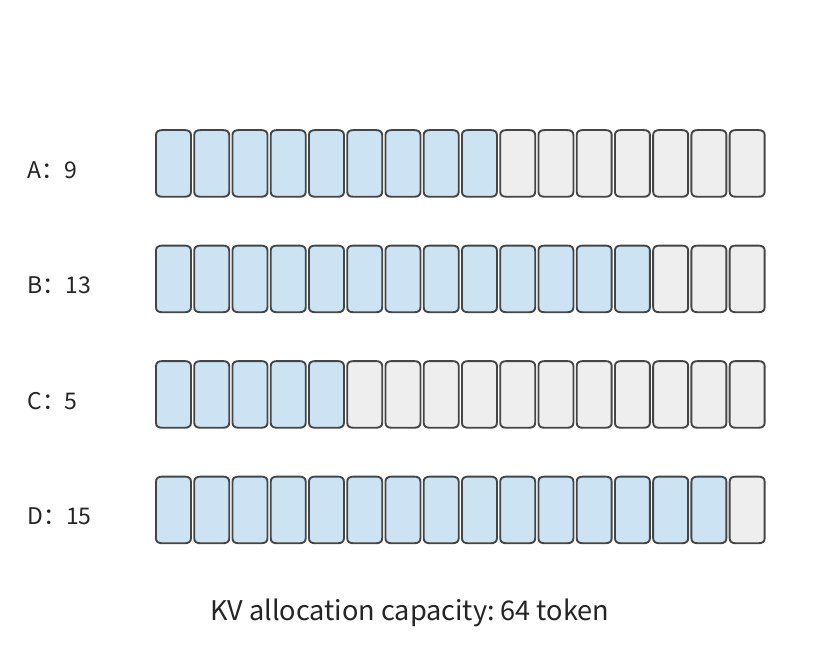
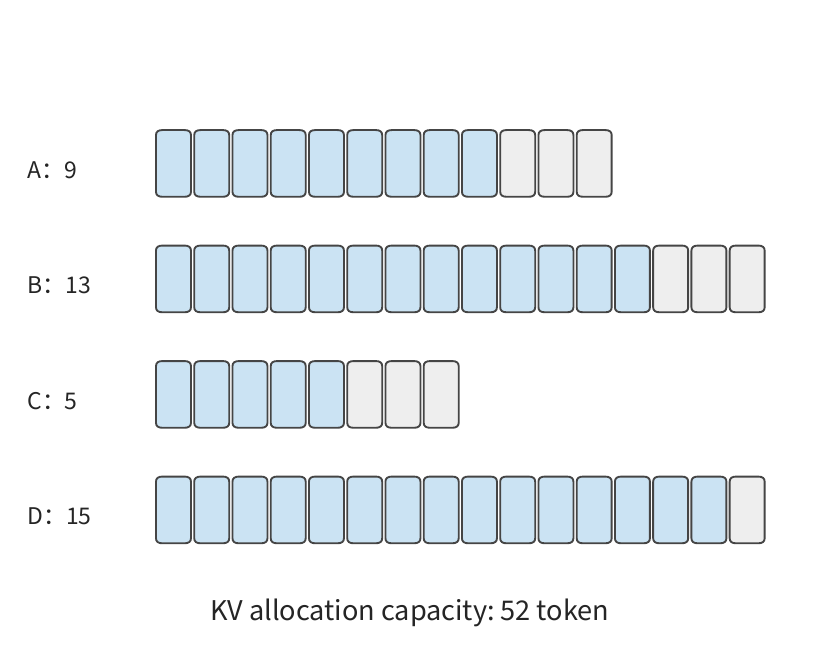
Nếu tám token đầu tiên của A và B giống hệt nhau, chúng có thể chia sẻ thêm hai khối đầy, giảm tổng cấp phát xuống 44 token. Phân trang giảm không gian dành trước nhưng không dùng; chia sẻ loại bỏ việc lưu trùng lặp của context — hai cách này tiết kiệm bộ nhớ ở những phần khác nhau.
8.3.2 Chia sẻ nhánh, copy-on-write và giải phóng bộ nhớ
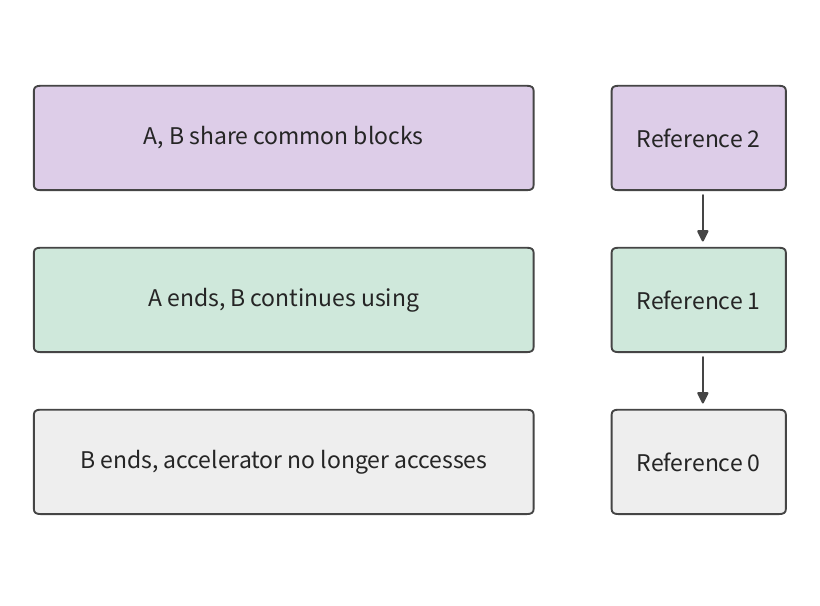
Trong hình chia sẻ tiền tố, B và A tham chiếu cùng hai khối vật lý. Nếu A hoàn thành trước, hai khối đó vẫn phải được giữ cho B; nếu B cần sửa nội dung của chúng, điều đó không được ảnh hưởng đến A. Việc triển khai chia sẻ do đó đòi hỏi xác định khi nào giải phóng các khối dùng chung, và cách ngăn các request khác nhau ghi đè dữ liệu của nhau. Mỗi mục trong một bảng khối trỏ đến một khối vật lý được gọi là một tham chiếu (reference); một khối dùng chung được tham chiếu bởi nhiều bảng khối. Một bộ đếm tham chiếu (reference count) ghi lại còn bao nhiêu người dùng cần nó. Mỗi lần một request nhận một tham chiếu, bộ đếm tăng thêm một; khi request kết thúc, nó giải phóng tham chiếu. Chỉ sau khi tham chiếu cuối cùng được giải phóng, khối mới có thể trở về nhóm tự do — và ngay cả khi đó, người ta vẫn phải xác nhận rằng các phép toán accelerator không còn truy cập nó. Bằng cách này, cùng một context dùng chung có thể phục vụ nhiều nhánh cùng lúc, và tiếp tục phục vụ các nhánh còn lại sau khi một nhánh kết thúc.
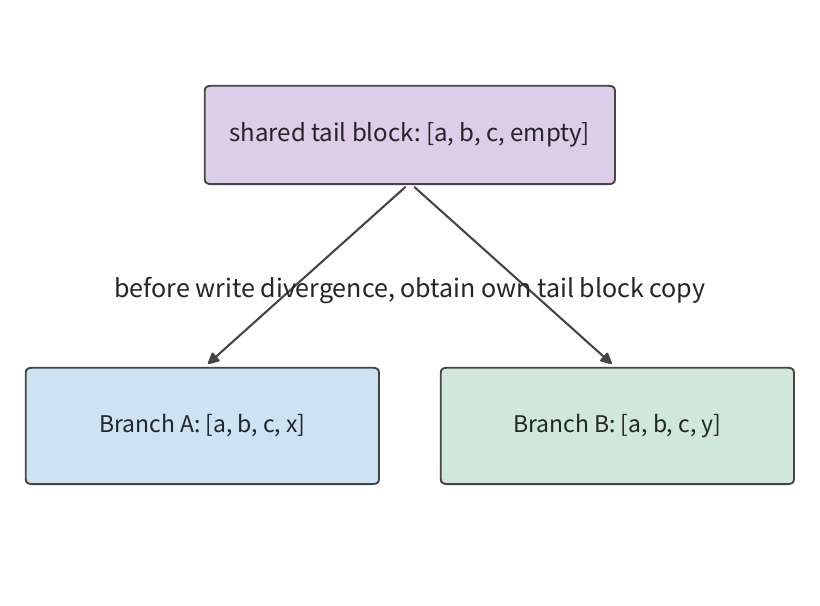
Việc ghi vào một khối đuôi dùng chung đòi hỏi có được một bản sao độc lập. Ví dụ, giả sử một khối có thể chứa 4 token đã được ghi KV của ba token dùng chung, và hai nhánh sắp ghi các token khác nhau tiếp theo. Ghi trực tiếp vào khối gốc sẽ khiến hai nhánh tranh giành vị trí thứ tư của khối. Copy-on-write là cơ chế lấy một bản sao riêng trước khi sửa nội dung dùng chung. Ở đây ba token được sao chép trước, và hai nhánh mỗi nhánh thêm nối tiếp riêng; khối chỉ đọc đã đầy tiếp tục được chia sẻ. Khi các nhánh tăng trưởng, tiền tố chung vẫn là một bản sao duy nhất, trong khi mỗi nhánh chỉ lưu hậu tố mới thêm của riêng mình.
Trong một thí nghiệm hiện có với bốn nhánh, tiền tố chung chiếm 95 khối, và mỗi nhánh có thêm 9 khối riêng. Bốn bảng khối cùng nhau giữ tham chiếu, nhưng số khối vật lý thực tế chỉ là
Việc lưu trữ độc lập sẽ cần 416 khối; chia sẻ cắt giảm khoảng 69%. Khoản tiết kiệm này đến từ việc khử trùng lặp tiền tố chung; 36 khối đuôi riêng vẫn tăng theo số nhánh.
Hệ thống phục vụ biết token nào thuộc về tiền tố chung và token nào sẽ được ghi độc lập sau khi phân nhánh, nên nó có thể chuyển trực tiếp các quan hệ tái sử dụng của model thành việc chia sẻ khối vật lý. Bảng khối xử lý ánh xạ địa chỉ, quan hệ tiền tố xác định phạm vi chia sẻ, và các bản sao riêng chỉ được tạo khi một nhánh ghi. Thứ trước đây được dành trước độc lập theo từng request nguyên vẹn do đó được cấp lại dựa trên trạng thái thực sự được tạo ra và tái sử dụng.
Dung lượng KV toàn batch sau khi chia sẻ tiền tố chung. 16 request dài chia sẻ 6144 token đầu vào đầu tiên, có KV chiếm tổng cộng 864 MiB. Phần riêng của mỗi request chứa token. Cấp phát với 16 token mỗi khối cần không gian cho 2304 token, tức 324 MiB. Vậy không gian KV cần thiết khi nhóm request này sinh xong là
Nhóm request này ban đầu cần MiB; sau khi chia sẻ, nó khoảng 5.91 GiB, vừa trong 12 GiB bộ nhớ dành riêng. Tổng quát, request dài tương tự chiếm MiB, nên trần dung lượng tăng từ 10 request độc lập lên 35 request dùng chung.
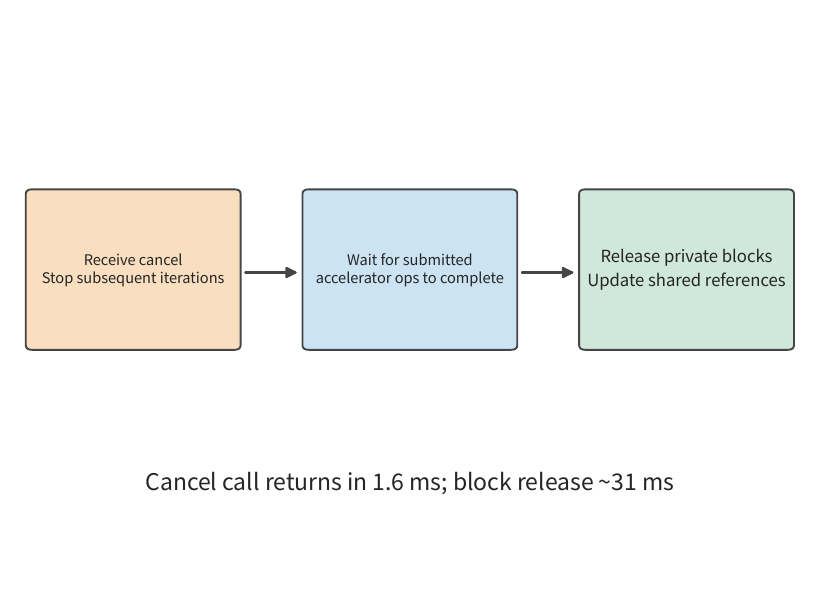
Một khi một khối không còn được dùng nữa, nó vẫn phải được giải phóng đúng cách trước khi trao cho một request sau. Giải phóng bộ nhớ đòi hỏi thỏa mãn đồng thời hai điều kiện: không người dùng nào còn giữ tham chiếu, và các phép toán accelerator đã đệ trình không còn truy cập khối. Sau khi một người dùng hủy request, bộ lập lịch ngừng lập lịch tính toán mới cho nó, chờ các phép toán đã đệ trình hoàn thành, và chỉ sau đó giải phóng các khối riêng của nó. Trong một quan sát, lời gọi hủy trả về trong khoảng 1.6 ms, trong khi 104 khối tương ứng không được giải phóng cho đến khoảng 31 ms. Các request sau chỉ dùng các khối này sau khi giải phóng sẽ không ghi đè lên dữ liệu mà một request cũ vẫn đang đọc.
Ngoài việc giải phóng bình thường khi một request kết thúc hoặc bị hủy, engine còn có thể tạm dừng (preempt) một request khi thiếu bộ nhớ: tạm dừng request và giải phóng KV của nó, sau đó về sau tính lại trạng thái từ đầu vào và đầu ra đã lưu. Trong cùng thí nghiệm, một lần tạm dừng xảy ra khi dùng nhóm KV 1 GiB, lập lịch thêm 1805 token so với thực thi bình thường; với nhóm 2 GiB, việc tính lại này không xảy ra. Tạm dừng tạm thời giải phóng bộ nhớ cho các request khác, đổi lại phép tính lặp lại khi thực thi tiếp tục.
Bài tập 8-3 · Tính toán: kích thước khối KV và chia sẻ tiền tố ảnh hưởng dung lượng thế nào. Phân trang bốn chuỗi có độ dài 9, 13, 5 và 15 thành các khối lần lượt 2, 4 và 8 token; tính số vị trí KV không dùng trong khối đuôi của mỗi chuỗi, và tìm tổng số vị trí KV không dùng và tổng số mục bảng khối trong mỗi trường hợp. Sau đó, dùng ví dụ mở đầu chương, tính dung lượng đầy đủ cho 8, 16 và 32 request dài trong cả điều kiện độc lập và dùng chung. Giữ tổng độ dài của mỗi request cố định, chuyển một khối đầy vốn riêng thành một phần của tiền tố chung, và tìm xem request cần cấp ít hơn bao nhiêu khối vật lý tổng cộng.
8.3.3 Tái sử dụng tiền tố qua các cuộc hội thoại và tác vụ agent
Mục 8.3.2 đề cập đến việc các request chạy đồng thời chia sẻ khối vật lý. Việc chia sẻ này cũng có thể kéo dài qua cả thời điểm kết thúc của một request: KV tiền tố để lại bởi một request cũ có thể giúp một request sau khỏi phải tính lại cùng một đoạn đầu vào. Nếu tiền tố của một request tiếp theo giống hệt từng token, và dùng cùng model, cùng quy tắc positional encoding, cùng adapter và cùng định dạng trạng thái, nó có thể dùng trực tiếp KV đã cache và tiếp tục prefill từ cuối tiền tố. Tiền tố chung 6144 token của ví dụ mở đầu chương có nghĩa là khi cache được trúng, mỗi request dài chỉ cần xử lý 2048 token đầu vào còn lại trước khi bắt đầu sinh.
Loại tái sử dụng này diễn ra liên tục dọc theo tiền tố. Giả sử hai prompt chia sẻ 100 token đầu tiên nhưng khác nhau ở token thứ 101 — ngay cả khi văn bản sau đó khớp lại, context mà mỗi cái phụ thuộc vào từ token thứ 101 trở đi đã khác nhau. Đặt một timestamp động ngay tại đầu prompt khiến các định nghĩa công cụ dùng chung dài hơn phía sau mất cơ hội tái sử dụng; đặt system prompt và định nghĩa công cụ ổn định trước, rồi thêm biến thể của vòng này sau đó, sẽ giữ được một tiền tố chung dài hơn.
Một cây tiền tố (prefix tree) biểu diễn trực tiếp cấu trúc này: đường đi từ gốc đến điểm phân nhánh là context dùng chung, và đường đi từ điểm phân nhánh đến một lá là hậu tố riêng. Trong Hình 8-17, bốn vòng đầu vào đầu tiên chia sẻ 206 token, và ba vòng tiếp theo tiếp tục mở rộng dọc theo cùng một đường đi. Các cạnh trong cây được gán nhãn bằng số token mới, và các lá cho biết tổng độ dài đầu vào.
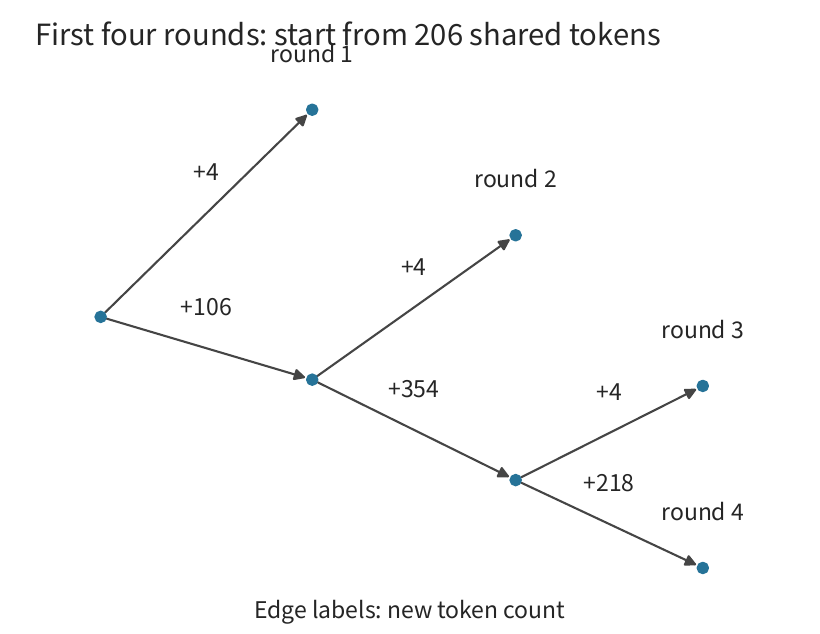
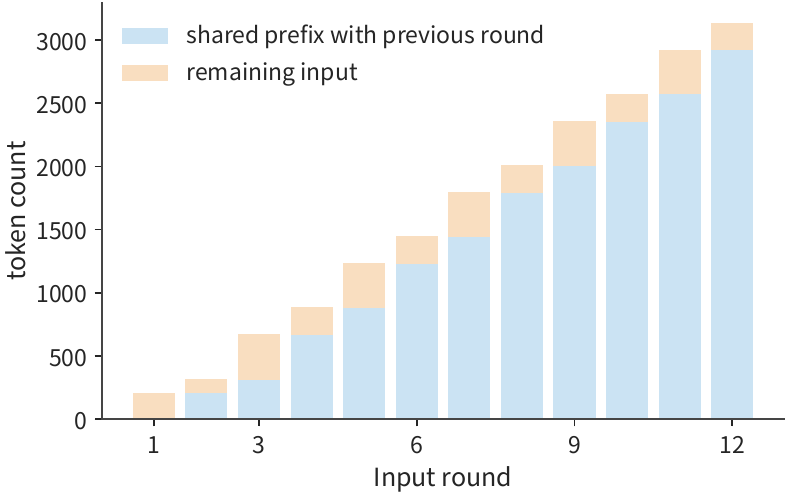
Việc thêm nội dung vào cuối mỗi vòng giữ nguyên tiền tố chung hiện có, nhưng context càng dài thì footprint KV và lượng đọc tiếp theo càng lớn.
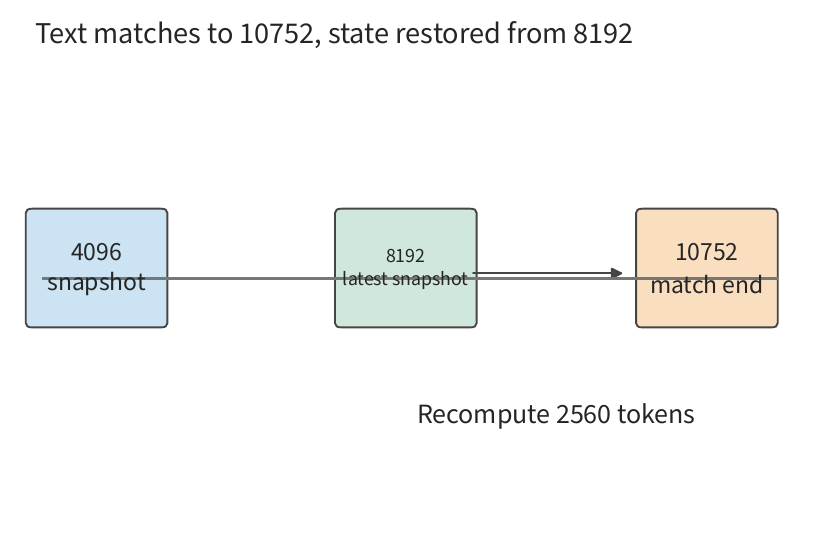
Mở rộng: một model attention lai xác định vị trí tiền tố khôi phục được như thế nào. Full attention giữ lại KV theo từng token, trong khi các model hồi quy (recurrent) thường chỉ giữ lại trạng thái hiện tại. Giả sử văn bản khớp đến token thứ 10,752, và các snapshot hồi quy được lưu tại token thứ 4096 và 8192 tương ứng; hệ thống khôi phục từ 8192 rồi tính tiếp đến 10,752, tính lại 2560 token. Thêm nhiều snapshot hơn giảm số token cần tính lại, nhưng đòi hỏi lưu nhiều trạng thái hơn. Lấy KDA trong Chương 2 làm ví dụ, một triển khai chia tensor trong layer này ra tám card (TP=8); trong trường hợp này, mỗi snapshot khoảng 53.6 MiB mỗi card, nên giữ 2 snapshot tốn khoảng 107 MiB, và giữ 32 snapshot tốn khoảng 1714 MiB. Snapshot càng dày, khi khôi phục càng ít token cần tính lại, nhưng càng nhiều trạng thái phải được giữ lại.
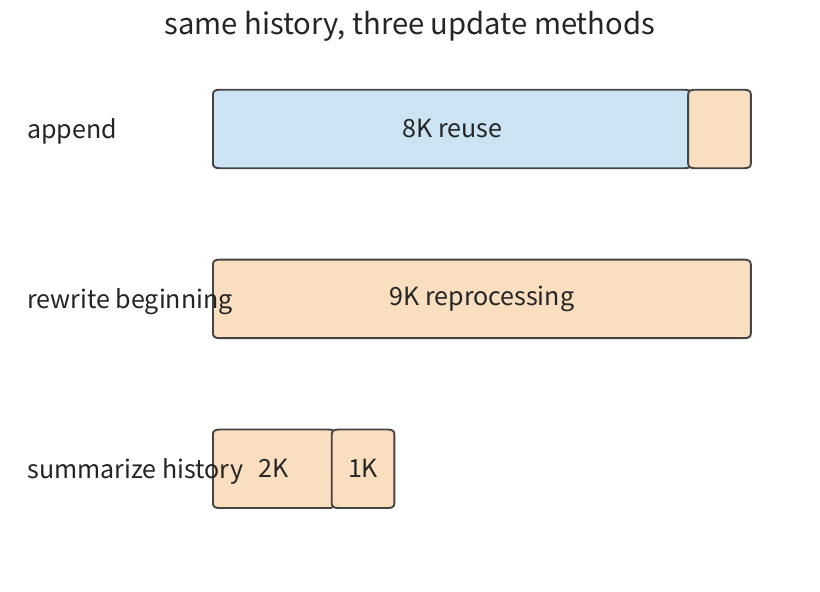
Tổ chức context cũng có thể chủ động thay đổi cơ hội tái sử dụng. Giả sử đã có một context 8K token, và vòng tiếp theo thêm một kết quả công cụ 1K; tối đa tiền tố 8K ban đầu có thể được tái sử dụng, chỉ cần xử lý phần mới. Nếu thay vào đó các chỉ dẫn mở đầu được viết lại, nội dung phía sau — dù giống hệt về mặt văn bản — không còn có thể tái sử dụng. Một cách tiếp cận khác là tóm tắt lịch sử xuống 2K rồi thêm 1K. Việc thay lịch sử gốc bằng một bản tóm tắt có nghĩa là phép tính tiếp theo dùng context ngắn hơn, nhưng phải trả thêm chi phí của một lượt tóm tắt và một lượt xây dựng lại. Tổ chức context do đó yêu cầu cân nhắc cùng lúc footprint bộ nhớ, thời gian tính lại và lượng đọc tiếp theo.
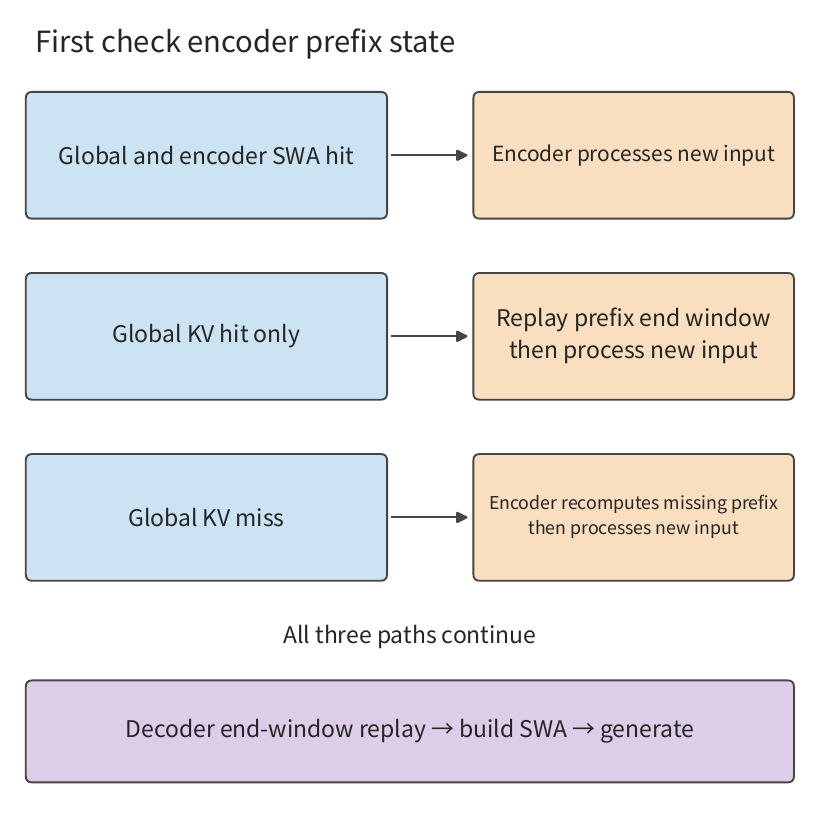
Việc tái sử dụng tiền tố ở phía model cũng liên quan đến những phân biệt tinh tế hơn trong trạng thái. DeepSeek V4.1 xử lý riêng hai loại trạng thái cục bộ khi tái sử dụng tiền tố. Cấu trúc CED được giới thiệu trong Chương 2 bao gồm một encoder nhân quả và một decoder, mỗi phần có trạng thái cục bộ SWA riêng: encoder SWA có thể được giữ ngắn hạn trong một nhóm DRAM của host, để tiếp tục xử lý đầu vào mới dọc theo tiền tố hiện có trong vòng tiếp theo; decoder SWA chỉ được dùng cho việc sinh của chính vòng này, và bản triển khai được mô tả trong bài báo không lưu nó như một phần của prefix cache. KV toàn cục (global KV), ngược lại, đi vào một cache có thể được tái sử dụng trong thời gian dài hơn. Do đó, 40 layer SWA cư trú trong quá trình sinh và prefix cache được giữ lại giữa các vòng cần được hạch toán dung lượng riêng biệt.
Việc hai loại trạng thái này có được trúng hay không quyết định encoder cần khôi phục bao nhiêu tiền tố khi tiếp tục tính toán trong vòng tiếp theo. Giả sử khi công cụ trả về, các token hoặc biểu diễn đầu vào cần cho việc khôi phục vẫn có sẵn, và phiên bản model, chỉ số vị trí token và đầu vào vẫn nhất quán. Khi cả global KV và encoder SWA đều được trúng, encoder xử lý trực tiếp đầu vào được thêm; khi chỉ trúng global KV, encoder tái phát đến tối đa 128 token gần nhất của tiền tố đã cache và thực thi chúng cùng với hậu tố chưa cache. Đoạn tái phát xây dựng lại encoder SWA và tiếp tục dùng global KV hiện có; hậu tố mới được thêm tạo ra global KV và SWA mới. Khi global KV cũng không được trúng, phần tiền tố thiếu được tính lại từ đầu.
Sau đó, mọi prefill chia sẻ một bước chung: lấy đầu ra encoder của tối đa 128 token cuối cùng của prompt hoàn chỉnh, đưa qua 20 layer decoder để tái dựng gần đúng decoder SWA, chuẩn bị trạng thái cục bộ cho bước decode đầu tiên. Vậy khi cache encoder được trúng hoàn toàn, việc khôi phục tiền tố encoder có thể được bỏ qua, nhưng decoder vẫn cần thực hiện tái phát cửa sổ.
Trạng thái thu được từ tái phát cửa sổ ngắn là một trạng thái khôi phục gần đúng, với sai số phát sinh từ việc các phụ thuộc cục bộ sớm hơn bị cắt bớt. Dù mỗi layer chỉ truy cập 128 token gần nhất, việc xếp chồng nhiều layer vẫn khiến trạng thái cục bộ phụ thuộc gián tiếp vào đầu vào sớm hơn thông qua layer trước. Việc thực thi lại từ ranh giới cửa sổ thay đổi phần thông tin lịch sử này. Do đó Mục 3.2.2 của báo cáo kỹ thuật định nghĩa trạng thái được encoder xây dựng lại là một trạng thái gần đúng; trạng thái này lại đưa vào phép tính tiếp theo, khiến global KV và SWA của hậu tố mới thêm phụ thuộc vào điểm khởi đầu khôi phục.
Sự khác biệt giữa hai loại trạng thái cuối cùng thể hiện ở dung lượng cache. Dưới khối lượng công việc và chính sách cache được áp dụng trong báo cáo kỹ thuật DeepSeek V4, SWA chiếm khoảng một nửa cache dài hạn. V4.1 chuyển phần này ra khỏi cache bền vững, và nén tiếp global KV xuống còn khoảng một phần tư, nên khối lượng lưu trữ dài hạn trở thành khoảng so với ban đầu. Encoder SWA được giữ ngắn hạn nằm trong DRAM, trong khi decoder SWA chỉ cư trú trên accelerator trong quá trình sinh của vòng đó. Việc cache dữ liệu theo tầng thời gian sử dụng làm giảm thêm yêu cầu dung lượng dài hạn.
8.3.4 Tiếp nhận cache, trục xuất, swap-out và tính toán lại
Việc giữ lại một tiền tố sau khi request kết thúc tồn tại để tiết kiệm việc tính toán lại lần sử dụng tiếp theo. Gọi là xác suất tiền tố được tái sử dụng, là thời gian tính toán lại, là thời gian lấy trạng thái về từ cache và chuẩn bị nó, và là thời gian cần để duy trì cache. Mỗi lần trúng tiết kiệm ; nhân với xác suất trúng và trừ đi thời gian duy trì cho giá trị tiết kiệm ròng kỳ vọng:
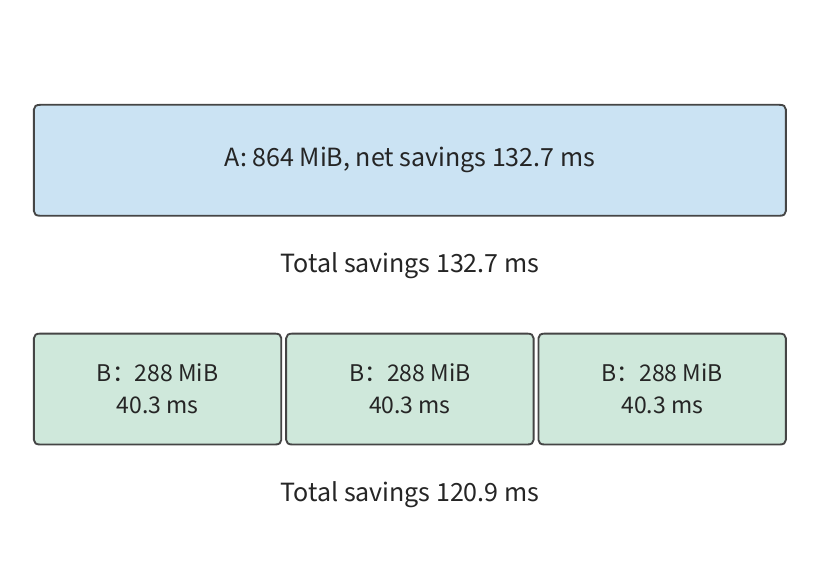
Lấy tiền tố chung 6144 token của request dài ở đầu chương làm ví dụ: KV của nó chiếm 864 MiB (0.906 GB). Tính lại tiền tố này trên một RTX PRO 6000 cần 96.5 TFLOP phép toán ma trận; tại 62% đỉnh BF16 mà prefill batch-1 trong Thí nghiệm 8-1 đạt được (Mục 8.6.3), việc này mất khoảng 307.9 ms. Sau khi swap tiền tố này ra bộ nhớ host, việc lấy nó về qua liên kết PCIe Gen5 x16 của card này (64 GB/s mỗi chiều) mất khoảng 14.2 ms; tính chi phí duy trì là một lượt truyền ghi lại về host trong lúc swap-out cho cùng 14.2 ms. Tại xác suất trúng 50%, khoản tiết kiệm trung bình là 132.7 ms. Để việc giữ lại tiền tố tiết kiệm thời gian, ta cần
Nếu liên kết host đổi sang PCIe Gen4 x16 (32 GB/s mỗi chiều), việc lấy về và swap-out mỗi thao tác tăng lên 28.3 ms, và mỗi lần trúng chỉ tiết kiệm 279.6 ms, nâng xác suất trúng tối thiểu cần thiết lên 10.1%. Swap-out giải phóng không gian accelerator, nhưng chỉ khi tiền tố được dùng đủ thường xuyên thì nó mới bù được thời gian cần cho việc lấy về và duy trì.
Việc một tiền tố đáng được giữ lại không có nghĩa là nó nên được giữ với ưu tiên. Khi không gian chật hẹp, một tiền tố lớn chiếm chỗ mà lẽ ra có thể chứa nhiều tiền tố nhỏ hơn. Gọi A là tiền tố 6144 token ở trên; mỗi tiền tố loại B chứa 2048 token và chiếm 288 MiB. Cũng được tính với việc lấy về và swap-out PCIe Gen5, việc tính toán lại mất 94.7 ms, lấy về và duy trì mỗi thao tác mất 4.7 ms, và với cùng xác suất trúng 50%, giá trị tiết kiệm kỳ vọng là 40.3 ms. Hình 8-22 đặt cả hai vào một cache cùng kích thước: giữ một A tiết kiệm 132.7 ms, trong khi giữ ba B tiết kiệm tổng cộng 120.9 ms. Thời gian tính toán lại tăng siêu tuyến tính với độ dài tiền tố — prefill cho 6144 token gấp 3.25 lần so với 2048 token — nên cùng một khối bộ nhớ mang lại lợi ích cao hơn khi dùng để giữ một tiền tố dài.
Phép so sánh này cũng có thể được quy đổi thành khoản tiết kiệm trên mỗi đơn vị dung lượng: A tiết kiệm khoảng 0.154 ms mỗi MiB, B khoảng 0.140 ms. Sắp xếp theo chỉ số này cho phép ta so sánh các tiền tố có kích thước khác nhau.
Lựa chọn trên giả định một điều kiện tiên quyết: tiền tố phải tồn tại cho đến khi được dùng lại. Khi dung lượng cache không đủ, ngay cả khi đầu vào của vòng tiếp theo giữ nguyên tiền tố, nó vẫn có thể phải được tính lại vì trạng thái đã bị trục xuất. Một lần tái phát 12 vòng đầu vào agent chứa 19,556 token đầu vào. Dưới cùng các request can nhiễu, một nhóm cache 6 GiB trúng 16,304 token, chỉ cần xử lý lại 3,252; một nhóm 1 GiB không trúng lần nào, đòi hỏi toàn bộ đầu vào phải được xử lý lại. Tăng thời gian chờ giữa các vòng liền kề thêm 0.2 giây không làm thay đổi số lần trúng. Trong phép so sánh này, việc tăng dung lượng giữ lại được tiền tố có thể tái sử dụng, trong khi chỉ đơn giản trì hoãn request của vòng tiếp theo không tạo ra hiệu quả tương đương.
Tiếp nhận cache (cache admission) quyết định liệu tiền tố của một request có được giữ lại sau khi request kết thúc hay không; chính sách trục xuất quyết định xóa tiền tố nào trước khi không gian cạn; chính sách swap-out quyết định chuyển trạng thái sang tầng lưu trữ nào; chính sách tính toán lại quyết định thực thi lại bao nhiêu token đầu vào. Với 16 request dài ở đầu chương, giữ một tiền tố dùng chung duy nhất chỉ cần 864 MiB, mà vừa tránh việc lưu trùng lặp vừa tiết kiệm phép tính prefill cho các request sau.
Bài tập 8-4 · Cốt lõi · Phân tích: một cache giới hạn nên giữ những tiền tố nào để tiết kiệm thời gian nhất? Không gian cache khả dụng là 864 MiB. Tiền tố A chứa 6144 token và chiếm 864 MiB; ba tiền tố loại B độc lập lẫn nhau mỗi cái chứa 2048 token và chiếm 288 MiB. Trên RTX PRO 6000, tính thời gian tính toán lại từ số phép toán ma trận tại 62% đỉnh BF16 503.8 TFLOP/s, tính thời gian lấy về tại 64 GB/s mỗi chiều qua PCIe Gen5 x16, và lấy thời gian duy trì là một lượt swap-out, bằng thời gian lấy về; xác suất trúng là 50% trong cả hai trường hợp. So sánh khoản tiết kiệm ròng kỳ vọng từ việc giữ một tiền tố A so với ba tiền tố loại B. Giữ xác suất trúng của loại B cố định, tìm ngưỡng xác suất trúng của A, dưới ngưỡng đó nên giữ ba B thay vào đó. Sau đó đổi liên kết sang PCIe Gen4 x16 (32 GB/s mỗi chiều) và làm lại phép so sánh. Với phần phân tích dữ liệu, đọc đầu vào 12 vòng và tái phát cache kèm theo, tính riêng tỉ lệ tiền tố chung và tỉ lệ trúng thực tế, và giải thích vì sao việc các request khác chiếm không gian cache ảnh hưởng đến tỉ lệ trúng thực tế.
8.4 Nén và Offloading
8.4.1 Footprint bộ nhớ sau khi lượng tử hóa trọng số
Chia sẻ tiền tố tiết kiệm không gian bằng cách loại bỏ KV trùng lặp. Ngay cả khi các request không chia sẻ tiền tố chung, lượng tử hóa vẫn có thể giảm dung lượng lưu trữ cần thiết cho trọng số và KV. Lượng tử hóa thường mã hóa các giá trị theo nhóm, lưu một giá trị mã hóa có độ rộng bit thấp hơn cho mỗi nhóm cùng với siêu dữ liệu như một scale; tại thời điểm tính toán, các giá trị này được dùng để khôi phục một giá trị gần đúng.
Q2_K là một định dạng lượng tử hóa theo nhóm được dùng trong các triển khai của họ thư viện tính toán tensor GGML; mã hóa chính của nó dùng 2 bit, với thông tin bổ sung được lưu cho scale trong mỗi nhóm. Trong định dạng này, mỗi nhóm có 256 giá trị; mã hóa 2 bit chiếm byte, và siêu dữ liệu như scale và giá trị tối thiểu chiếm thêm 20 byte. Vậy mỗi nhóm cần tổng cộng 84 byte, trung bình bit mỗi giá trị. Khi độ rộng bit giảm, tỉ trọng của siêu dữ liệu trong tổng dung lượng tăng tương ứng — trong định dạng này, lên khoảng 24%.
Ví dụ làm việc mở rộng: sau khi nạp trọng số lượng tử hóa vào bộ nhớ, vẫn có thể chứa được context dài bao nhiêu? Một biến thể tệp Q2_K của Qwen3-235B-A22B dùng lượng tử hóa theo nhóm chủ yếu bằng mã hóa 2 bit, trộn với vài độ rộng bit; các mã lượng tử hóa cộng với dữ liệu dấu phẩy động chưa lượng tử hóa tổng cộng khoảng 64.43 GiB, siêu dữ liệu lượng tử hóa khoảng 15.37 GiB, và với tiêu đề tệp cùng padding, tổng cộng khoảng 79.81 GiB. Một biến thể khác, UD-Q2_K_XL, khoảng 81.97 GiB. Lấy Apple M2 Max dùng trong Thí nghiệm 8-7 làm ví dụ, bộ nhớ hợp nhất (unified memory) của nó danh nghĩa là 96 GB (thập phân); dành 8 GiB cho hệ thống và không gian làm việc chỉ còn khoảng 81.41 GiB.
Sau khi nạp tệp đầu tiên vào bộ nhớ, còn lại 1.60 GiB; tệp thứ hai đã vượt quá không gian khả dụng khoảng 0.56 GiB. KV BF16 của model này cho context 8K chiếm khoảng 1.47 GiB, nên sơ đồ đầu tiên vẫn có thể xử lý một request, với khoảng 0.13 GiB dư. Nếu độ dài context tăng lên 32K, KV sẽ cần khoảng 5.88 GiB, đòi hỏi hoặc thêm bộ nhớ hoặc một cách lưu trữ trọng số khác. Hai tệp chỉ chênh nhau 2.16 GiB, nhưng chừng đó đã đủ để quyết định một request có thể được chứa hay không.
Trong một hệ thống bộ nhớ hợp nhất, CPU và GPU chia sẻ bộ nhớ vật lý. Sau khi một tệp trọng số được ánh xạ vào không gian địa chỉ, các trang của nó chỉ cần cư trú trong bộ nhớ vật lý khi dữ liệu tương ứng được truy cập. Nếu tổng khối lượng dữ liệu được truy cập trong quá trình thực thi vượt dung lượng bộ nhớ, các trang bị swap vào lặp đi lặp lại. Vậy để giải quyết tình trạng dung lượng không đủ, ta có thể hoặc giảm số byte mà bản thân dữ liệu chiếm giữ, hoặc chỉ giữ lại dữ liệu hiện đang cần và đưa phần còn lại vào ngay trước khi dùng. Mục tiếp theo trước tiên tính lợi ích của việc nén KV, sau đó phân tích thời gian cần để đưa trọng số vào.
8.4.2 Nén KV và chi phí đọc
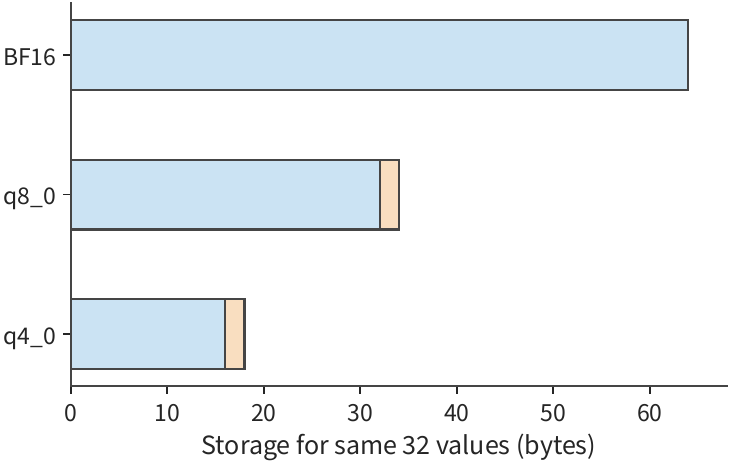
Áp dụng cùng phương pháp nhóm cho KV cho phép ta tính xem không gian tiết kiệm được có thể chứa thêm đầu vào của bao nhiêu request. Trọng số được chia sẻ giữa nhiều request, nhưng KV tiếp tục tăng liên tục theo đầu vào và đầu ra. Với model của chương này, KV BF16 cho một context 8K là 1152 MiB. Lượng tử hóa thay đổi độ rộng bit của mỗi giá trị, trong khi biểu diễn context thay đổi số giá trị phải lưu mỗi token: Mục 9.2.2 đặt cạnh nhau GQA và trạng thái MLA gọn nhẹ cho cùng context 8K, và trạng thái sau chỉ 549 MiB. Mỗi 32 giá trị BF16 chiếm 64 byte. q8_0 là một định dạng lượng tử hóa 8 bit chia sẻ một scale cho mỗi 32 giá trị. Chuyển sang q8_0 lưu 32 byte mã và 2 byte scale, trở thành so với ban đầu; q4_0 dùng cùng cách nhóm nhưng hạ độ rộng mã xuống 4 bit, lưu 16 byte mã và 2 byte scale, trở thành .
Vậy dung lượng cần cho cùng một context là
So với BF16, q8_0 tiết kiệm 540 MiB, q4_0 tiết kiệm 828 MiB. Bao gồm cả scale, hai định dạng này trung bình lần lượt 8.5 bit và 4.5 bit mỗi giá trị. Vì mỗi nhóm phải lưu một scale, siêu dữ liệu cũng tăng theo độ dài KV.
Hình 8-23 khôi phục bước này về một bố cục cấp byte. Mỗi hàng lưu cùng 32 giá trị: phần mã hóa ngắn lại, nhưng scale vẫn được giữ. Vậy tổng độ dài của q8_0 và q4_0 lần lượt là 34 và 18 byte, không phải 32 và 16 byte như độ rộng bit mã hóa đơn thuần gợi ý.
Sau khi request dài trong ví dụ làm việc mở đầu sinh xong, KV BF16 cấp theo khối chiếm tổng cộng 1188 MiB. Chuyển sang q8_0 với cùng bố cục cần MiB; với 16 request dài độc lập, tổng cộng khoảng 9.86 GiB, vừa trong 12 GiB bộ nhớ dành riêng. Điều này cho thấy chia sẻ và nén tiết kiệm không gian bằng những cách khác nhau: chia sẻ loại bỏ các tiền tố trùng lặp, trong khi nén giảm số byte mà mỗi giá trị chiếm giữ.
Khi tính attention với KV được nén, lượng đọc giảm, nhưng việc chuyển đổi định dạng tốn thêm thời gian. Gọi là số byte đọc ít hơn trong mỗi lần tính, là băng thông hiệu dụng, và là thời gian thực thi tuần tự thêm do chuyển đổi; khoản tiết kiệm thời gian ròng khi đó là
Ví dụ, chuyển một context 8K trên RTX PRO 6000 từ BF16 sang q8_0 đọc ít hơn 540 MiB. Tại băng thông hiệu dụng khoảng 1.16 TB/s trong điều kiện giới hạn đọc (Mục 8.6.3, 65% đỉnh 1792 GB/s), việc này tiết kiệm khoảng 0.487 ms. Nếu chuyển đổi thêm 0.2 ms, khoản tiết kiệm ròng khoảng 0.287 ms; nếu chuyển đổi thêm 0.8 ms, nó thay vào đó thêm khoảng 0.313 ms. Liệu cùng một định dạng nén có tăng tốc thực thi hay không phụ thuộc vào việc thời gian chuyển đổi có nhỏ hơn thời gian đọc tiết kiệm được hay không.
Context càng dài, thời gian tiết kiệm được từ việc đọc ít đi càng nhiều. Một đánh giá ban đầu chạy Llama-3.1-8B trên H100 khớp các khoảng đầu ra cho BF16 và FP8 lần lượt là và ms. Số hạng cố định của FP8 lớn hơn 0.14 ms, trong khi số hạng tăng theo mỗi token context nhỏ hơn ms. Chia chênh lệch chi phí cố định cho chênh lệch chi phí mỗi token context cho điểm giao nhau khoảng 7000 token; tại 2K, BF16 khoảng 6.53 ms và FP8 khoảng 6.63 ms, trong khi tại 16K chúng khoảng 7.16 và 6.97 ms tương ứng. Tại context dài hơn, thời gian tiết kiệm được từ việc đọc ít đi vượt quá chi phí cố định thêm vào.
Phần mở đầu của mục này lưu ý rằng biểu diễn context quyết định số giá trị phải lưu mỗi token; các hạng mục trạng thái cục bộ và toàn cục trong các model attention lai cũng có thể được so sánh theo dung lượng theo cách này. Dưới đường cơ sở context 8K, cộng dung lượng của lịch sử toàn cục và SWA hiệu dụng. Hai con số của DeepSeek V4.1 là 6.953 MiB và 2.578 MiB, tổng cộng 9.531 MiB; hai hạng mục tương ứng của V4 tổng cộng 30.521 MiB, khoảng 3.20 lần tổng của V4.1. Cửa sổ cục bộ chiếm không gian cố định, nên khoảng cách dung lượng gộp tại context ngắn nhỏ hơn khoảng cách 3.95 lần chỉ riêng của lịch sử toàn cục.
8.4.3 Offload trọng số, prefetch và di chuyển theo từng bước
Nén giảm kích thước của chính dữ liệu. Một cách khác để mở rộng dung lượng là để dữ liệu cư trú trên GPU theo hình thức luân phiên: đưa vào chỉ khi cần cho tính toán, và tái sử dụng không gian đó sau khi xong. Weight offloading chuyển một số trọng số vốn sẽ cư trú trên GPU sang bộ nhớ host, và sao chép chúng về GPU ngay trước khi tính toán layer tương ứng. Bộ nhớ accelerator được giải phóng có thể dùng cho KV, nhưng mỗi lần lan truyền tới phải sao chép lại các trọng số này. Khi một request sinh đầu ra từng bước, việc di chuyển này lặp lại với mọi vòng decode.
Ba ma trận BF16 của một layer FFN trong Qwen3-8B tổng cộng 288 MiB. Offload một trong mỗi bốn layer trên 36 layer sẽ offload chín bộ trọng số FFN, giải phóng 2592 MiB. GPU cũng phải dành trước không gian buffer cho prefetch (sao chép trọng số của một layer lên GPU trước khi tính layer đó): một bộ buffer chiếm 288 MiB, cho khoản tiết kiệm ròng 2304 MiB; hai bộ chiếm 576 MiB, cho khoản tiết kiệm ròng 2016 MiB. Lấy KV 1152 MiB của một đầu vào 8K làm đơn vị, cách trước có thể chứa thêm hai request như vậy, cách sau chỉ một. Nếu thay vào đó ta dành trước 1188 MiB cần thiết sau khi sinh xong, cả hai sơ đồ chỉ có thể chứa thêm một request hoàn chỉnh.
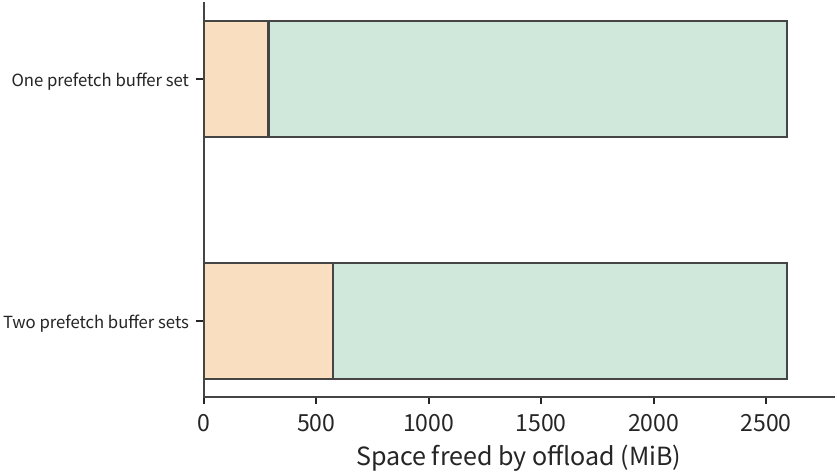
Prefetch phải tuân theo hai quan hệ thứ tự: phép tính chỉ có thể đọc trọng số sau khi bản sao hoàn thành, và buffer chỉ có thể được ghi bộ tiếp theo khi phép tính không còn cần bộ hiện tại. Với một bộ buffer, cùng một buffer lần lượt được dùng cho việc sao chép, tính toán và bản sao tiếp theo; với hai bộ, phép tính của một layer có thể tiến hành trong khi trọng số của layer tiếp theo được sao chép vào buffer kia. Điều này chồng lấp việc sao chép với tính toán, nhưng bản thân các buffer cũng dùng nhiều bộ nhớ hơn.
Trước tiên, tính chi phí liên kết của việc di chuyển này. Card này kết nối với host qua PCIe Gen5 x16, danh nghĩa 64 GB/s mỗi chiều. Mỗi vòng phải đưa vào 2592 MiB, tức 2.72 GB, cần
Con số này đã vượt quá 26.26 ms của một vòng decode batch-1. Ngay cả khi mọi phép tính khác có thể chồng lấp hoàn toàn với việc sao chép, mỗi vòng vẫn cần ít nhất khoảng 42.5 ms. Nếu mỗi vòng sinh một token cho mỗi một trong bốn request, tổng thông lượng đầu ra tối đa khoảng token/s, và khoảng đầu ra của mỗi request cũng ít nhất khoảng 42.5 ms. Sinh 256 token đầu ra cần 255 lần lan truyền tới tiếp theo, và riêng việc di chuyển trọng số đã mất khoảng 10.8 giây. Vậy offload các trọng số này qua PCIe không thể đáp ứng hạn chót hoàn thành 7 giây.
Cũng có những liên kết nhanh hơn nhiều giữa CPU và GPU. GH200 kết nối CPU Grace và GPU Hopper bằng NVLink-C2C, ở 450 GB/s mỗi chiều. Cùng 2.72 GB bây giờ mất ít nhất khoảng 6.0 ms mỗi vòng, tổng cộng khoảng 1.54 giây trong 255 vòng. Khi bản sao của mỗi vòng ngắn hơn một vòng tính toán decode, prefetch có thể che lấp hoàn toàn việc sao chép sau tính toán.
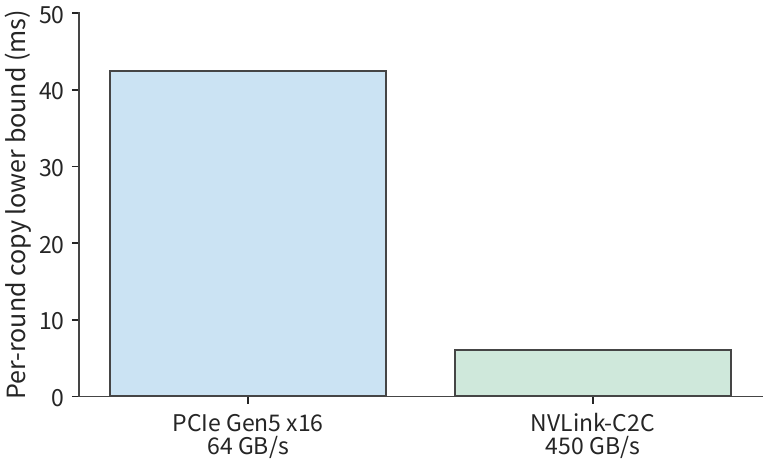
Điều quan trọng ở đây là tỉ số giữa khối lượng dữ liệu di chuyển mỗi vòng và băng thông hiệu dụng. Prefetch cho phép di chuyển và tính toán xảy ra đồng thời, nhưng số byte cần truyền mỗi vòng vẫn không đổi.
Nếu trọng số được nén trước khi di chuyển, thời gian giải nén cũng phải được cộng vào. Gọi byte là dữ liệu gốc, byte là kích thước nén, là băng thông liên kết, và là thông lượng giải nén (đo bằng byte đầu ra gốc). Truyền trọn rồi giải nén mất , trong khi truyền trực tiếp mất ; vậy nén trước khi di chuyển chỉ nhanh hơn khi
Nén 96 MiB trọng số xuống một phần tư kích thước, truyền trực tiếp qua PCIe Gen5 x16 mất khoảng 1.57 ms, trong khi truyền dữ liệu nén chỉ mất 0.39 ms; để giữ được khoản tiết kiệm 1.18 ms này, bộ giải nén phải xuất ra hơn 85.3 GB dữ liệu gốc mỗi giây. Liên kết càng nhanh, thông lượng giải nén cần thiết càng cao.
Trong offloading được thảo luận trong mục này, phép tính model vẫn luôn được thực thi bởi GPU, và bộ nhớ host chịu trách nhiệm giữ các trọng số không đang được dùng. Mục 9.3 sẽ dịch chuyển thêm chính vị trí của phép tính: một khi trọng số expert đã nằm trong bộ nhớ host, CPU có thể tính trực tiếp, chỉ gửi các activation nhỏ hơn về GPU — tại thời điểm đó ta cần so sánh số hàng đầu vào của mỗi expert, thời gian tính toán CPU và thời gian truyền trọng số.
Bài tập 8-5 · Tính toán: dung lượng tiết kiệm bằng offload trọng số so với việc di chuyển phát sinh. Giả sử chín bộ trọng số FFN được offload, mỗi bộ chiếm 288 MiB. Giả sử mỗi bộ buffer prefetch có thể chứa một bộ trọng số FFN; tính bộ nhớ accelerator ròng tiết kiệm được khi dùng một so với hai bộ buffer, và tìm xem không gian này có thể chứa thêm bao nhiêu trạng thái đầu vào 1152 MiB, hoặc bao nhiêu trạng thái request hoàn chỉnh 1188 MiB. Sau đó, lấy 64 GB/s mỗi chiều của PCIe Gen5 x16 và 450 GB/s mỗi chiều của GH200 NVLink-C2C tương ứng, tìm cận dưới của thời gian sao chép mỗi bước và của tổng thời gian cho 255 bước sao chép. Nếu tổng ngân sách thời gian cho toàn bộ việc sao chép là 1 giây, tìm băng thông một chiều tối thiểu cần thiết.
8.4.4 Chọn dung lượng và tốc độ dưới một ràng buộc chất lượng
Mục 8.4.2 đã tính không gian tiết kiệm được bằng nén và thời gian chuyển đổi thêm vào, nhưng chưa trả lời liệu câu trả lời có còn như cũ sau khi thay đổi định dạng số hay không. Ở đây, backend thực thi (execution backend) đề cập đến triển khai kernel thực sự thực hiện phép tính attention. Nén KV thay đổi các giá trị được lưu; việc đổi backend thực thi cũng có thể đồng thời thay đổi định dạng tính toán của Q, quá trình chuyển đổi và độ chính xác số của các phép toán khử. Việc so sánh từng hạng mục định dạng lưu trữ và độ chính xác tính toán của các tensor cho phép ta xác định chính xác nguồn gốc của sự khác biệt đầu ra.
Phần sau dùng tám tác vụ cố định cho phép so sánh từng hạng mục này; ba hình sắp xếp các tác vụ này theo cùng một thứ tự. Tám tác vụ đến từ các tài liệu có hai độ dài: mỗi tài liệu chứa 128 hoặc 512 bản ghi sáu chữ số, với bốn tài liệu độc lập ở mỗi độ dài, được ghi nhãn trong nhật ký thí nghiệm là n128-r0 đến n128-r3 và n512-r0 đến n512-r3, và được đánh số là tác vụ 1 đến 8 trong các hình theo thứ tự đó. Mỗi tác vụ chạy hai lần tại mỗi trong hai mức concurrency, so sánh ảnh hưởng của các định dạng số khác nhau bằng cùng một tác vụ.
Một bộ thí nghiệm Qwen3-8B giữ trọng số BF16 cố định và so sánh ba phương pháp tính attention. Trong 32 lượt chạy sinh tự nhiên, dùng KV BF16 trả lời đúng 28; chuyển sang triển khai FP8 gốc trả lời đúng 26; giữ KV FP8 nhưng khôi phục Q về BF16 lại trả lời đúng 28. Cấu hình cuối cùng này chỉ thay đổi độ chính xác của Q, và kết quả vẫn thay đổi — cho thấy định dạng lưu trữ của KV và độ chính xác tính toán của Q phải được xem xét riêng biệt.
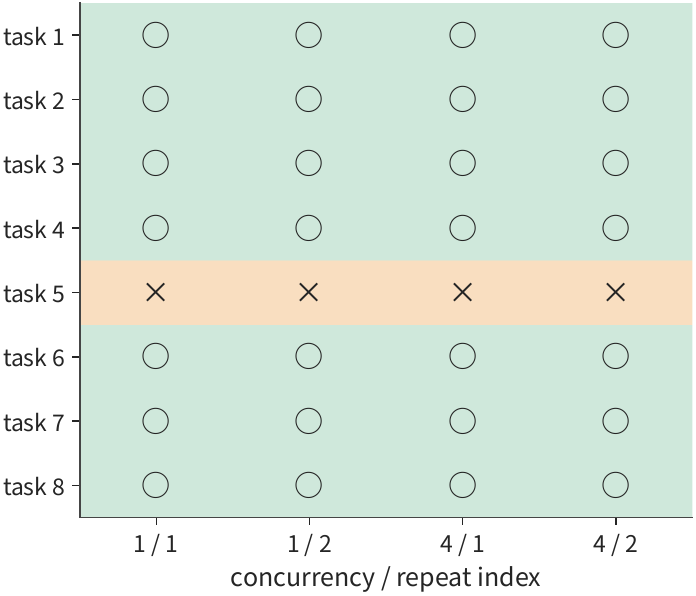
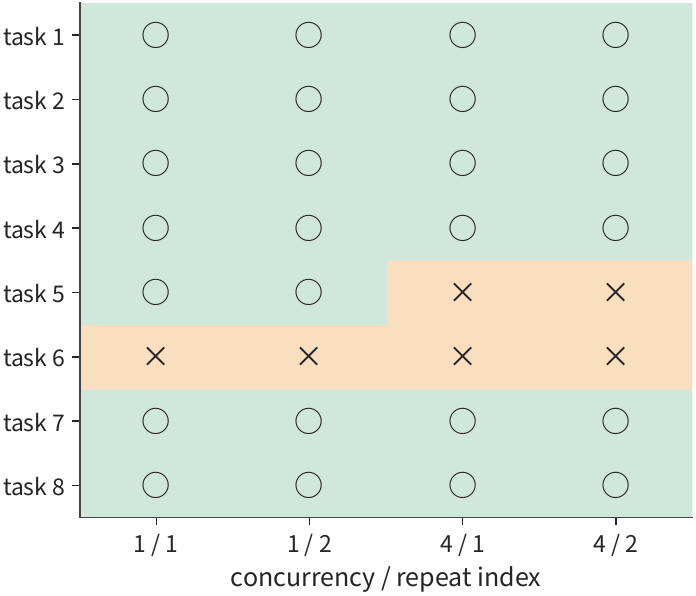
Hình 8-28 còn khôi phục chỉ riêng query Q về độ chính xác BF16, giữ KV ở FP8. So sánh cùng một cột qua ba hình tiết lộ những câu hỏi cụ thể nào có kết quả thay đổi, chứ không chỉ tổng số câu trả lời đúng.
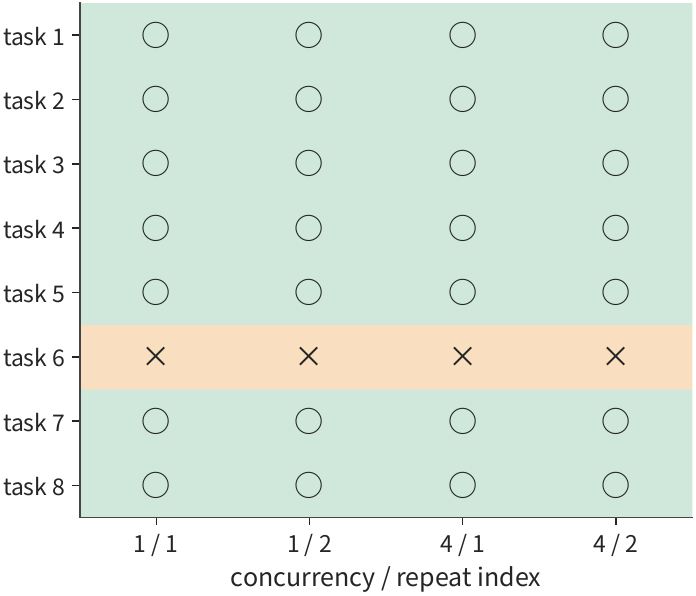
Trong hình, tác vụ 5 (n512-r0 trong nhật ký thí nghiệm, tài liệu dài đầu tiên với 512 bản ghi) sai cả bốn lần dưới KV BF16, nhưng đúng cả bốn lần dưới “KV FP8 + Q BF16”; tác vụ 6 (n512-r1) cho thấy chính xác mô hình ngược lại. Cả hai cấu hình đều trả lời đúng 28 câu tổng thể, nhưng các tác vụ trả lời sai là khác nhau. Xếp thẳng hàng kết quả của cùng một tác vụ cho phép ta thấy chính xác nơi khác biệt xảy ra, và liệu chúng có nhất quán qua các lần chạy lặp hay không.
Các lỗi cũng làm tăng thời gian cần để hoàn thành một tác vụ. Sau khi một câu trả lời đầu tiên thất bại và được thử lại, tổng thời gian để đạt một câu trả lời đúng phải bao gồm lần sinh đầu tiên, kiểm tra câu trả lời và sinh lại. Trong một thí nghiệm được ghi lại, hai lần thử lại đã sửa lỗi nhưng thêm khoảng 2.0 giây thời gian sinh và 92 token. Nếu câu trả lời đầu tiên nhanh hơn nhưng cũng dễ sai hơn, việc hoàn thành toàn bộ tác vụ có thể thực sự lâu hơn.
So sánh hai sơ đồ dung lượng KV đã thảo luận trước đó: 16 request dài độc lập chiếm khoảng 9.86 GiB với q8_0, so với khoảng 5.91 GiB với tiền tố BF16 dùng chung. Để đánh giá sơ đồ nào phù hợp hơn, ta cũng phải tính thời gian chuyển đổi, sinh và thử lại vào tổng thời lượng của mỗi request. Ví dụ làm việc toàn diện trong Mục 8.6 sẽ hoàn thành bước này.
Bài tập 8-6 · Phân tích dữ liệu: nén KV ảnh hưởng dung lượng, độ đúng của câu trả lời và chi phí thử lại như thế nào. Giả sử mỗi nhóm chứa 32 giá trị với thêm 2 byte cho scale, tính lại dung lượng KV cho một đầu vào 8K và một request dài hoàn chỉnh dưới các định dạng q8_0 và q4_0. Sau đó đọc từng hạng mục các kết quả kèm theo của ba cấu hình độ chính xác KV/Q, và liệt kê những câu hỏi nào đổi độ đúng giữa “KV BF16” và “KV FP8 + Q BF16”. Cuối cùng, đọc các bản ghi thử lại, cộng thời gian câu trả lời đầu tiên và các lần thử lại của mỗi tác vụ thành công, và so sánh với kết quả thu được khi chỉ đếm thời gian của lần sinh thành công cuối cùng.
8.5 Giải mã phỏng đoán (Speculative Decoding)
8.5.1 Bản nháp (draft), xác minh, rollback và tính đúng đắn
Hai mục trước chủ yếu thay đổi cách dữ liệu được lưu và đọc, nhưng mỗi request vẫn sinh từng vòng một. Nếu một phép tính model mục tiêu có thể xác định nhiều đầu ra cùng lúc, sinh 256 token sẽ không còn cần cùng số vòng. Trong decode thông thường, model mục tiêu tạo ra một token mỗi lượt lan truyền tới. Mục 8.2 gộp các request khác nhau vào một phép tính để một lần đọc trọng số phục vụ nhiều hàng hơn. Giải mã phỏng đoán đi theo một hướng khác: trước tiên tạo ra một chuỗi bản nháp (draft sequence) cho cùng request, sau đó để model mục tiêu xác minh đồng thời vài token của chuỗi đó. Nếu model mục tiêu chấp nhận nhiều token bản nháp, một phép tính duy nhất xác định nhiều đầu ra.
Bắt đầu với sinh tham lam (greedy generation): tại mỗi bước, chọn token mà model mục tiêu gán xác suất cao nhất. Giả sử chuỗi bản nháp chứa bốn token, và model mục tiêu tính toán, tại mỗi vị trí token, đầu ra lẽ ra phải là gì. Nếu hai token đầu khớp với bản nháp nhưng token thứ ba không khớp, kết quả cuối cùng giữ lại hai token bản nháp đầu và xuất ra token của model mục tiêu được chọn tại vị trí thứ ba. Token bản nháp thứ tư, được sinh sau token thứ ba sai, bị loại bỏ cùng với nó. Vòng tiếp theo tiếp tục sinh từ chuỗi đã sửa. Nếu cả bốn token bản nháp khớp, model mục tiêu thường có thể sinh thêm một token sau chúng.
Hình 8-29 cho thấy thứ tự xử lý khi token thứ ba phân kỳ. Dù model mục tiêu đã tính kết quả xác minh cho các token theo sau, token thứ tư phụ thuộc vào token bản nháp thứ ba sai và không thể được giữ lại. Một lượt xác minh cuối cùng giữ lại hai token bản nháp khớp và một token đã sửa, tổng cộng ba đầu ra.
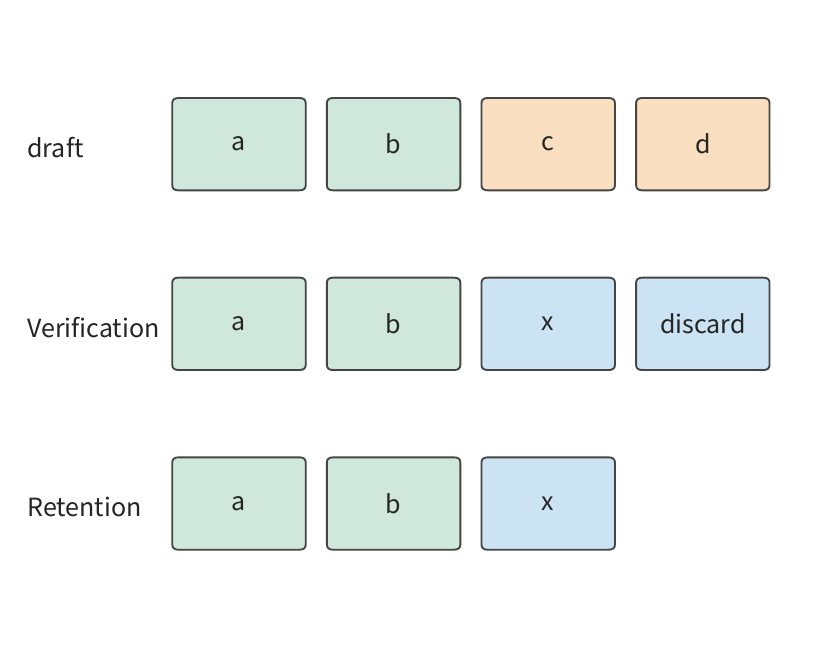
Với việc lấy mẫu ngẫu nhiên, đầu ra cuối cùng vẫn phải tuân theo phân bố xác suất của model mục tiêu. Gọi phân bố mục tiêu là và phân bố bản nháp là . Trước tiên lấy mẫu một token bản nháp từ , sau đó chấp nhận nó với xác suất sau:
Xác suất lấy mẫu và chấp nhận trực tiếp là . Để đạt xác suất mục tiêu , vẫn còn một thiếu hụt . Ở đây giữ lại chỉ phần chênh lệch dương. Vậy sau khi từ chối token bản nháp, phần dư dương này được chuẩn hóa và lấy mẫu lại từ phân bố kết quả. Kết hợp chấp nhận trực tiếp với từ chối-và-lấy-mẫu-lại, xác suất cuối cùng xuất ra chính xác là .
Minh họa điều này với một ví dụ đơn giản chỉ dùng hai ký hiệu, A và B. Phân bố mục tiêu là , . Nếu bản nháp luôn sinh A, chấp nhận A với xác suất ; trong thời gian còn lại, từ chối A và xuất ra B thay vào đó. Nếu bản nháp luôn sinh B, chấp nhận B với xác suất ; ngược lại xuất ra A thay vào đó. Cả hai phương pháp cuối cùng đều cho phân bố mục tiêu, nhưng xác suất chấp nhận của bản nháp khác nhau, và hiệu quả thực thi thu được cũng khác nhau.
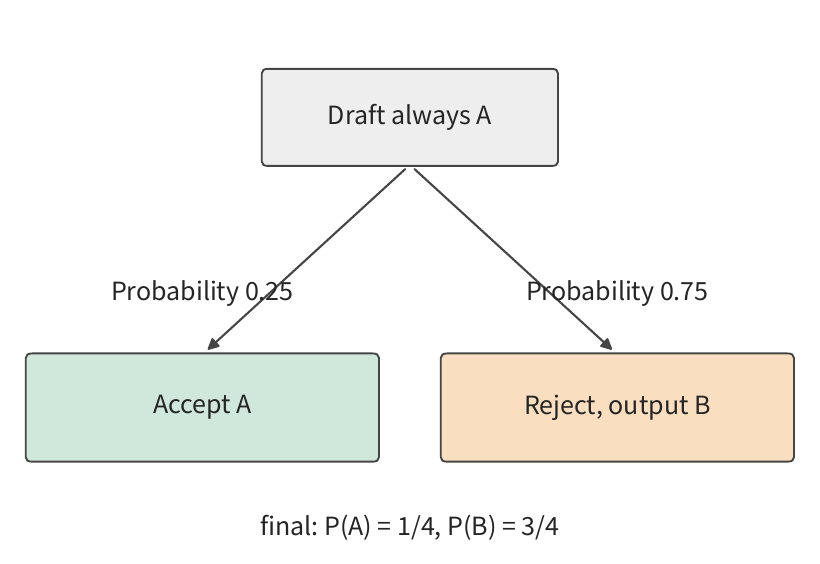
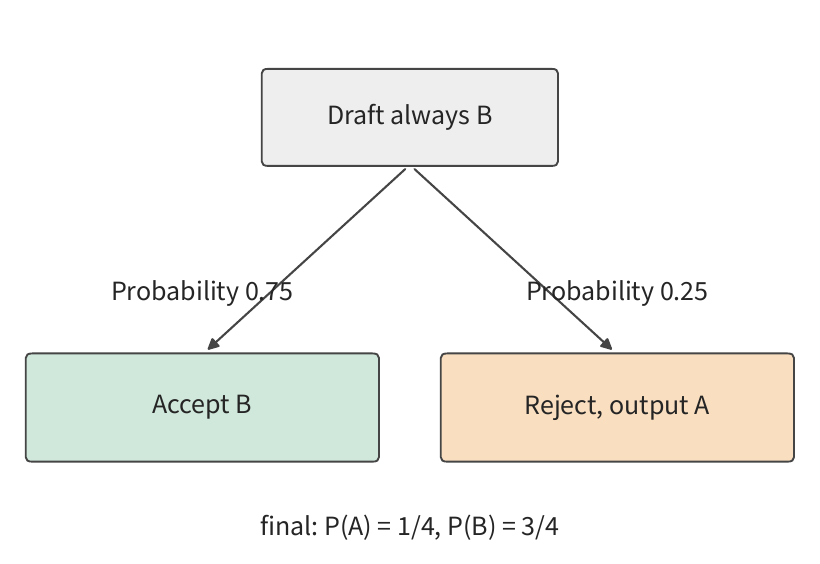
Sau khi xác minh, độ dài KV hiệu dụng được điều chỉnh về vị trí đầu ra đã xác nhận, và KV tương ứng với các token bản nháp bị loại bỏ không còn tham gia vào phép tính tiếp theo. Trình phân trang cập nhật các tham chiếu khối theo độ dài đầu ra đã xác nhận, và bộ lấy mẫu cùng bộ kiểm tra ngữ pháp (thành phần giới hạn các token hợp lệ theo một định dạng đầu ra chỉ định) cũng được khôi phục về trạng thái tương ứng. Vòng tiếp theo sau đó tiếp tục tính toán từ chuỗi đã sửa.
8.5.2 Độ trễ mỗi vòng và số lượng đầu ra
Giải mã phỏng đoán thay đổi cả độ trễ mỗi vòng lẫn số token cuối cùng xuất ra mỗi vòng. Gọi vòng mất thời gian và xuất ra token; khi đó, qua nhiều vòng liên tiếp, độ trễ trung bình mỗi token đầu ra là
Ví dụ, nếu hai vòng mỗi vòng mất 1.5 ms và xuất ra lần lượt 1 và 5 token, tổng cộng là 3 ms cho 6 token, cho trung bình 0.5 ms mỗi token. Nếu thay vào đó người ta trước tiên tính trung bình mỗi vòng rồi lấy trung bình không trọng số của 1.5 và 0.3 ms/token, kết quả là 0.9 ms. Điều này tương đương với việc cho vòng chỉ xuất ra một token cùng trọng số với vòng xuất ra năm token. Chỉ chia tổng thời gian cho tổng số token mới cho độ trễ trung bình đúng trên mỗi token.
Ví dụ làm việc: tỉ lệ chấp nhận bản nháp quyết định số đầu ra trung bình mỗi vòng như thế nào? Tiếp tục với phân bố mục tiêu hai ký hiệu, giả định tính độc lập giữa các vị trí token. Mỗi vòng bản nháp sinh bốn bản sao của cùng một ký hiệu; đầu ra cuối cùng cũng bao gồm token đã sửa khi từ chối, hoặc một token thừa nếu tất cả đều được chấp nhận. Gọi là xác suất chấp nhận tại vị trí hiện tại, với điều kiện mọi token bản nháp trước đó đã được chấp nhận. Mỗi vòng xuất ra ít nhất một token; xuất thêm token thứ hai đòi hỏi chấp nhận token bản nháp đầu tiên, với xác suất ; xuất thêm token thứ ba đòi hỏi chấp nhận hai token đầu, với xác suất . Cộng các số hạng này lại, số đầu ra trung bình mỗi vòng là
Mỗi số hạng trên biểu thị xác suất “cuối cùng xuất ra ít nhất chừng này token”. Khi bản nháp là AAAA, , và số đầu ra trung bình mỗi vòng khoảng 1.33 token; khi bản nháp là BBBB, , và số đầu ra trung bình khoảng 3.05. Trên RTX PRO 6000, tại batch 1 với context 2K, decode thông thường mất 26.26 ms mỗi vòng (Thí nghiệm 8-1). Khi xác minh 5 vị trí, lượng đọc trọng số và KV giống như decode thông thường; phép tính ma trận thêm cho 4 hàng bổ sung lên tới khoảng 65 GFLOP, tại 62% đỉnh BF16 chỉ mất khoảng 0.2 ms, nên một vòng xác minh vẫn được tính là 26.26 ms. Thí nghiệm 8-5 quan sát thấy cùng hiện tượng: DFlash (một mạng bản nháp tạo ra toàn bộ một đoạn bản nháp song song trong một lượt lan truyền tới) sinh 7 token bản nháp mỗi vòng và xác minh 8 vị trí, với độ trễ trung vị 15.2 ms — tương đương với 16.9 ms của một bước decode thông thường trong cùng cấu hình. Cộng thêm 0.1 ms để truy vấn bản nháp, một vòng tổng cộng 26.36 ms, và hai cấu hình bản nháp tương ứng với độ trễ trung bình mỗi token khoảng 19.8 và 8.64 ms — cả hai đều nhanh hơn 26.26 ms/token của decode thông thường. Việc xác minh hầu như không làm tăng thời lượng của vòng, và ngay cả khi hầu hết token bản nháp bị từ chối, mỗi vòng vẫn cho ít nhất một token, nên ngay cả AAAA có tỉ lệ chấp nhận thấp vẫn đạt được gia tốc.
Thời gian tiết kiệm được bằng cách chấp nhận nhiều token bản nháp hơn cũng có thể bị triệt tiêu bởi chi phí truy vấn. Để vượt qua decode thông thường, tổng thời gian của một vòng phải nhỏ hơn số đầu ra trung bình nhân 26.26 ms. Sau khi trừ 26.26 ms cần cho việc xác minh, AAAA chừa khoảng 8.7 ms cho việc truy vấn bản nháp, trong khi BBBB chừa khoảng 53.9 ms. Hình 8-32 vẽ hai điểm giao nhau này lên trục chi phí truy vấn.
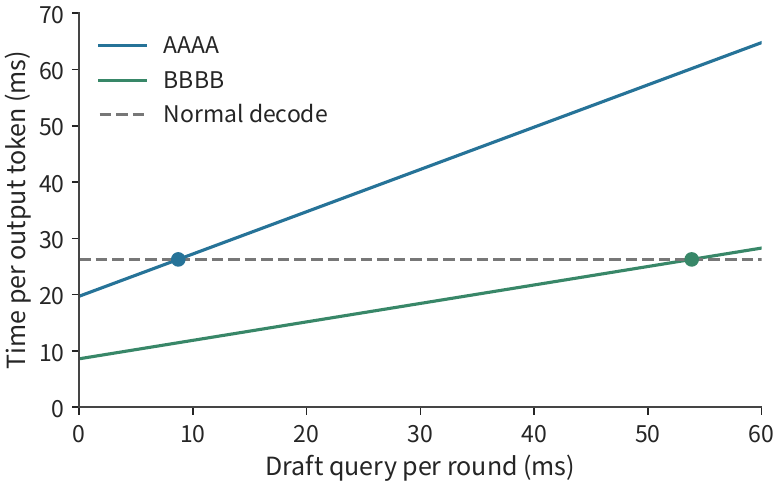
Công việc chuẩn bị trước khi dùng một bản nháp cũng phải được tính vào tổng thời gian. Nếu việc xây dựng một chỉ mục context mất 2 giây, và bản nháp BBBB tiết kiệm khoảng ms cho mỗi token đầu ra, thì sinh khoảng 114 token sẽ bù được 2 giây chi phí này. Một request xuất ra 256 token bằng decode thông thường mất khoảng 6.72 giây; xây dựng chỉ mục trước trong 2 giây rồi dùng bản nháp BBBB dự kiến mất khoảng 4.22 giây. Nếu chỉ mục có thể được xây dựng trước và chia sẻ giữa nhiều request, chi phí này có thể được phân bổ cho nhiều đầu ra hơn nữa.
8.5.3 Nguồn bản nháp và các phương pháp sinh tuần tự so với song song
Bốn token bản nháp tiết kiệm được bao nhiêu thời gian phụ thuộc cả vào số token vượt qua xác minh lẫn thời gian cần để tạo ra đoạn bản nháp đó. Các hệ thống thực tế có thể tra cứu bản nháp từ context, hoặc gọi một mạng bổ sung để tạo bản nháp; hai lựa chọn này mang lại các thời gian chuẩn bị và footprint bộ nhớ khác nhau.
Tra cứu context tìm các đoạn lặp lại từ đầu vào hoặc các phản hồi hiện có, với chi phí chính là việc khớp và xây dựng chỉ mục. Một model nhỏ độc lập sinh bản nháp từng bước đòi hỏi bộ nhớ bổ sung cho trọng số và KV của chính nó. Các phương pháp kiểu EAGLE đưa các biểu diễn trung gian của model mục tiêu vào một mạng dự đoán nhỏ hơn; các phương pháp kiểu DFlash sinh nhiều token bản nháp song song. Một đầu MTP được tích hợp trong model dùng khả năng dự đoán được huấn luyện chung để tạo bản nháp.
Chia mỗi vòng thành bốn giai đoạn — sinh bản nháp, chuẩn bị xác minh, xác minh mục tiêu và xác định đầu ra — cho phép so sánh các phương pháp này từng số hạng. Lấy mạng bản nháp DFlash trong Thí nghiệm 8-5 làm ví dụ; trọng số của nó khoảng 1.95 GiB (2.10 GB). Tại băng thông hiệu dụng của batch 1 (26.26 ms để đọc 15.44 GB, khoảng 588 GB/s), một lượt lan truyền tới của mạng này mất khoảng 3.57 ms. Sinh bốn token bản nháp từng cái một sẽ cần bốn lượt lan truyền tới, tổng cộng 14.28 ms; sinh toàn bộ đoạn bản nháp song song, như DFlash làm, chỉ cần một lượt lan truyền tới, khoảng 3.57 ms. Xác minh mục tiêu cần 26.26 ms trong cả hai trường hợp. Nếu mỗi vòng cuối cùng xuất ra trung bình 3 token, cách tuần tự tốn khoảng ms mỗi token, trong khi cách song song tốn khoảng ms mỗi token. Ở đây, gia tốc đến từ việc rút ngắn thời gian sinh bản nháp.
Bây giờ giả sử tỉ lệ chấp nhận của bản nháp song song thấp hơn, và số đầu ra trung bình giảm xuống 2. Độ trễ trung bình mỗi token đầu ra tăng lên ms — chậm hơn cách tuần tự. Việc sinh bản nháp nhanh hơn tiết kiệm 10.7 ms, nhưng với ít đầu ra hơn mỗi vòng, thời gian được phân bổ cho mỗi token đầu ra tăng lên, và request tổng thể trở nên chậm hơn.
8.5.4 Chọn động độ dài bản nháp và tranh chấp concurrency
Một khi nguồn bản nháp được cố định, người ta cũng phải quyết định bản nháp của mỗi vòng nên dài bao nhiêu. Bản nháp dài hơn nâng cận trên của số token một vòng có thể xuất ra. Nhưng chỉ khi các token trước đó đều được chấp nhận thì các token sau mới có cơ hội lọt vào đầu ra cuối cùng. Gọi là xác suất chấp nhận có điều kiện của token thứ với điều kiện mọi token bản nháp trước đó đã được chấp nhận; khi đó số đầu ra trung bình cho một bản nháp độ dài là
Tăng độ dài bản nháp từ lên làm tăng đầu ra trung bình thêm token. Giả sử việc này thêm thời gian; ban đầu vòng mất thời gian và xuất ra trung bình token, cho độ trễ trung bình mỗi token đầu ra là . Để độ dài bản nháp tăng lên cho độ trễ trung bình mỗi token đầu ra ngắn hơn, ta cần , biến đổi thành
Nói cách khác, thời gian trung bình phải trả cho đầu ra mới được thêm phải thấp hơn độ trễ trung bình ban đầu mỗi token. Vì các xác suất chấp nhận được nhân liên tiếp, các token bản nháp sau có xác suất sống sót giảm dần, khiến chúng càng khó mang lại lợi ích thời gian đủ lớn.
Shape thực thi định sẵn cũng ảnh hưởng đến thời gian thêm . Nếu xác minh bốn hoặc năm token đều pad vector đặc trưng của mỗi token lên ma trận tám hàng và dùng một đồ thị tính toán tám hàng chuẩn bị sẵn, thêm một token nữa đòi hỏi tương đối ít phép tính thêm; nhưng nếu số token cần xác minh tăng từ tám lên chín, đòi hỏi pad lên ma trận mười sáu hàng và chuyển sang đồ thị tính toán tương ứng, phép tính nhảy vọt đột ngột. Số request đồng thời cũng ảnh hưởng đến lợi ích của giải mã phỏng đoán: dưới tải thấp, xác minh nhiều hàng có thể dùng phần tính toán nhàn rỗi; dưới tải cao, batching thông thường đã chia sẻ trọng số hiệu quả, và việc sinh và xác minh bản nháp còn phải tranh chấp thêm với các request khác về tài nguyên accelerator và bộ nhớ.
Một bộ phép đo so sánh các độ dài bản nháp khác nhau. K7 và K15 ký hiệu các cấu hình sinh lần lượt 7 và 15 token bản nháp mỗi vòng. Với tác vụ trích xuất ngắn của Qwen3-8B/DFlash tại concurrency 1, độ trễ toàn phần trung vị của decode thông thường, K7 và K15 lần lượt khoảng 90.0, 30.6 và 29.4 ms. Chuyển từ thực thi thông thường sang K7 tiết kiệm khoảng 59 ms, trong khi đi từ K7 sang K15 chỉ tiết kiệm thêm khoảng 1.2 ms. Các bản ghi từng vòng cũng cho thấy các vòng trong đó cả hai độ dài khối chỉ chấp nhận một token bản nháp duy nhất: K7 loại bỏ sáu token bản nháp, K15 loại bỏ mười bốn, và độ dài đầu ra cuối cùng giống nhau. Khối xác minh lớn hơn làm tăng phép tính mà không tạo ra nhiều đầu ra hơn trong vòng đó.
Do đó, khi điều chỉnh động độ dài bản nháp, có thể áp dụng điều kiện trên: sinh bản nháp dài hơn cho các request có xác suất chấp nhận cao và thời gian thêm thấp cho mỗi vị trí xác minh, và rút ngắn độ dài khối cho các request thường thất bại xác minh ở vài vị trí đầu, hoặc những request cần chuyển sang một shape thực thi lớn hơn. Khi xác định độ dài bản nháp, người ta cũng phải chừa không gian cho KV của cả model mục tiêu lẫn model bản nháp, rồi làm theo phương pháp trong Mục 8.3 để quyết định tiếp nhận bao nhiêu request.
Bài tập 8-7 · Suy diễn: độ dài bản nháp nào tối thiểu hóa độ trễ trung bình mỗi token đầu ra? Cố định xác suất chấp nhận bản nháp ở , và tính số token đầu ra trung bình mỗi vòng cho các độ dài khối bản nháp 1, 2, 4 và 8. Dùng dữ liệu RTX PRO 6000 từ Mục 8.5.3, làm tròn đến một chữ số thập phân: một vòng xác minh mất 26.3 ms, và mạng bản nháp sinh token từng cái một ở 3.6 ms mỗi token bản nháp, tức ms; tìm độ trễ trung bình mỗi token đầu ra cho mỗi độ dài khối. Sau đó giả sử bản nháp thực thi theo nhóm 4 vị trí, với các nhóm không đầy vẫn được tính thời gian như các nhóm đầy, tức ms; so sánh độ dài khối 4 và 5, và dùng điều kiện biên để giải thích lựa chọn.
8.6 Hiệu năng và các lựa chọn cấu hình dưới tải request
8.6.1 Tốc độ đến, xếp hàng, tiếp nhận và hủy bỏ
Các mục 8.2 đến 8.5 thảo luận cách thay đổi footprint bộ nhớ và phương pháp thực thi của một instance. Việc phục vụ trực tuyến cũng phải xử lý các request đến liên tục: trước khi một request hoàn thành, request tiếp theo đã vào hàng đợi; trong khi một request chờ công cụ trả về, phép tính model tạm dừng, nhưng KV của nó vẫn phải được giữ lại. Bộ lập lịch do đó vừa phải sắp xếp phép tính hiện tại vừa giữ trạng thái cho các request đang sinh hoặc chờ để tiếp tục.
Cần bao nhiêu không gian để giữ trạng thái của các request chưa hoàn thành này phụ thuộc vào số request trung bình có mặt trong hệ thống. Trong dịch vụ trạng thái ổn định, số request trung bình trong hệ thống tuân theo định luật Little (Little’s Law):
trong đó là tốc độ đến trung bình và là thời gian trung bình một request ở trong hệ thống. Cộng thời gian cư trú của mọi request quan sát được và chia cho thời lượng quan sát cho số request trung bình trong hệ thống. Ví dụ, tại tốc độ đến 4 request mỗi giây với thời gian cư trú trung bình 0.5 giây, hệ thống giữ trung bình 2 request; nếu thời gian cư trú trung bình tăng lên 2 giây, con số này trở thành 8.
Một số request trong số này đang xếp hàng, một số đang tính toán, và một số chỉ giữ trạng thái. Tăng batch size có thể nâng thông lượng đầu ra, nhưng lượng đọc KV, phép tính và các chi phí khác dần giới hạn sự tăng trưởng này. Khi tốc độ xử lý không còn theo kịp tốc độ đến tăng lên, các request mới tích tụ trong hàng đợi, và thời gian chờ tăng tương ứng.
Điều khiển tiếp nhận (admission control) quyết định có bắt đầu xử lý một request mới hay không. Trước khi chấp nhận một request, hãy kiểm tra không gian KV khả dụng và còn bao nhiêu thời gian trước hạn chót. Với request ngắn trong Mục 8.1, 0.196 giây đến đầu ra đầu tiên cộng 6.76 giây sinh đã dùng 6.95 giây; xếp hàng thêm 0.1 giây sẽ vượt quá thời gian chờ. Việc xác định trước các request như vậy cho phép hệ thống từ chối chúng, chuyển chúng sang một instance khác, hoặc dùng một cấu hình thực thi nhanh hơn. Hủy bỏ (cancellation), ngược lại, ngừng lập lịch các vòng tiếp theo khi một request đã mất tính hữu ích, và giải phóng không gian của nó một khi các phép toán accelerator đang bay hoàn thành.
Các tối ưu hóa này tương tác với nhau. Nén KV cho phép một instance tiếp nhận nhiều request đồng thời hơn; batch lớn hơn, đến lượt nó, cho phép decode thông thường chia sẻ trọng số hiệu quả hơn, thay đổi lợi ích tương đối của giải mã phỏng đoán. Phần sau áp dụng các thay đổi này cho cùng một tập request, tính thời gian thực thi và footprint bộ nhớ gộp.
8.6.2 Thông lượng hiệu dụng dưới các ràng buộc chất lượng và SLO
Chỉ nhìn vào độ dài hàng đợi và tốc độ hoàn thành không thể biết người dùng có thực sự nhận được một câu trả lời dùng được hay không. Các thí nghiệm chất lượng trong Mục 8.4.4 tạo ra các câu trả lời sai, trong khi xếp hàng tạo ra các phản hồi đúng-nhưng-muộn. Chỉ khi đếm chung cả hai loại tổn thất mới có thể đánh giá hiệu quả dịch vụ. Gọi cửa sổ quan sát có độ dài , để khi request đúng, và khi nó hoàn thành đúng hạn. Đếm theo các request hoàn thành, thông lượng hiệu dụng là
Tử số chỉ đếm các request vừa đúng vừa hoàn thành đúng hạn. Nếu thay vào đó tử số đếm mọi request hoàn thành, ta có thông lượng hoàn thành. Khoảng cách giữa hai giá trị cho thấy bao nhiêu công suất xử lý đã đi vào các câu trả lời sai hoặc muộn.
Một bộ phép đo cho thấy kích thước của hai loại tổn thất này. Thí nghiệm truy hồi Qwen3-8B dùng cùng tám câu hỏi, yêu cầu các request hoàn thành đúng trong vòng 3 giây kể từ khi đến, và so sánh ba chế độ: tiếp nhận từng cái một (individual admission), continuous batching, và đệ trình toàn bộ các request cùng lúc. Mỗi thí nghiệm đệ trình 16 request; qua tất cả các thí nghiệm, tổng cộng 336 phản hồi được sinh ra, trong đó 294 câu trả lời đúng, nhưng chỉ 155 cũng đáp ứng được hạn chót. 139 phản hồi đúng còn lại trả về quá muộn để đáp ứng yêu cầu dịch vụ.
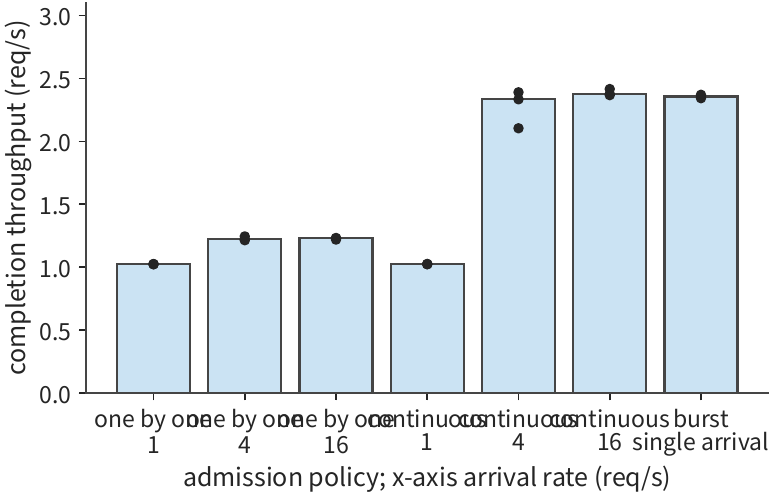
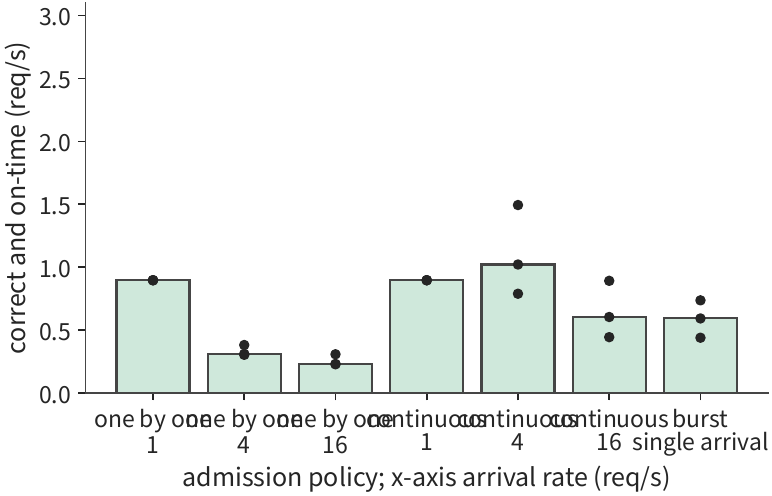
Tại tốc độ đến 1/s, cả hai chiến lược trực tuyến đạt thông lượng hiệu dụng khoảng 0.90 req/s. Với ít công việc hơn mỗi batch, tiếp nhận từng cái một cũng có thể xử lý kịp phần lớn các request đúng. Khi tốc độ đến tăng lên 4/s, thông lượng hoàn thành của tiếp nhận từng cái một khoảng 1.22 req/s, nhưng thông lượng hiệu dụng của nó giảm xuống 0.31 req/s; hàng đợi dài ra, và nhiều đầu ra đúng bỏ lỡ hạn chót. Continuous batching nâng thông lượng hoàn thành lên khoảng 2.33 req/s, với thông lượng hiệu dụng đạt khoảng 1.02 req/s — nhiều request hơn hoàn thành trong hạn chót.
Đẩy tiếp tốc độ đến của continuous batching lên 16/s, thông lượng hoàn thành chỉ tăng lên khoảng 2.38 req/s, trong khi thông lượng hiệu dụng thay vào đó giảm xuống khoảng 0.60 req/s, giảm khoảng 41%. Thông lượng hoàn thành về cơ bản đã ngừng tăng; nhiều request đến chủ yếu thêm vào thời gian xếp hàng. Với tập các cửa sổ này, 4/s trả về nhiều câu trả lời đúng đúng hạn hơn 16/s. Khi chọn một cấu hình dịch vụ, trước tiên tìm tốc độ đến tại đó thông lượng hiệu dụng bắt đầu suy giảm, rồi giới hạn số request mới được tiếp nhận để tránh thời gian xếp hàng quá mức.
Với việc tiếp nhận từng cái một, các request khác chưa vào engine vẫn chờ trong hàng đợi ứng dụng. Việc tính thời gian do đó nên bắt đầu từ thời điểm đến theo lịch trình ban đầu của mỗi request, bao gồm cả khoản chờ bên ngoài engine này. Kết hợp các phép đo trong mục này, người ta phải tính riêng accelerator xuất ra bao nhiêu token mỗi giây, một request đơn chờ bao lâu, và mỗi giây có bao nhiêu request đúng và đúng hạn.
8.6.3 Cấu hình, accelerator và chi phí toàn tác vụ
Trước khi so sánh các cấu hình, hãy quy đổi các phép đo thành tốc độ xử lý. Một khi batching, độ chính xác và cài đặt cache được cố định, chia công việc hoàn thành cho thời gian chiếm dụng accelerator cho tốc độ xử lý thực tế của từng giai đoạn: tốc độ prefill , đo bằng số token đầu vào mới được xử lý mỗi giây, và tốc độ decode , đo bằng số lần gọi decode hoàn thành mỗi giây. Khi nhiều request trong một batch chia sẻ một lượt thực thi, mỗi request được tính là một lần gọi hoàn thành, và thời gian chiếm dụng chỉ được đếm một lần. Với một request có token đầu vào mới và token đầu ra, thời gian chiếm dụng accelerator (tính bằng GPU-giây) là
Nếu không có phép đo khớp, người ta có thể ước tính bằng cách nhân các giá trị thông số kỹ thuật với hiệu suất: thời gian prefill được ước tính là phép tính ma trận chia cho tích của đỉnh tính toán và hiệu suất tính toán; thời gian một vòng decode được ước tính là số byte trọng số và KV được đọc chia cho tích của băng thông đỉnh và hiệu suất băng thông. Bảng dưới đây cho hiệu suất đo được trên RTX PRO 6000 trong Thí nghiệm 8-1. Một vòng decode được lấy từ các vòng trong nhật ký từng vòng của engine không bao gồm prefill; khoảng thời gian mà client thấy còn bao gồm thời gian giao hàng và dài hơn một chút, ví dụ 26.5 ms trong Mục 8.1.1.
| Context 2K, không có tiền tố dùng chung | batch 1 | batch 4 | batch 16 | batch 64 |
|---|---|---|---|---|
| Trọng số và KV đọc mỗi vòng | 15.44 GB | 16.34 GB | 19.97 GB | 34.46 GB |
| Thời gian cần tại 1792 GB/s | 8.62 ms | 9.12 ms | 11.14 ms | 19.23 ms |
| Vòng decode đo được | 26.26 ms | 26.62 ms | 27.44 ms | 29.63 ms |
| Hiệu suất băng thông decode | 33% | 34% | 41% | 65% |
| Hiệu suất tính toán prefill | 62% | 61% | 61% | 58% |
Hiệu suất decode tăng theo batch size không phải vì việc đọc trở nên nhanh hơn. Thí nghiệm này tắt CUDA Graph, nên mỗi vòng phải đệ trình các kernel từng cái một: lượng đọc tăng từ 15.44 GB lên 34.46 GB, trong khi vòng chỉ tăng từ 26.26 ms lên 29.63 ms — batch càng lớn, chi phí gần như cố định này được phân bổ cho càng nhiều byte. Hiệu suất prefill, trong khi đó, giữ ổn định ở 58%–62% đỉnh BF16; với đầu vào 8K có 6K đầu tiên đã được cache, con số là 52%–58%.
Hiệu suất băng thông trong bảng là MBU từ Mục 1.2.2, và hiệu suất tính toán là MFU. Tại batch 1, một vòng decode vượt cận dưới đọc 8.62 ms khoảng 17.6 ms, và khoảng cách này hầu như không đổi theo lượng đọc. Theo tiêu chí trong Mục 1.3.4, đây không phải là chi phí của model mà là chi phí đệ trình các kernel từng cái một cùng với việc lập lịch và đồng bộ phía host — loại chi phí mà CUDA Graph và lập lịch tốt hơn có thể loại bỏ; trường hợp vLLM v0.6.0 trong Mục 5.5.1 cho thấy chi phí phía host có thể được giảm đến đâu.
Ví dụ toàn diện: chọn các cấu hình chia sẻ tiền tố, nén và phỏng đoán dưới các ràng buộc bộ nhớ và hạn chót. Thông lượng hiệu dụng cung cấp tiêu chuẩn để đánh giá dịch vụ, trong khi phân tích dung lượng và thời gian có thể loại trừ các cấu hình không phù hợp trước khi chạy bất cứ thứ gì. Lấy instance inference được định nghĩa ở đầu chương: RTX PRO 6000 cấp 32 GiB cho instance này; sau khi trừ trọng số và không gian làm việc cơ bản, còn 12 GiB cho KV và các buffer phụ trợ. Mười sáu request dài đến đồng thời, mỗi cái có 8192 token đầu vào và 256 token đầu ra, trong đó 6144 token đầu vào đầu tiên giống hệt nhau; hạn chót là 7 giây. Bốn sơ đồ dưới đây được so sánh, giả định cả bốn đều cho câu trả lời đúng. Sơ đồ chia sẻ đã cache tiền tố chung trước khi các request đến. Sơ đồ phỏng đoán dùng model bản nháp DFlash từ Thí nghiệm 8-5. Bật nó làm tăng bộ nhớ GPU đỉnh của tiến trình khoảng 3.1 GiB (từ 17,706 MiB lên 20,894 MiB), trong đó khoảng 1.95 GiB là trọng số của model bản nháp. Model bản nháp cũng phải xử lý đầu vào; trong Thí nghiệm 8-5, với đầu vào khoảng 2300 token, thời gian đến token đầu tiên tăng từ 129.4 ms lên 141.6 ms, tăng 9.4%. Giả sử tập request này trung bình 3 token đầu ra mỗi vòng.
Sơ đồ chia sẻ cho tập request này chính xác là điều kiện được đo trong Thí nghiệm 8-1: đầu vào 8K, 6K đầu được cache, batch 16. Giai đoạn prefill xử lý 32,768 token mới trong 2.04 giây, cho token mới/s, đạt 58% đỉnh tính toán; sau đó mỗi vòng decode mất 27.35 ms, cho lần gọi/s. Mỗi request chiếm GPU-giây, tổng cộng khoảng 9.01 GPU-giây cho 16 request. Các sơ đồ còn lại được suy ra từ bảng này và các phép đo trong cùng điều kiện; bảng dưới đây cho thời gian từng giai đoạn cho toàn bộ batch 16 request.
| Sơ đồ | Tổ chức trạng thái | Trước khi token đầu tiên trả về (prefill toàn batch) | Thực thi sau khi token đầu tiên trả về |
|---|---|---|---|
| A | BF16, context độc lập | 7.34 s | 255 vòng, 29.63 ms mỗi vòng |
| B | BF16, tiền tố dùng chung | 2.04 s | 255 vòng, 27.35 ms mỗi vòng |
| C | q8_0, context độc lập | 7.34 s | 255 vòng, khoảng 28.26 ms mỗi vòng |
| D | BF16, tiền tố dùng chung với phỏng đoán | 2.23 s | 85 vòng, 3 token đầu ra mỗi vòng, 27.35 ms mỗi vòng |
A và C không chia sẻ tiền tố, nên mỗi request phải xử lý trọn vẹn 8192 token; phép tính ma trận của toàn bộ batch là 2137.5 TFLOP, tại cùng hiệu suất tính toán 58% mất khoảng 7.34 giây. A đọc 34.46 GB mỗi vòng, giống như 64 request tại context 2K, cho 29.63 ms từ bảng; KV của C được nén , đọc 25.40 GB mỗi vòng, nội suy giữa các cột 19.97 GB và 34.46 GB trong bảng thành khoảng 28.26 ms — chưa tính thời gian chuyển đổi định dạng. Prefill của D nhiều hơn B 9.4%, khoảng 2.23 giây. Trong D, mỗi vòng xác minh 8 vị trí cho mỗi một trong 16 request, cần khoảng 2.56 TFLOP phép tính ma trận, tại hiệu suất 58% mất khoảng 8.8 ms — ngắn hơn 27.35 ms mỗi vòng của B; theo Mục 8.2.1, lấy giá trị lớn hơn trong hai giá trị, mỗi vòng vẫn là 27.35 ms. Lượt lan truyền tới của mạng bản nháp cũng hoàn thành trong cùng vòng; trong Thí nghiệm 8-5, độ trễ trung vị mỗi vòng của DFlash không dài hơn một bước decode thông thường (Mục 8.5.2), nên không có thêm thời gian nào được cộng vào đây.
Trước tiên kiểm tra bộ nhớ có đủ không. A cần MiB, vượt 12 GiB, và không thể tiếp nhận tập các request này đồng thời. B chỉ cần một bản sao tiền tố cộng 16 trạng thái riêng, tổng cộng 6048 MiB, khoảng 5.91 GiB. Trạng thái của C, nén , tổng cộng khoảng 9.86 GiB. D thêm 3188 MiB lên trên B, tổng cộng 9236 MiB, khoảng 9.02 GiB. B, C và D đều vừa trong bộ nhớ, nên so sánh thời gian mỗi sơ đồ cần để hoàn thành các request.
Tổng thời gian của B là giây, nhất quán với độ trễ request trung vị 9.02 giây đo được trong Thí nghiệm 8-1, nhưng vượt hạn chót 7 giây. Trên card này, chỉ 255 vòng decode đã mất 6.97 giây; sinh 256 token đầu ra từng cái một cho cả 16 request cùng nhau không thể kịp giờ. C mất việc tái sử dụng tiền tố, với prefill tăng từ 2.04 giây lên 7.34 giây, cho tổng thời gian giây. D xuất ra 3 token mỗi vòng, sinh 255 token còn lại trong 85 vòng, cho tổng thời gian
Với A bị loại do thiếu bộ nhớ và B, C bị loại do quá thời gian, chỉ D trả về cả 16 câu trả lời đúng đúng hạn. Phép so sánh này dùng, theo thứ tự, dung lượng sau chia sẻ tiền tố, kích thước dưới định dạng nén, thời gian mỗi vòng và số đầu ra mỗi vòng. Trên card này, thời gian một vòng decode hầu như không đổi theo batch size hay độ dài context; chỉ giảm số vòng mới có thể rút ngắn đáng kể giai đoạn sinh.
Hình 8-35 vẽ hai phép kiểm tra này trên cùng một mặt phẳng. Vượt qua đường đứt nét theo chiều ngang nghĩa là KV và các buffer phụ trợ vượt 12 GiB; vượt qua nó theo chiều dọc nghĩa là thời gian hoàn thành vượt 7 giây. Chỉ D nằm trong cả hai giới hạn.
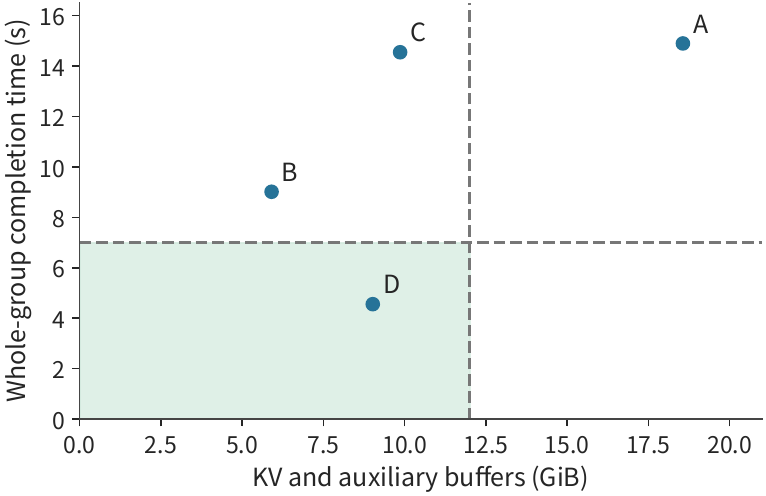
Cuối cùng, so sánh chi phí. Thời gian card này chi cho mỗi kết quả đạt chuẩn bằng tổng thời gian từ lúc đến đến khi hoàn thành đầy đủ của batch, chia cho số kết quả đạt chuẩn. Với D, con số này là GPU-giây; tại giới hạn công suất 600 W, năng lượng cho mỗi kết quả đạt chuẩn không quá khoảng 171 J. B chiếm card này 9.01 giây, nhưng dưới hạn chót 7 giây tạo ra không kết quả đạt chuẩn nào — toàn bộ thời gian và năng lượng đó là lãng phí.
Lựa chọn thay đổi thế nào nếu bộ nhớ thu nhỏ hoặc đầu ra ngắn lại? Nếu bộ nhớ khả dụng cho KV và các buffer phụ trợ giảm từ 12 GiB xuống 6 GiB, yêu cầu khoảng 9.02 GiB của D không còn vừa; yêu cầu khoảng 5.91 GiB của B vừa nhưng sẽ quá hạn. Tập request này khi đó không có sơ đồ khả thi nào, chỉ còn lại các lựa chọn như nới hạn chót, rút ngắn đầu ra, hoặc chuyển sang một nguồn bản nháp không tiêu thụ bộ nhớ GPU (xem Bài tập 8-9). Nếu bộ nhớ giữ nguyên nhưng đầu ra được rút ngắn xuống 16 token, B cần giây, và D cần giây. Cả hai đều hoàn thành đúng hạn, và D chỉ nhanh hơn 0.08 giây: 0.19 giây prefill thêm mà model bản nháp thực hiện gần như triệt tiêu thời gian tiết kiệm được bằng cách chạy ít hơn 10 vòng decode.
Phân tích trên chỉ bao trùm thời gian thực thi trong instance. Tính thời lượng của một tác vụ agent hoàn chỉnh cũng đòi hỏi thêm thời gian thực thi công cụ và chờ đợi bên ngoài. Giả sử một tác vụ mất tổng cộng 100 giây, trong đó decode chiếm 50 giây; tăng tốc decode gấp bốn lần thay đổi tổng thời gian thành giây, gia tốc tổng thể 1.6 lần. Nếu decode ban đầu chỉ chiếm 20 giây, tổng thời gian thay vào đó trở thành giây, gia tốc tổng thể chỉ khoảng 1.18 lần. Tổng quát, gọi là tỉ phần của tổng thời gian ban đầu bị decode chiếm giữ, và giai đoạn đó được tăng tốc lên lần, với thời gian của các giai đoạn khác không đổi; định luật Amdahl khi đó cho
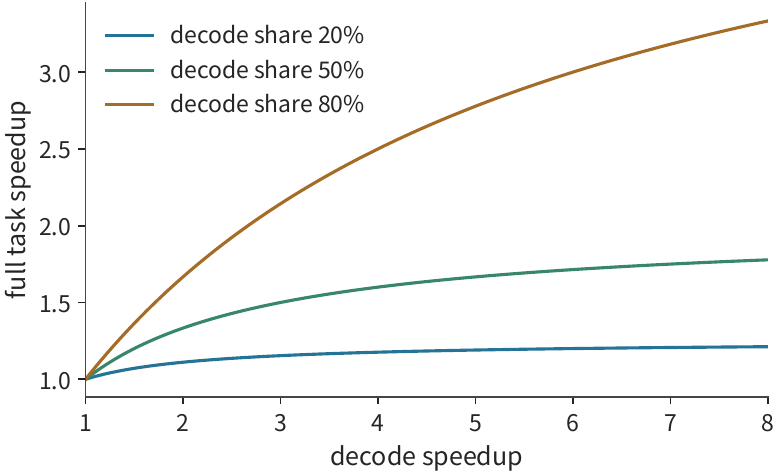
Trong Hình 8-36, tỉ phần decode càng thấp, đường cong xẹp xuống càng sớm: ngay cả khi giai đoạn sinh tiếp tục tăng tốc, các lời gọi công cụ và thời gian chờ khác vẫn chiếm giữ tỉ phần thời gian của chúng. Việc so sánh mức chiếm dụng accelerator và tiêu thụ năng lượng cũng phải bao trùm các giai đoạn này, và nên được tính dựa trên số cuối cùng của các request đạt chuẩn. Gọi là tổng thời gian accelerator bị chiếm dụng trong cửa sổ quan sát, là tổng năng lượng tiêu thụ, và là số kết quả đạt chuẩn; khi đó mỗi kết quả đạt chuẩn trung bình chiếm thời gian GPU và tiêu thụ năng lượng. Thí nghiệm 8-9 đọc các bộ đếm năng lượng của cả GPU lẫn gói CPU (toàn bộ gói xử lý) trên cùng một card: dưới continuous batching tại các tốc độ đến 1, 4 và 16 req/s, mỗi kết quả đạt chuẩn tiêu thụ lần lượt 615.0, 652.0 và 1083.7 J; tiếp nhận từng cái một tại 4 req/s tiêu thụ 1982.3 J. Tại 16/s, thông lượng hoàn thành của continuous batching gần với giá trị tại 4/s, nhưng nhiều phản hồi hơn đến muộn, và năng lượng mỗi kết quả đạt chuẩn cao hơn khoảng 66%. Ngay cả khi một câu trả lời sai hoặc trả về quá muộn, năng lượng đã tiêu thụ vẫn phải được tính vào tổng chi phí.
Bài tập 8-8 · Tính toán: gia tốc giai đoạn và chuẩn bị bản nháp thay đổi tổng thời gian tác vụ như thế nào. Một tác vụ 100 giây gồm 20 giây prefill, 50 giây decode và 30 giây sử dụng công cụ và chờ đợi. Giảm một nửa thời gian của từng phần trong ba phần, và tìm tổng thời gian tác vụ cho mỗi trường hợp. Riêng biệt, bắt đầu từ tác vụ gốc, giảm thời gian decode xuống một phần tư giá trị ban đầu và thêm 8 giây thời gian chuẩn bị bản nháp; tìm gia tốc ròng, và tính tại thời gian chuẩn bị nào sự thay đổi này không còn tiết kiệm thời gian.
Bài tập 8-9 · Cốt lõi · Thiết kế toàn diện: giảm thời gian GPU chiếm giữ mỗi kết quả đạt chuẩn trong các ràng buộc dung lượng và hạn chót. Dùng dung lượng và thời gian của ví dụ toàn diện trên RTX PRO 6000, xây Sơ đồ E trên nền B: chia sẻ tiền tố BF16, và chuyển bản nháp sang tra cứu từ context (Mục 8.5.2), với chỉ mục được giữ trong bộ nhớ host, không tiêu thụ bộ nhớ GPU và không thêm prefill; mỗi request xuất ra trung bình 2 token mỗi vòng, tiếp theo là 128 vòng sau đó, với toàn bộ batch mất 27.35 ms mỗi vòng cộng 0.1 ms tra cứu. Tính footprint bộ nhớ, tổng thời gian và số GPU-giây chiếm giữ mỗi kết quả đạt chuẩn của E, và so sánh với B và D; sau đó riêng biệt thay đổi bộ nhớ khả dụng cho KV và các buffer phụ trợ xuống 6 GiB, và thay đổi độ dài đầu ra xuống 16 token, rồi lựa chọn lại. Trong phần thí nghiệm mở, chạy cả hai cấu hình trên cùng một tập bài toán và cùng một dấu vết (trace) đến, ghi lại thời điểm đến, đầu ra đầu tiên, hoàn thành, độ đúng và trạng thái đỉnh của tất cả các request, và tính thông lượng hiệu dụng bằng các công thức của mục này.
Lịch sử và đọc thêm
Việc tiếp nhận request mới theo từng vòng lặp, paged attention (attention phân trang) và cache theo cây tiền tố (prefix-tree caching) lần lượt thúc đẩy lập lịch request, cấp phát trạng thái và tái sử dụng phép tính. Các thiết kế liên quan của Orca, PagedAttention và SGLang có thể được đọc theo các hướng này; Sarathi-Serve và NanoFlow tiếp tục nghiên cứu chunking (chia khối), pipelining (đường ống) và sự chồng lấp giữa các tài nguyên khác nhau.
Việc phục vụ đa adapter trong Mục 8.2.1 có thể được tiếp nối qua Punica và S-LoRA, các hệ thống lần lượt quản lý adapter và trạng thái request, thực thi phép tính hạng thấp của từng adapter đồng thời chia sẻ một model nền chung.
Attention lai (hybrid attention) và các model hồi quy (recurrent) mở rộng việc lập chỉ mục cache thành một bài toán khôi phục trạng thái; Marconi và các công trình liên quan thảo luận về cơ hội khôi phục và giá trị của cache. Offload trọng số, mã hóa tensor và thực thi bộ nhớ hợp nhất (unified memory) liên hệ dung lượng accelerator với chi phí liên kết; các bản ghi M2 Max đi kèm cho thấy mức cấp phát KV thực tế và quá trình xử lý đầu vào của các model nhỏ.
Các quy tắc chấp nhận và hiệu chỉnh của speculative sampling (lấy mẫu phỏng đoán) đặt nền tảng cho việc bảo toàn phân bố mục tiêu; các phương pháp sau đó nháp từ tra cứu context, dự đoán bản nháp từ các đặc trưng trung gian và sinh bản nháp song song chủ yếu thay đổi chi phí mỗi vòng và độ dài bản nháp được chấp nhận. Các tác vụ agent hoàn chỉnh cũng bao gồm các giai đoạn công cụ và giai đoạn bên ngoài; các bản ghi tốc độ và tác vụ đã công bố có thể được đọc cùng với phân rã giai đoạn ở Mục 8.6.
Chú thích nguồn
-
Phép tính batching và so sánh 8K của model cố định trên RTX PRO 6000. Trọng số BF16 đầy đủ là 16,381,470,720 byte, và một bước đọc trọng số ma trận được chia sẻ lý tưởng là 15,136,811,008 byte; embedding được tra cứu theo từng hàng cho mỗi request, nhưng toàn bộ ma trận embedding vẫn phải được giữ trong bộ nhớ. Bảng lượng đọc trước tiên được tính với số byte chính xác, sau đó mỗi mục được làm tròn.
-
Thông số kỹ thuật NVIDIA RTX Blackwell PRO, Phụ lục A, Bảng 4, được gom vào hàng rtx-pro6000-blackwell-ws của bảng thông số phần cứng.
-
Bản ghi thô của phép quét batch. RTX PRO 6000, vLLM 0.23.0, BF16, ba lần chạy; phần chính của văn bản báo cáo trung vị, thông lượng bao trùm phần prefill và giai đoạn sinh còn lại và loại trừ thời gian tải và khởi động; điều kiện 8K thiết lập một tiền tố dùng chung trước tiên.
-
Bài báo gốc về Orca và ghi chú về phép tính chia khối và quản lý phiên bản.
-
Batch size cố định, continuous batching, chiến lược chia khối. Các tham số độ trễ mỗi vòng được khớp từ bản ghi từng vòng của Thí nghiệm 8-1: với batch 1, một vòng decode 2K mất 26.26 ms, prefill mất 94.8 ms; token đầu ra cuối cùng chưa được ghi vào cache KV khi request kết thúc.
-
Phép đo phép tính chia khối và lưu trữ. 11 request, mỗi request 16 khối; thời gian trung vị của khối đầu và khối cuối lần lượt là 25.30 và 35.07 ms; khoảng CUDA event bao trùm toàn bộ đường dẫn model và các khoảng trống phía host có thể có, loại trừ logits/lấy mẫu bên ngoài. Mỗi khối thực thi theo đúng thứ tự ban đầu, với token đầu vào và nội dung thay đổi từng khối.
-
Khảo sát OSDI 2025, bài báo cuối của NanoFlow và nghiên cứu tình huống chia sẻ và đặt tài nguyên.
-
Phép đo sáu request và đánh đổi thực thi graph. Thí nghiệm thực thi sáu request văn bản tổng hợp theo một thứ tự cố định trên một GPU dùng chung.
-
Phân trang, hủy bỏ và ưu tiên, chia sẻ bốn nhánh, so sánh nhánh nguội. Các nhánh dùng chung tạo ra đầu ra giống hệt nhau; nhánh nguội và nhánh nóng có cùng số khối đỉnh nhưng khối lượng prefill khác nhau.
-
Khôi phục trạng thái lai và phép tính checkpoint, khảo sát MLSys 2025. Dung lượng của Kimi K3 được tính dựa trên định dạng lưu trữ và cấu hình song song đã chỉ định.
-
Phát lại cache 12 vòng đầu vào thực. Việc phát lại dùng chuỗi đầu vào của tác vụ gốc, thực thi các request tuần tự, sinh một token mỗi vòng.
-
Các file model cố định và ngân sách dịch vụ và siêu dữ liệu shard 235B. Số byte, GB và GiB chính xác được báo cáo riêng.
-
Định dạng KV và chi phí thực thi. Tài liệu bao gồm định dạng nhóm GGML, độ hạt của scale FP8 và các kết quả khớp trên H100.
-
Offload trọng số và phép tính prefetch; lập lịch sao chép và prefetch cho hai tầng liên kết PCIe Gen5 và NVLink-C2C, với thời gian phép tính mỗi lớp được lấy là thời gian vòng decode batch 1 là 26.26 ms chia cho 36 lớp; ghi chú kiến trúc GH200: NVLink-C2C tổng cộng 900 GB/s, 450 GB/s mỗi hướng.
-
Nén và truyền tensor. Tài liệu bao gồm việc triển khai video engine LLM.265, thiết kế phần cứng chuyên dụng và ước lượng hiệu năng.
-
Bản ghi dung lượng model nhỏ trên M2 Max và kiểm tra bổ sung 32K. Mỗi slot thực thi prefill tuần tự.
-
So sánh độ chính xác KV và Q, điều khiển Q với trọng số FP8 cố định, bản ghi dung lượng đồng thời. Phần chính của văn bản dùng nhóm trọng số BF16. Trong một nhóm khác với trọng số FP8 cố định, Q BF16 và đường dẫn mặc định lần lượt là 32/32 và 28/32.
-
Đầu ra tự nhiên và chi phí thử lại. Thí nghiệm dùng việc xác minh câu trả lời với các câu trả lời đã biết; chi phí thử lại bao gồm chi phí sinh câu trả lời sai đầu tiên.
-
Bài báo gốc về speculative sampling, bài báo gốc về giải mã phỏng đoán, ghi chú đếm framework và ngân sách, độ bao phủ framework trong khảo sát. Thuật toán xác suất cơ bản, các tuyến bản nháp và các triển khai cụ thể được trích dẫn riêng.
-
Phép tính phân bố và chi phí cho bản nháp từ context và kết quả vét cạn số hữu tỉ. Ví dụ dùng một phân bố mục tiêu hai ký hiệu; thời gian mỗi vòng trên RTX PRO 6000 được cho trong AAAA, BBBB và request 256 token với chỉ mục 2 giây; vòng decode thông thường 26.26 ms được lấy từ bản ghi từng vòng của Thí nghiệm 8-1, và thời gian mỗi vòng của DFlash được lấy từ các bản ghi từng bước của Thí nghiệm 8-5.
-
So sánh DFlash cùng executor và quan sát giai đoạn theo từng request. Thí nghiệm thực thi một tập bài toán ngắn đã cho theo thứ tự cố định dưới mức đồng thời thấp. Tại concurrency 1, thời gian trung vị để thông qua tập bài toán ngắn của decode thông thường, K7 và K15 lần lượt là 90.02, 30.58 và 29.43 ms; các đầu ra ghép cặp tổng cộng 32 cặp.
-
Bản ghi thô của dịch vụ và năng lượng. Cùng một thiết bị, tám bài toán, bảy điều kiện, mỗi điều kiện ba cửa sổ 16 request; cùng một bài toán cho đầu ra nhất quán giữa các điều kiện, và 42 lỗi đến từ cùng một bài toán. Bảng thông lượng dùng trung vị của các số liệu trong mỗi cửa sổ. Mỗi cửa sổ chứa 16 request; p95 được tính tại vị trí làm tròn lên của dãy đã sắp xếp, cho giá trị lớn nhất. Các cửa sổ đếm thành phần NVML và RAPL rộng hơn một chút so với các cửa sổ request, trong khi các dịch vụ khác vẫn đang chạy.
-
Bảng hiệu suất của Thí nghiệm 8-1 được script tính toán xuất ra từ bản ghi từng vòng của phép quét batch; các giá trị đỉnh được lấy từ bảng phần cứng với các giá trị RTX PRO 6000 là 1792 GB/s và 503.8 TFLOP/s; footprint bộ nhớ đỉnh, thời gian đến token đầu tiên và thời gian mỗi vòng của DFlash được lấy từ Thí nghiệm 8-5. Bộ nhớ và thời gian của mỗi sơ đồ được script kiểm tra ví dụ tính lại.
-
Thí nghiệm sinh và bản ghi chạy agent. Các bản ghi agent dùng cách gọi không phát trực tuyến (non-streaming); hình thời gian giai đoạn dùng các tham số cho trong đề bài.
-
Bố cục theo tensor Q2_K, dung lượng file 8K và so sánh 32K. Tổng kích thước file là 85,691,002,112 byte, phần tải mã-giá trị/dấu chấm động là 69,178,275,840 byte, siêu dữ liệu lượng tử hóa là 16,506,720,256 byte, và phần header cùng padding là 6,006,016 byte. Các kích thước file trên được tính từ các header đã lưu trữ và siêu dữ liệu đã công bố.
-
Thông số kỹ thuật RTX PRO 6000 Blackwell Workstation Edition: giao diện hệ thống PCIe 5.0 x16, với băng thông gấp đôi PCIe Gen4; thông số kỹ thuật A100 80GB: PCIe 4.0 là 64 GB/s (gửi và nhận gộp lại), tức x16 cho 32 GB/s mỗi hướng. Do đó PCIe Gen5 x16 cho 64 GB/s mỗi hướng. Phần chính của văn bản tính bằng các giá trị danh nghĩa, cho cận dưới của thời gian truyền. Thời gian tính lại tiền tố được tính từ bảng hiệu suất của Thí nghiệm 8-1.
-
Các quan sát về hủy bỏ đến từ thí nghiệm trạng thái. Các giá trị ghi nhận xấp xỉ 1.55 ms và 31.41 ms, với phép đo thời gian bao gồm chi phí quan sát.
-
Tính lại từng mục và quy trình tính toán cho các so sánh điều kiện của chương này.
-
Báo cáo kỹ thuật chính thức DeepSeek V4.1, các Mục 1, 2, 3 và 6; các điều kiện cố định và phép tính lại xuyên suốt các phiên của chương.
Tóm tắt chương
Chương này bắt đầu từ quá trình thực thi của một request đơn lẻ và phân tích dần dần mối quan hệ giữa dung lượng bộ nhớ, cách bố trí phép tính và kết quả dịch vụ. Các request khác nhau chia sẻ trọng số, trong khi KV tăng theo context của riêng từng request. Batching giảm lượng đọc trọng số được phân bổ cho mỗi token đầu ra, nhưng mỗi request vẫn phải đọc context của chính nó. Lợi ích này phụ thuộc vào hiệu năng của các tài nguyên bên dưới: một khi trọng số thay vào đó được phục vụ từ bộ lưu trữ nhanh hơn, độc lập hơn, batching không còn phân bổ việc đọc trọng số, và các batch size cùng các sơ đồ giải mã phỏng đoán khác nhau phải được so sánh lại từ đầu. Continuous batching tận dụng ngay các slot thực thi được giải phóng bởi các request ngắn, trong khi chunked prefill giảm sự can thiệp của các đầu vào dài lên quá trình sinh của các request hiện có.
Cách KV được quản lý quyết định một instance có thể xử lý bao nhiêu request đồng thời. Phân trang cấp phát không gian theo nhu cầu, chia sẻ chỉ giữ một bản sao của tiền tố chung, và cache tiền tố tiếp tục loại bỏ phép tính dư thừa. Việc nối thêm, viết lại và tóm tắt context thay đổi mức tái sử dụng cache cũng như chi phí lưu trữ và đọc trạng thái sau đó; khi so sánh các cách tổ chức context này với các tối ưu hóa phục vụ khác, cần áp dụng cùng các yêu cầu chất lượng tác vụ. Nén tiếp tục giảm dung lượng lưu trữ; offload chuyển một phần trọng số ra khỏi accelerator, với cái giá là việc di chuyển lặp lại. Giải mã phỏng đoán thêm chi phí sinh và xác minh bản nháp, nhưng cho phép một phép tính model mục tiêu duy nhất quyết định nhiều token đầu ra. Tất cả các thay đổi này có thể được so sánh qua footprint bộ nhớ, độ trễ mỗi vòng và số đầu ra mỗi vòng.
Ví dụ toàn diện ở cuối chương trước tiên kiểm tra bộ nhớ có đủ hay không, sau đó xác định hạn chót có thể được đáp ứng hay không, và cuối cùng so sánh thời gian GPU chiếm giữ cho mỗi kết quả đạt chuẩn. Với chia sẻ tiền tố, 16 request dài trước đây không thể vừa giờ có thể thực thi đồng thời; nhưng trên RTX PRO 6000, sinh từng token một cho 256 token đầu ra vẫn sẽ lỡ hạn chót, và chính giải mã phỏng đoán, bằng cách giảm số vòng decode, giúp chúng hoàn thành đúng hạn. Khi bộ nhớ khả dụng giảm, tập request này không tìm được sơ đồ khả thi nào; khi đầu ra được rút ngắn, lợi thế của giải mã phỏng đoán gần như biến mất. Lý do đằng sau mỗi sự thay đổi lựa chọn đều có thể truy về các khối lượng dữ liệu, thời gian thực thi và số đầu ra đã được suy ra trong chương này.
Sau khi hoàn thành các so sánh cấu hình trong chương này, ba loại kết quả nên được ghi lại: trạng thái của bao nhiêu request có thể được giữ đồng thời dưới một accelerator, độ chính xác và độ dài request nhất định; prefill và decode mỗi quá trình xử lý công việc nhanh đến mức nào; và độ trễ request thay đổi thế nào theo batch size và tốc độ đến. Các kết quả này đã bao gồm ảnh hưởng của việc lập lịch, cache và hiệu quả kernel.
Chương tiếp theo xây dựng trên các kết quả này để quyết định mỗi loại accelerator đảm nhận công việc gì, cần bao nhiêu đơn vị thực thi, và KV được truyền và chia sẻ như thế nào. Nhiều accelerator có thể cùng thực thi một instance duy nhất, hoặc tạo thành nhiều bản sao hoàn chỉnh, hoặc các nhóm giai đoạn được lập lịch riêng. Các quyết định batching xác định tài nguyên hiện có xử lý request như thế nào, trong khi các quyết định triển khai xác định các tài nguyên này phân chia công việc ra sao; cùng nhau chúng định hình hiệu năng của dịch vụ hoàn chỉnh.