Chương 1 · Cái nhìn đầu tiên về AI Infra
Theo dõi một lần thực thi model để hiểu hệ thống — dùng dung lượng, tính toán, băng thông và độ trễ để ước lượng một request đơn: dữ liệu có đủ chỗ không, phải chờ bao lâu, thêm accelerator hay đổi biểu diễn dữ liệu được lợi gì.
~54 phút đọc
Cái nhìn đầu tiên về AI Infra
Lời nói đầu đã giới thiệu nguồn gốc của cuốn sách này, cách tổ chức các chương và cách đọc nó. Bắt đầu từ chương này, chúng ta đi theo quá trình thực thi của một model để hiểu các hệ thống hỗ trợ nó. AI Infrastructure là hạ tầng hỗ trợ quá trình training và inference của AI, bao gồm thiết bị tính toán, lưu trữ và interconnect, cùng phần mềm sắp xếp các tài nguyên này. Training dùng mẫu để điều chỉnh tham số model; inference dùng tham số đã được training để xử lý đầu vào và sinh ra đầu ra.
Chương này trước tiên giải thích cách các ứng dụng biểu diễn tác vụ chung qua code, model và context, sau đó đi theo việc xử lý một request đơn lẻ để hiểu hệ thống, dùng dung lượng, thông lượng tính toán và băng thông để trả lời những câu hỏi thiết kế cụ thể: dữ liệu có vừa không, phản hồi phải chờ bao lâu, và việc thêm accelerator hay đổi biểu diễn dữ liệu mang lại lợi ích bao nhiêu. Cuối cùng, nó điểm lại cách vài kiến trúc thực tế hình thành, cho thấy yêu cầu đã dẫn dắt thiết kế hệ thống như thế nào.
1.1 Vì sao AI Infrastructure lại quan trọng
1.1.1 Sự dịch chuyển của tầng trừu tượng lập trình: từ hệ điều hành đến model context
Hãy lấy một dịch vụ hỏi đáp tài liệu làm ví dụ. Nhà phát triển trước tiên định nghĩa luồng chương trình để đọc tài liệu, truy xuất nội dung và hiển thị kết quả, sau đó đưa câu hỏi của người dùng cùng tài liệu đã truy xuất cho một language model để sinh câu trả lời. Context là nội dung đầu vào có sẵn cho lần gọi model này, bao gồm chỉ dẫn tác vụ, tài liệu tham khảo và kết quả của các tương tác trước đó. Giữ tham số model cố định, việc thay đổi chỉ dẫn, ví dụ hay tài liệu tham khảo có thể thay đổi tác vụ model xử lý và cách nó phản hồi.
Nếu dịch vụ này được yêu cầu review code, thì code, yêu cầu kiểm thử và các công cụ gọi được đều có thể được cung cấp cùng lúc cho model, và model sẽ đề xuất thay đổi hoặc khởi động lời gọi công cụ; ứng dụng chạy bài kiểm thử, thêm kết quả vào context cho lần gọi tiếp theo, và model tiếp tục phán đoán. Một công cụ (tool) là một hàm chương trình mà ứng dụng có thể gọi, chẳng hạn đọc một file hay chạy một bài kiểm thử. Model quyết định việc làm tiếp theo; chương trình host kiểm tra quyền, thực thi thao tác và lưu kết quả. Hoàn thành một tác vụ có thể cần nhiều lần gọi model và nhiều lần thực thi công cụ.
Abstraction (trừu tượng hóa) bọc việc triển khai phức tạp đằng sau một interface được định nghĩa tốt, cho phép nhà phát triển tổ chức chương trình với ít khái niệm hơn. Programmability (tính lập trình được) là khả năng của nhà phát triển làm thay đổi hành vi của hệ thống thông qua một interface nào đó. Các ứng dụng truyền thống biểu diễn hành vi chủ yếu qua mã chương trình: trình biên dịch chuyển code thành lệnh thực thi được, và hệ điều hành quản lý các tài nguyên chương trình cần để chạy. Các ứng dụng dẫn dắt bởi model thêm một điểm vào quan trọng khác: biểu diễn tác vụ bằng cách chọn model, tổ chức context và cung cấp công cụ. Hành vi mà trước đây phải viết từng quy tắc một thì nay được model quyết định dựa trên context; code tiếp tục tổ chức luồng gọi, và các chương trình công cụ tiếp tục truy cập file, mạng và thiết bị thông qua hệ điều hành.
Hình 1-1 đối chiếu hai cách tổ chức hành vi này. Ở phía phải, agent tổ chức context, gọi model và thực thi các công cụ model chọn. Ở đây, model interface quy định cách ứng dụng nộp đầu vào và nhận đầu ra. Hệ thống runtime đằng sau interface tính đầu ra của model và giữ lại trạng thái context mà các bước tiếp theo sẽ tái sử dụng; accelerator là một bộ xử lý phù hợp để thực thi khối lượng lớn phép tính model song song; bộ nhớ giữ tham số và trạng thái runtime; còn interconnect di chuyển dữ liệu giữa các thiết bị. Khi nhà phát triển thay đổi tác vụ từ các tầng trên, các tầng dưới phải chuyển những thay đổi đó thành tính toán và truy cập dữ liệu cụ thể.
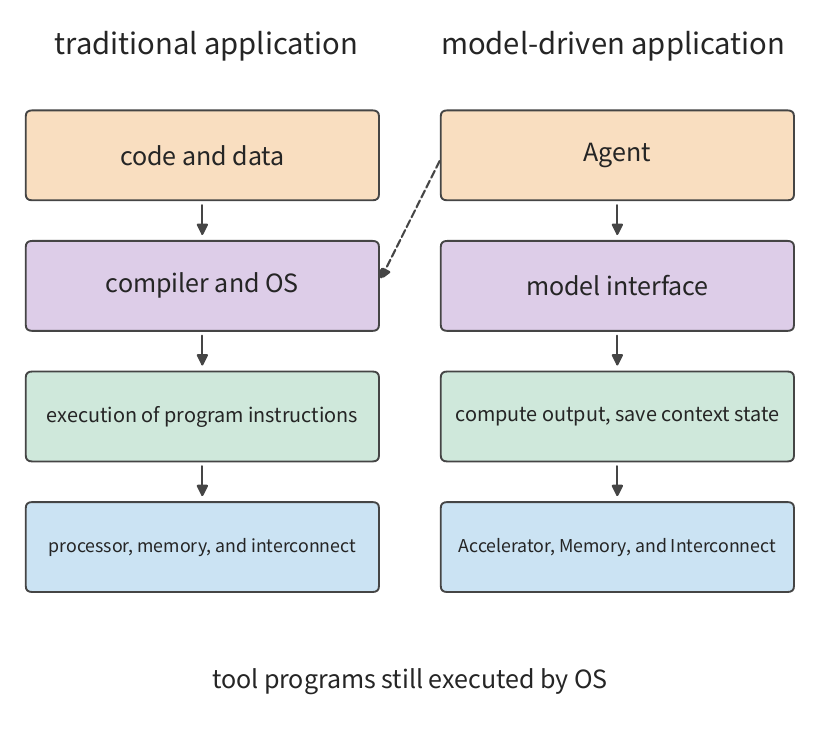
Sự dịch chuyển về tính lập trình được này cũng thay đổi cách các dịch vụ model vận hành. Trong một hệ thống AI, khi cùng một model xử lý request từ các ứng dụng khác nhau, nó dùng cùng một tập tham số. Hệ thống có thể gộp nhiều request thành một phép tính duy nhất, chia sẻ một lần đọc tham số, để nâng cao mức sử dụng accelerator. Cách tiếp cận này gọi là batching, và số request được thực thi cùng nhau trong một batch là batch size. Đồng thời, tài liệu dài, câu trả lời dài và các lời gọi công cụ nhiều vòng làm thay đổi khối lượng tính toán, dấu chân trạng thái và thời gian chờ. Cùng một model trên cùng tập accelerator có thể cho hiệu năng khác biệt rất lớn khi xử lý các tác vụ khác nhau.
Đằng sau sự khác biệt hiệu năng này là mối ảnh hưởng qua lại giữa model và phần cứng. Về phía thiết kế model: nén trạng thái được lưu, đổi cơ chế attention, hay chỉ dùng một phần tham số model đều có thể thay đổi công việc phần cứng phải thực hiện; về phía phần cứng: dung lượng lưu trữ, tốc độ truyền dữ liệu và khả năng kết nối giữa các thiết bị lại ảnh hưởng đến cấu trúc model và cách thực thi nào phù hợp hơn. Hiểu mối quan hệ hai chiều này là cần thiết để bàn chung chất lượng phản hồi, độ trễ và chi phí, và giải thích vì sao một phương án phù hợp với ứng dụng này lại có thể cần đánh giá lại khi áp dụng cho ứng dụng khác.
Trong các hệ thống được xây chủ yếu cho việc training và inference model, các tầng có thể được đồng thiết kế quanh cùng một quá trình thực thi hoàn chỉnh. Cấu trúc model định nghĩa tính toán và phụ thuộc dữ liệu, runtime biết khi nào trạng thái được sinh ra và được dùng, còn phần cứng thực hiện việc tính toán và truyền tải tương ứng. Dùng thông tin này để tổ chức lại việc thực thi có thể loại bỏ một phần chi phí tồn tại trong các triển khai đa dụng. Cùng một model cũng có thể xử lý nhiều tác vụ khác nhau tùy context, hỗ trợ hành vi ứng dụng đa dạng trong khi vẫn cho phép các tầng dưới được tối ưu hóa đặc thù cho việc thực thi model. Sự dịch chuyển tính lập trình được ở tầng trên mở ra những cơ hội mới cho việc tối ưu hóa chung xuyên tầng. Cuốn sách này dùng phân tích định lượng để nghiên cứu những cơ hội tối ưu đó, giải thích các đánh đổi thiết kế hiện tại đang thay đổi thế nào và các triển khai mới cải thiện hiệu năng training và inference ra sao.
1.1.2 Sáu tầng phân công lao động, từ tác vụ đến phần cứng
Một request đi qua nhiều tầng của hệ thống theo thứ tự, từ khi nộp đến khi hoàn thành. Một người dùng nộp một đoạn code, nhờ model tìm lỗi. Ứng dụng chuyển code và câu hỏi cho dịch vụ model, dịch vụ chọn một accelerator để thực thi request, accelerator đọc trọng số và đầu vào, hoàn thành phép tính, rồi chuyển câu trả lời đã sinh về cho ứng dụng. Nếu nhiều accelerator cùng thực thi request, các kết quả trung gian cũng phải được trao đổi giữa chúng. Đi theo con đường này giúp chúng ta xác định dần nơi xảy ra chờ đợi và dữ liệu nào phải được di chuyển.
Tiến sĩ Heng Liao, Giám đốc Khoa học của Huawei Semiconductors, đã đề xuất “tháp mười tám tầng” để mô tả nhiều tầng từ ứng dụng, model và hệ thống phần mềm xuống tới chip, quy trình sản xuất và vật lý nền. Ông nhận xét rằng hầu hết mọi người chỉ hiểu một hoặc vài tầng trong số đó, và vì vậy bỏ lỡ nhiều cơ hội tối ưu hóa chung xuyên tầng. Hình 1-2 vận dụng cách tiếp cận này, chia nội dung cuốn sách thành sáu tầng:
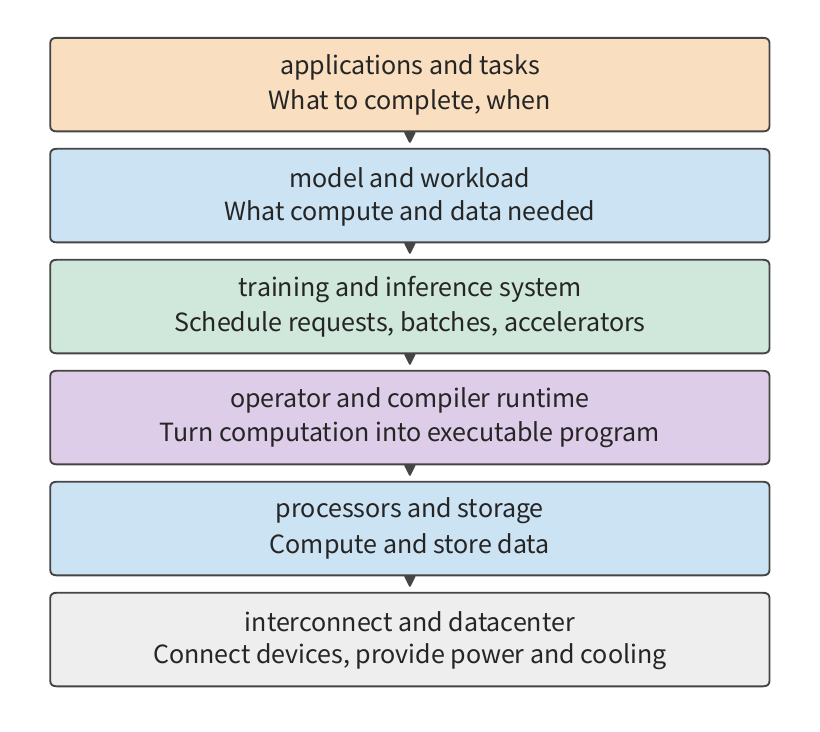
Trên cùng là ứng dụng và tác vụ. Hội thoại, sinh code, tương tác bằng giọng nói, và các agent có thể gọi công cụ để đẩy tiến tác vụ, tất cả nêu ra những yêu cầu cụ thể ở tầng này: tác vụ nào phải hoàn thành, kết quả phải trả về nhanh đến đâu, và trần chi phí là bao nhiêu. Training cũng có mục tiêu tác vụ riêng, chẳng hạn hoàn thành một lần cập nhật model hay một vòng pretraining trong thời gian cho trước.
Tầng tiếp theo là model và workload. Cấu trúc model định nghĩa phép tính nào phải thực hiện và dữ liệu nào phải giữ lại; workload thực tế quyết định khi nào công việc này đến và kéo dài bao lâu. Một câu hỏi ngắn và một tài liệu dài, dù cùng được đưa cho một model, tạo ra những yêu cầu tính toán và lưu trữ khác nhau. Cấu trúc model được phát triển ở Chương 2, còn workload training và inference được phát triển ở Chương 3.
Hệ thống training và inference tổ chức những yêu cầu này thành công việc thực thi được. Tầng này nhận request hoặc job, tổ chức batch, quản lý trạng thái runtime và quyết định cách dùng một hoặc nhiều accelerator. Trong inference, nó phải phối hợp các request đang được sinh với các request mới đến; trong training, nó còn phải tổ chức cập nhật tham số, truyền thông và phục hồi. Chương 8–10 bàn về tầng này.
Bên dưới là operator và compiler runtime. Các thao tác trong model như nhân ma trận và normalization (điều chỉnh thang số của các giá trị dựa trên thống kê) phải được dịch thành các chương trình bộ xử lý thực thi được. Cuốn sách này gọi các thao tác cơ bản như nhân ma trận là operator; một operator library cung cấp các cài đặt của những thao tác này, một compiler dịch chương trình sang dạng accelerator thực thi được, còn runtime nộp chương trình và quản lý tài nguyên trong lúc thực thi. Ba thành phần này cùng quyết định cách tiling phép tính, cách dùng bộ nhớ tạm và khi nào nộp công việc. Cùng một biểu thức toán học có thể có các kiểu truy cập dữ liệu và cách thực thi khác nhau, và Chương 5 phân tích những khác biệt đó một cách cụ thể. Ở đây cũng nằm một sợi chỉ để hiểu về song song phân tán: một ma trận có thể được chia để thực thi trong một card, và một model cũng có thể được chia trên nhiều card theo mẫu, chuỗi, đặc trưng, tầng hay expert (một mạng con được chọn theo từng đầu vào trong model mixture-of-experts). Cả hai trường hợp đều cần trước tiên xác định ai tính phần nào, rồi sắp xếp để đầu vào đến và kết quả được gộp. Khác biệt nằm ở chỗ ranh giới giữa các phần có vượt qua bộ nhớ on-chip, GPU memory hay mạng hay không. Chương 6 đi theo sợi chỉ này để giải thích các chiến lược song song, thay vì coi chúng như những mẹo rời rạc.
Bộ xử lý và lưu trữ thực thi phép tính và lưu dữ liệu. CPU là bộ xử lý trung tâm chạy các chương trình đa dụng; GPU là bộ xử lý đồ họa giỏi thực thi song song nhiều thao tác tương tự nhau, và nay được dùng rộng rãi cho tính toán model; NPU là bộ xử lý được thiết kế cho các phép toán mạng nơ-ron. Bộ nhớ chính giữ dữ liệu CPU dùng, GPU memory giữ dữ liệu GPU dùng, còn bộ nhớ on-chip nằm bên trong chip bộ xử lý, cho phép các đơn vị tính toán đọc dữ liệu tại chỗ. Đơn vị tính toán trước tiên đọc đầu vào, rồi thực thi phép toán, và cuối cùng ghi lại kết quả. Chương 4 giải thích thiết kế accelerator bắt đầu từ mối quan hệ giữa năng lực tính toán và tốc độ truy cập dữ liệu.
Ở đáy là interconnect và trung tâm dữ liệu. Các thiết bị trao đổi dữ liệu qua interconnect, các máy chủ và nhóm hợp tác lớn hơn kết nối qua mạng, còn việc cấp điện và làm mát quyết định cách tài nguyên có thể được triển khai. Chương 6 và 7 bàn về supernode và mạng trung tâm dữ liệu, còn Chương 12 mở rộng vị trí thực thi sang edge, on-device và cloud.
Sáu tầng mô tả sự phân công lao động chính, nhưng một số năng lực trải rộng nhiều tầng. Lập lịch tài nguyên, môi trường thực thi, khả năng quan sát và tính phí phải được tổ chức dùng thông tin từ nhiều tầng; công nghệ quy trình, đóng gói, cấp điện và làm mát quyết định cách thiết bị được chế tạo và triển khai. Mạng cũng không chỉ hoạt động ở đáy: các model, operator và dịch vụ yêu cầu hợp tác xuyên thiết bị đều phải đi qua một interconnect cụ thể nào đó.
Nhìn xuống qua sáu tầng này, một tác vụ dần trở thành tính toán và truy cập dữ liệu cụ thể; nhìn lên, dung lượng lưu trữ, thông lượng tính toán và băng thông có sẵn của accelerator quyết định hệ thống có thể chạy model lớn đến đâu, xử lý đồng thời bao nhiêu request và phản hồi nhanh đến mức nào. Các interface giữa những tầng này cũng là điểm vào cho việc tối ưu hóa chung. Khi một model thay đổi cách biểu diễn trạng thái, nhu cầu lưu trữ và truyền thông thay đổi; khi compiler fusion các operator liền kề, vị trí lưu kết quả trung gian thay đổi; khi runtime để các accelerator bàn giao trực tiếp, số lần host tham gia thay đổi.
1.1.3 Quá trình xử lý một request sinh (generation)
Một inference instance là một tập tài nguyên thực thi có khả năng độc lập hoàn thành một request model, và nó có thể gồm một hoặc nhiều accelerator. Mỗi request được xử lý bởi một instance như vậy. Hình 1-3 cho thấy sự phân công giữa việc gán request và việc thực thi bên trong instance: service router là phần mềm chọn nơi request sẽ thực thi; một khi router đã chọn instance, bản thân instance sẽ sắp xếp cho các accelerator thực thi model. Chỉ khi làm rõ ai chịu trách nhiệm thực thi trước, chúng ta mới xác định được một tập trọng số nên cư trú ở đâu và một kết quả trung gian nên được chuyển cho ai.
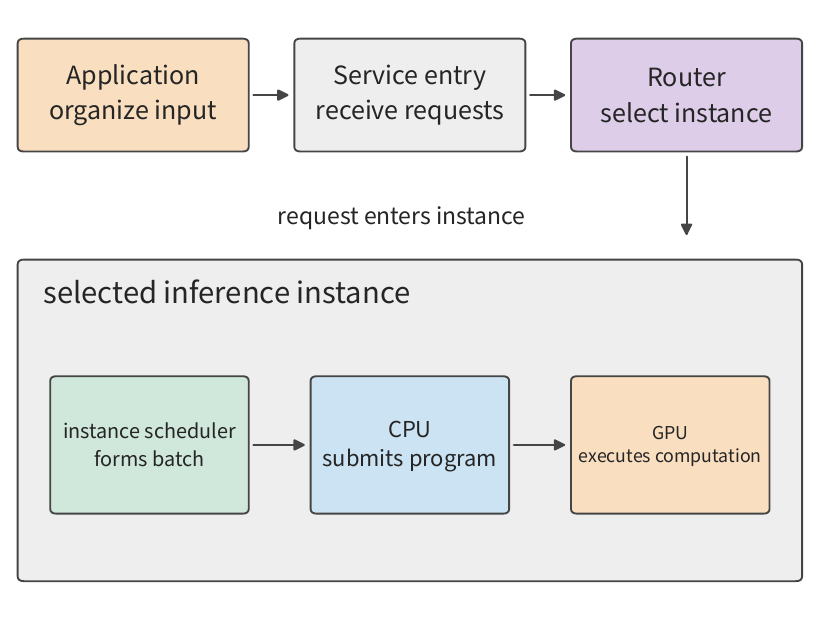
Context bao gồm đầu vào người dùng, cuộc hội thoại hiện có, kết quả truy xuất và nội dung đã sinh trước đó. Ứng dụng tổ chức thông tin này thành một request và nộp cho điểm vào của dịch vụ model. Sau khi điểm vào kiểm tra quyền truy cập, hạn mức (quota) và nội dung request, router chọn một instance dựa trên model mục tiêu, tải của instance và các điều kiện khác; một instance có thể chạy trên một card hoặc trải rộng nhiều card. Một khi instance được chọn, bản thân instance sẽ phối hợp các card này.
Văn bản sau đó được chuyển thành một chuỗi token. Một token là đơn vị cơ bản model dùng để xử lý văn bản, có thể tương ứng với một ký tự, một phần của từ hay một mảnh khác; số token của một đoạn văn bản được quyết định bởi kết quả tokenization. Việc chuyển đổi văn bản có thể được thực hiện bởi chính instance hoặc bởi một front end dùng chung. Scheduler của instance đặt request vào hàng đợi, đóng gói nó vào một batch và cấp không gian cho trạng thái của nó. Runtime trên CPU sau đó nộp các tác vụ tính toán cho GPU, và GPU thực thi các operator tương ứng.
Model trước tiên xử lý đầu vào; giai đoạn này gọi là prefill. Sau đó nó sinh các token mới từng bước; giai đoạn này gọi là decode. Các bước sau tái sử dụng trạng thái đã lưu trước đó, bao gồm KV cache, nơi lưu các vector key và value do các token context tạo ra để dùng trong phép tính attention của các vị trí về sau. Key và value là các biểu diễn dữ liệu dùng trong cơ chế attention; Chương 2 giải thích chúng được tạo ra thế nào, cùng các thao tác cụ thể liên quan. Vòng lặp sinh được scheduler bên trong instance điều khiển liên tục, với đầu ra của bước trước trở thành đầu vào của bước sau. Các token đã sinh được chuyển thành văn bản bởi quá trình xử lý đầu ra và được stream về qua kết nối; nếu đầu ra yêu cầu một lời gọi công cụ, ứng dụng chạy công cụ, thêm kết quả vào context và phát hành lời gọi tiếp theo.
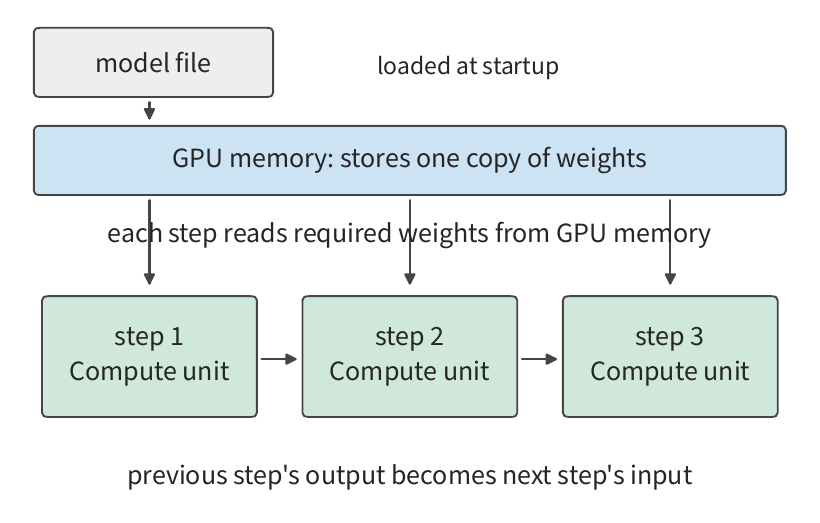
Trong số dữ liệu được tái sử dụng lặp đi lặp lại giữa các bước tính toán này, trọng số model đứng đầu. Trọng số model là các tham số số học, thu được qua training, biến đầu vào thành đầu ra. Trọng số được nạp từ lưu trữ khi một instance khởi động hoặc khi model được chuyển đổi, và sau đó vẫn cư trú trong GPU memory (gọi là residency), phục vụ nhiều request. Trong lúc sinh, các đơn vị tính toán của GPU đọc trọng số của tầng hiện tại và trạng thái context từ GPU memory, thực hiện phép tính, và chuyển kết quả cho tầng tiếp theo. Cùng một dữ liệu do đó trải qua hai kiểu di chuyển ở các tần suất khác nhau: loading đưa model lên accelerator, còn execution lặp đi lặp lại đưa dữ liệu cần thiết đến các đơn vị tính toán. Trong một instance nhiều card, kết quả trung gian tính trên một card cũng phải được chuyển cho các card khác trước khi phép tính tiếp theo có thể tiếp tục. Một intermediate tensor là một mảng số nhiều chiều do một phép toán tạo ra và chuyển cho phép toán sau; một matrix là một tensor hai chiều. Một request bên ngoài có thể chỉ gồm một đoạn văn bản ngắn, nhưng dữ liệu được di chuyển bên trong còn bao gồm cả trọng số, trạng thái và tensor trung gian lớn hơn nhiều.
Hình 1-5 cho thấy phần cứng tương ứng với các chức năng phần mềm này. Một trung tâm dữ liệu bao gồm điểm vào và các dịch vụ CPU, bộ lưu trữ dùng chung, và một nhóm tài nguyên accelerator gồm nhiều supernode. Một supernode là một nhóm accelerator được ghép chặt qua interconnect băng thông cao, có thể trải rộng nhiều máy chủ hoặc compute tray (các đơn vị cắm được trong rack chứa CPU và accelerator).
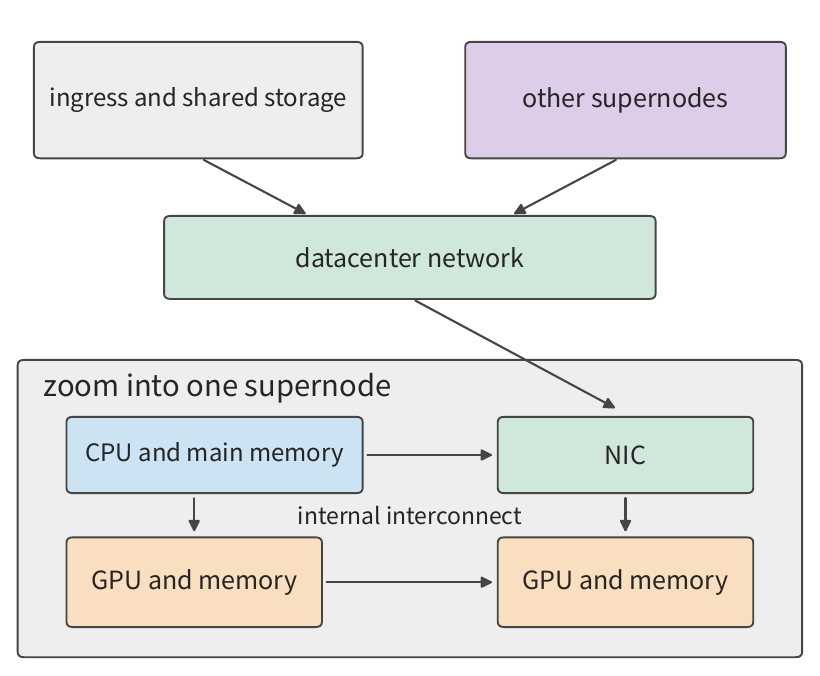
Trong một máy chủ hay compute tray, CPU kết nối với bộ nhớ chính và chịu trách nhiệm cho các chương trình host và điều khiển thực thi; mỗi GPU kết nối với GPU memory của riêng nó, thực thi tính toán model và giữ dữ liệu cần khi chạy. HBM (high-bandwidth memory) là một loại GPU memory thường dùng trong accelerator, cung cấp dữ liệu liên tục qua một interface rộng. CPU và GPU có thể được kết nối qua PCIe (một interconnect ngoại vi tốc độ cao), và các GPU cũng có thể trao đổi dữ liệu trực tiếp qua một interconnect tốc độ cao chuyên dụng. NIC kết nối máy cục bộ với mạng. Trong các hệ thống hỗ trợ truy cập bộ nhớ trực tiếp, dữ liệu có thể được phần cứng truyền ghi thẳng vào một vùng bộ nhớ đã chỉ định, với CPU chịu trách nhiệm khởi tạo và quản lý việc truyền; Chương 7 giải thích việc bàn giao này chi tiết hơn.
Interconnect bên trong một supernode thường được gọi là scale-up, tập trung vào việc cho một nhóm accelerator cùng tính toán với chi phí truyền thông thấp; nhiều supernode sau đó được kết nối qua NIC và mạng chuyển mạch, gọi là scale-out, dùng để mở rộng phạm vi cụm. Cả hai đều phải tính đến băng thông, độ trễ, tắc nghẽn và sự cố, nhưng chúng khác nhau về phạm vi hợp tác và chi phí. Lấy NVIDIA GB200 NVL72 làm ví dụ: thiết kế chính thức tổ chức 36 CPU Grace và 72 GPU Blackwell trong một rack, với 72 GPU hợp tác trực tiếp qua interconnect GPU tốc độ cao NVLink của NVIDIA, tạo thành một miền interconnect duy nhất, trong khi mạng cụm xử lý kết nối bên ngoài. Sự tổ chức này mở rộng phạm vi hợp tác chặt từ một máy đơn lên một rack, cho phép model phân bổ trọng số và trạng thái trên nhiều accelerator hơn, với các bàn giao thường xuyên được xử lý bởi interconnect nội rack.
Mạng AI và mạng trung tâm dữ liệu truyền thống do đó phân chia trách nhiệm tương ứng. Điểm vào dịch vụ mang request, bộ lưu trữ dùng chung cung cấp file model, còn interconnect accelerator mang các kết quả trung gian trong lúc tính toán. Ba loại lưu lượng này khác nhau về tần suất, khối lượng dữ liệu và cấu trúc phụ thuộc: file model có thể được nạp trước, nhưng kết quả một phần của tầng hiện tại phải đến kịp trước khi tầng tiếp theo có thể tiến hành. Kết nối vật lý do đó ảnh hưởng trực tiếp đến thời gian thực thi của model.
Bài tập 1-1 [Mở rộng]: Đọc trọng số, tăng trưởng trạng thái và truyền dữ liệu trong một request
Theo Hình 1-3 đến 1-5, thêm sự tăng trưởng của trạng thái KV khi đầu ra tăng, rồi đánh dấu riêng việc nạp file model, đọc trọng số từng bước, append KV và truyền kết quả xuyên card. Nếu câu trả lời tăng từ 100 token lên 1000 token, dữ liệu nào chỉ được nạp một lần, và truy cập nào tăng lên? Nếu một instance được nhân thành hai instance, dung lượng trọng số và việc định tuyến request thay đổi ra sao?
Một lần thực thi model được định hình bởi cả năng lực của một card lẫn cách các accelerator được kết nối. Thông lượng tính toán và băng thông lưu trữ của một card quyết định thời gian cho các phép tính và đọc/ghi cục bộ, trong khi hợp tác nhiều card thêm vào việc trao đổi dữ liệu và chờ đợi. Chương này trước tiên ước lượng việc thực thi trên một card; các chương sau áp dụng cùng phương pháp cho supernode và mạng.
Hãy giới thiệu một tập model thực tế sẽ xuyên suốt cả cuốn sách. DeepSeek V4 và V4.1 Flash cung cấp một sợi chỉ để chúng ta theo dõi liên tục. V4 đã thay đổi yêu cầu lưu trữ và đọc thông qua nén context và truy cập thưa, còn V4.1 Flash phân lại trách nhiệm bên trong model. Một model decoder-only truyền thống thường cho các token đầu vào đi qua toàn bộ backbone, xây dựng dần trạng thái cần cho việc sinh theo từng tầng; V4.1 Flash áp dụng kiến trúc Causal Encoder-Decoder (CED), trong đó encoder tạo thành một biểu diễn ngữ cảnh và decoder rút thông tin toàn cục từ các biểu diễn này. Do đó, số lượng lớn token đầu vào không cần đi qua phép tính của thân decoder; khi sinh một token mới, model vẫn đi qua encoder và decoder theo thứ tự. Đường thực thi của đầu vào và đầu ra bất đối xứng, cho phép model tái phân bổ khoản đầu tư tính toán cho các workload như tác vụ agent, nơi đầu vào lớn và đầu ra tương đối nhỏ.
Đây là một lựa chọn ở cấp kiến trúc, và nó cũng thay đổi những gì hệ thống phải lưu và truyền. Cuốn sách này sẽ phát triển thảo luận quanh cùng một kiểu phiên: một agent chờ một công cụ trả về, khôi phục context trước đó, xử lý đầu vào mới và tiếp tục sinh. Chương 2 giải thích cấu trúc và trạng thái của CED, Chương 3 phân rã workload đầu vào và sinh, Chương 4–7 truy vết thực thi accelerator và đường dữ liệu, Chương 8 và 9 bàn cách cache trạng thái và phân bổ request, còn các chương cuối so sánh kết quả thực thi cho các tác vụ hoàn chỉnh. Model nguồn mở Qwen3 cung cấp các ví dụ tính toán cơ bản để thiết lập phương pháp; V4/V4.1 được dùng để xem xét model và hệ thống thay đổi cùng nhau như thế nào.
1.2 Các chỉ số quan trọng cho thiết kế hệ thống
1.2.1 Đánh giá một phương án theo bậc độ lớn
Trước khi ước lượng việc thực thi trên một card, chúng ta cần biết đại khái các thao tác cơ bản khác nhau mất bao lâu. Trong một bài nói năm 2009, Jeff Dean trình bày một bảng được trích dẫn rộng rãi có tên “Numbers Everyone Should Know” (Những con số ai cũng nên biết). Bảng gồm thời gian truy cập cache và bộ nhớ cũng như thời gian cho các thao tác đĩa và mạng. Bảng này thể hiện một cách làm việc thực tế: trước khi viết một chương trình hay xây một hệ thống, trước tiên hãy ước lượng các thao tác chính sẽ cần bao nhiêu thời gian và bao nhiêu tài nguyên.
Dưới đây là danh sách đầy đủ 12 thao tác và giá trị từ slide gốc. Tất cả thời gian tính bằng ns (nanosecond, một phần tỷ giây); 1 μs (microsecond) bằng 1000 ns, và 1 ms (millisecond) bằng 1000 μs. Về đơn vị dữ liệu, 1 byte bằng 8 bit; bit/s biểu thị số bit truyền mỗi giây, và G trong Gbit/s biểu thị một tỷ. Các đơn vị dung lượng KB, MB, GB và TB lần lượt biểu thị , , và byte; KiB, MiB và GiB lần lượt biểu thị , và byte. Những con số này tương ứng với môi trường phần cứng năm 2009 và được dùng ở đây để hiểu mối quan hệ bậc độ lớn giữa các thao tác khác nhau.
Cache giữ dữ liệu có khả năng sớm được tái sử dụng; L1 cache thường nhỏ hơn và gần lõi tính toán hơn L2 cache. Dự đoán nhánh là phán đoán của bộ xử lý về đường lệnh nào sẽ thực thi tiếp theo; khi dự đoán sai, việc thực thi phải được làm lại. Một thread là một đơn vị lệnh được lập lịch và thực thi độc lập trong một chương trình; mutex giới hạn nhiều thread truy cập đồng thời vào cùng dữ liệu dùng chung. Một disk seek là quá trình một đĩa cơ học di chuyển đầu đọc để định vị track mục tiêu. Zippy là thư viện nén Google dùng thời đó. Các thao tác này lần lượt liên quan đến tính toán, đồng bộ, lưu trữ và mạng, và thời lượng của chúng có thể chênh nhau nhiều bậc độ lớn.
| Thao tác | Thời gian (ns) |
|---|---|
| Truy cập L1 cache | 0,5 |
| Dự đoán nhánh sai | 5 |
| Truy cập L2 cache | 7 |
| Khóa/mở khóa mutex | 25 |
| Truy cập bộ nhớ chính | 100 |
| Nén 1K byte bằng Zippy | 3.000 |
| Gửi 2K byte qua mạng 1 Gbit/s | 20.000 |
| Đọc 1 MB tuần tự từ bộ nhớ | 250.000 |
| Khứ hồi trong cùng trung tâm dữ liệu | 500.000 |
| Disk seek | 10.000.000 |
| Đọc 1 MB tuần tự từ đĩa | 20.000.000 |
| Gói tin khứ hồi từ California đến Hà Lan | 150.000.000 |
Lấy ba trong số những con số lịch sử này: một lần truy cập bộ nhớ chính khoảng 100 ns, một lần khứ hồi trong cùng trung tâm dữ liệu khoảng 500.000 ns, và một disk seek khoảng 10.000.000 ns. Đổi đơn vị, chúng là 0,1 μs, 0,5 ms và 10 ms, như trong Hình 1-6.
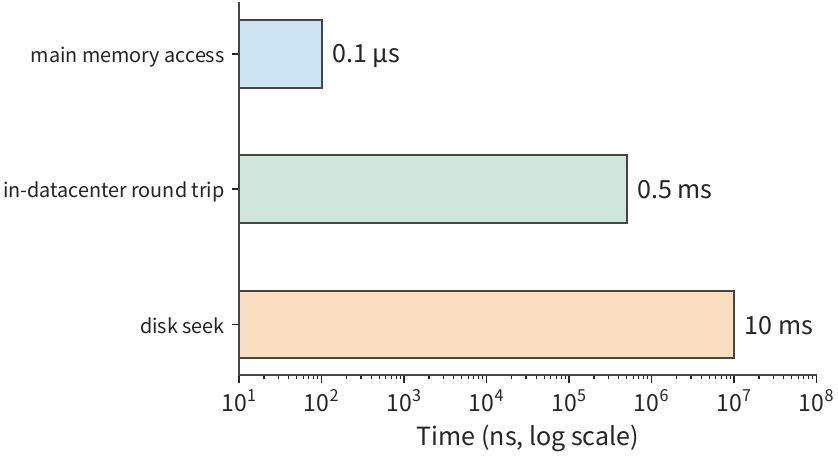
Theo những con số này, một disk seek mất gấp khoảng một trăm nghìn lần một lần truy cập bộ nhớ chính. Nếu một request phải chờ nhiều lần truy cập như vậy theo chuỗi, các độ trễ này cộng dồn, kéo dài thời gian hoàn thành của request. Nếu một request phải định vị một mẩu dữ liệu trước khi xác định được vị trí của truy cập tiếp theo, bộ xử lý phải chờ suốt quá trình truy cập lưu trú ngay cả khi nó thực hiện rất ít tính toán giữa hai lần truy cập.
Ví dụ, giả sử một request thực hiện 20 disk seek theo chuỗi, mỗi lần 10 ms, với tổng tính toán CPU là 1 ms; tổng thời gian là 201 ms. Tăng gấp đôi tốc độ tính toán chỉ tiết kiệm được 0,5 ms; bố trí dữ liệu liên quan liên tục, giảm số lần seek từ 20 xuống 10, tiết kiệm được 100 ms. Hai tối ưu hóa này tác động lần lượt lên tính toán và chờ đợi, và sự khác biệt về lợi ích đến từ việc mỗi phần chiếm bao nhiêu trong thời gian thực thi ban đầu.
Một khi thời gian được phân rã theo cách này, chúng ta có thể tính hướng tối ưu hóa: phần nào chiếm tỷ trọng thời gian tổng càng lớn, thì việc rút ngắn phần đó mang lại cải thiện cho toàn thể càng nhiều. Trong ví dụ seek ở trên, tính toán chỉ chiếm tổng thời gian; dù loại bỏ hoàn toàn phần này, tổng thời gian cũng chỉ giảm khoảng .
Tổng quát hóa mối quan hệ này ta được công thức speedup tổng thể. Nếu một phần của thời gian thực thi ban đầu có thể được tăng tốc lên một hệ số , trong khi phần còn lại của công việc và thứ tự thực thi không đổi, thì speedup tổng thể là:
Đây là định luật Amdahl. Dù phần này được tăng tốc đến mức thời gian của nó trở nên không đáng kể, speedup tổng thể cũng không thể vượt quá . Khi số lần seek giảm, bị rút ngắn chính là phần chờ đợi — phần chiếm tỷ trọng lớn nhất — nên tối ưu hóa này tác động đến tổng thời gian nhiều hơn hẳn việc tăng tốc CPU.
Ví dụ: cùng dùng một công cụ coding AI, vì sao các đội khác nhau lại thấy speedup tổng thể khác nhau? Giả sử hoàn thành một tác vụ phát triển đòi hỏi lần lượt đi qua các giai đoạn giao tiếp, coding, review và phê duyệt, và một công cụ coding AI tăng tốc coding lên gấp 5 lần tốc độ ban đầu, trong khi thời gian các giai đoạn khác không đổi. Trong một đội công ty lớn với nhiều tầng phối hợp, coding có thể chỉ chiếm 20%–30% tổng thời gian ban đầu, phần còn lại dành cho họp, giao tiếp xuyên đội và phê duyệt. Thay vào công thức, speedup tổng thể chỉ khoảng 1,19–1,32 lần. Ví dụ, nếu tác vụ ban đầu mất 100 giờ, với 20 giờ dành cho coding; một khi coding rút xuống còn 4 giờ, các giai đoạn khác vẫn mất 80 giờ, tổng cộng 84 giờ.
Trong một đội khởi nghiệp với chi phí giao tiếp thấp hơn, giả sử coding chiếm 70%–80% tổng thời gian ban đầu; cùng một mức tăng tốc coding cho speedup tổng thể khoảng 2,27–2,78 lần. Lấy coding ở 80% làm ví dụ, 100 giờ ban đầu trở thành giờ.
Định luật Amdahl áp dụng cho bất kỳ quy trình hoàn chỉnh nào trong đó chỉ một phần được tăng tốc. CPU, model inference và phát triển phần mềm đều có thể được phân tích với cùng câu hỏi: phần được tăng tốc chiếm bao nhiêu phần thời gian ban đầu, và phần thời gian còn lại đi đâu? Để tiếp tục rút ngắn thời gian bàn giao, người ta phải tiếp tục cải thiện giao tiếp, review và phê duyệt. Thắng lợi về tốc độ cục bộ cuối cùng phải được đo trong bối cảnh tác vụ hoàn chỉnh.
Phương pháp thể hiện trong bảng này có thể áp dụng trực tiếp cho việc thực thi model: trước tiên xác định mỗi phần công việc dùng tài nguyên nào, rồi so sánh thời gian yêu cầu.
1.2.2 Các chỉ số quan trọng để phân tích một hệ thống AI
Giả sử một tác vụ cần đồng thời giữ byte, thực hiện phép toán dấu phẩy động, và đọc/ghi byte qua một interface lưu trữ nào đó. Accelerator cung cấp dung lượng , thông lượng tính toán và băng thông interface . Ba loại yêu cầu này phải được đối chiếu từng cái với tài nguyên accelerator cung cấp:
Dung lượng quyết định dữ liệu cần thiết có thể được giữ cùng lúc hay không; hai số hạng sau chuyển workload thành thời gian. Một mẩu dữ liệu có thể được lưu một lần và đọc nhiều lần, nên và phải được tính riêng. Nếu và được lấy ở giá trị đỉnh, kết quả là cận dưới của thời gian cần để hoàn thành phép tính và di chuyển dữ liệu đã cho.
Giá trị đỉnh được quyết định bởi số đơn vị tính toán trên chip, tần số hoạt động và interface lưu trữ, nên cận dưới này là giới hạn vật lý của phần cứng — dù phần mềm được tổ chức thế nào, nó cũng không thể nhanh hơn. Tỷ lệ giữa cận dưới này và thời gian thực tế trôi qua phản ánh bao nhiêu năng lực phần cứng thực sự được dùng. Tỷ lệ ở phía tính toán, , gọi là MFU (model FLOPs utilization), còn tỷ lệ ở phía băng thông, , gọi là MBU (memory bandwidth utilization); cả hai đều không vượt quá 1. Cuốn sách này dùng lặp đi lặp lại hai tỷ lệ này, và chúng luôn trả lời cùng một câu hỏi: thiết kế cách giới hạn vật lý của phần cứng bao xa?
Ngoài dung lượng, thông lượng tính toán và băng thông, chúng ta cũng cần hiểu độ trễ thao tác. Dưới đây giải thích cách mỗi loại trong bốn loại chỉ số này đi vào một phép ước lượng.
Dung lượng trả lời có thể giữ bao nhiêu dữ liệu cùng lúc. Ví dụ, một card accelerator có bao nhiêu GPU memory quyết định nó có thể giữ trọng số model, trạng thái context và workspace tạm thời của runtime hay không. Dung lượng đo bằng byte.
Thông lượng tính toán trả lời có thể hoàn thành bao nhiêu thao tác mỗi đơn vị thời gian. FLOP thường chỉ một phép toán dấu phẩy động, FLOPs chỉ tổng số phép toán, còn FLOP/s chỉ số phép toán dấu phẩy động mỗi giây. GFLOPs và TFLOPs lần lượt chỉ một tỷ và một nghìn tỷ phép toán dấu phẩy động, còn GFLOP/s và TFLOP/s chỉ tốc độ tương ứng mỗi giây. Trong tính toán ma trận, một phép nhân cộng một phép cộng thường được tính là hai phép toán. Thông lượng ma trận đỉnh tương ứng với một độ chính xác đầu vào, độ chính xác tích lũy và điều kiện thưa (sparsity) cụ thể. Tính toán đặc (dense) tác động lên toàn bộ ma trận; tính toán thưa (sparse) khai thác các phần tử zero hoặc một cấu trúc thưa đã định để bỏ qua một phần công việc.
Băng thông trả lời có thể truyền bao nhiêu dữ liệu mỗi đơn vị thời gian. Băng thông GPU memory mô tả năng lực di chuyển dữ liệu giữa bộ nhớ và chip, còn băng thông liên kết giữa các card và băng thông mạng mô tả năng lực dọc theo các đường khác. Khi ước lượng một đoạn truyền cụ thể, hãy dùng băng thông của interface thuộc đoạn đó.
Độ trễ trả lời sau khi khởi tạo một thao tác bạn phải chờ bao lâu. Ngay cả một interface băng thông cao cũng có thể có thời gian khởi động hay khứ hồi không thể bỏ qua. Khi truyền một khối dữ liệu lớn, thời gian chủ yếu do tỷ lệ lượng dữ liệu trên băng thông quyết định; khi request nhỏ và phải được chờ từng cái một, thời gian khởi động và khứ hồi có thể chiếm ưu thế.
Lấy một accelerator thực tế làm ví dụ. H100 là một thế hệ GPU của NVIDIA, và SXM chỉ dạng module dùng trong ví dụ này. BF16 là một định dạng dấu phẩy động trong đó mỗi số chiếm 16 bit (2 byte), còn FP32 là định dạng dấu phẩy động trong đó mỗi số chiếm 32 bit (4 byte); phép nhân ma trận có thể đọc đầu vào BF16 trong khi lưu kết quả tích lũy ở FP32. H100 SXM có dung lượng bộ nhớ 80 GB, băng thông HBM 3,35 TB/s, và thông lượng ma trận đặc đỉnh khoảng 989,4 TFLOP/s với đầu vào BF16 và tích lũy FP32.
Đặt H100 cạnh A100 80GB SXM của NVIDIA và GeForce RTX 4090 ta được một bảng tham chiếu nhanh về tài nguyên GPU. Ba cái lần lượt dùng kiến trúc Hopper, Ampere và Ada. Dung lượng trong bảng dùng GB danh nghĩa của nhà sản xuất, băng thông dùng TB/s thập phân, và thông lượng tính toán ma trận đồng nhất dùng giá trị đỉnh với đầu vào BF16, tích lũy FP32, tính toán đặc. Hàng cuối nhận được bằng cách chia 1 GB cho băng thông bộ nhớ.
| Tài nguyên hoặc thao tác | RTX 4090 | A100 80GB SXM | H100 SXM |
|---|---|---|---|
| Dung lượng bộ nhớ (GB) | 24 | 80 | 80 |
| Băng thông bộ nhớ (TB/s) | 1.008 | 2.039 | 3.35 |
| Ma trận BF16 đỉnh (TFLOP/s) | 165.2 | 312 | 989.4 |
| Thời gian đọc 1 GB ở băng thông đỉnh (ms) | 0.99 | 0.49 | 0.30 |
Bảng này cung cấp dữ liệu hiệu năng phần cứng cần thiết để chuyển một workload thành thời gian. Ví dụ, nếu lượng đọc/ghi không đổi trong khi băng thông tăng gấp đôi, giảm một nửa; nếu tải tính toán không đổi trong khi thông lượng tính toán tăng gấp đôi, giảm một nửa.
1.2.3 Chuyển đổi giữa lưu trữ tham số và băng thông liên kết
Bốn loại chỉ số này phải được gán lên một workload cụ thể trước khi dùng để ước lượng. Bước đầu tiên là chuyển các tham số của model thành số byte lưu trữ, để xác định accelerator có giữ nổi nó hay không; bước thứ hai là chia số byte đó cho băng thông, để ước lượng việc di chuyển dữ liệu đó mất bao lâu.
Lấy model thực tế DeepSeek-R1-Distill-Llama-70B làm ví dụ. Model này dựa trên kiến trúc Llama và là một model đặc (mọi token đều dùng tất cả tham số trong phép tính); trọng số công bố của nó chứa khoảng 70,554 tỷ tham số. Chữ B trong tên biểu thị tỷ (billion), và 70B là con số xấp xỉ cho số tham số; biến trong các công thức về sau biểu thị số request trong một batch. Gọi là số tham số và là số byte lưu trữ cho mỗi trọng số. BF16 dùng 2 byte mỗi trọng số, nên tổng số byte trong các file trọng số công bố là
Phần này nhất quán dùng GB thập phân, tức byte; còn đơn vị nhị phân GiB là byte. Vậy 141,11 GB khoảng 131,42 GiB. Chỉ sau khi chuyển cả dung lượng lưu trữ có sẵn của accelerator lẫn kích thước trọng số về cùng một đơn vị, chúng mới có thể được trừ cho nhau.
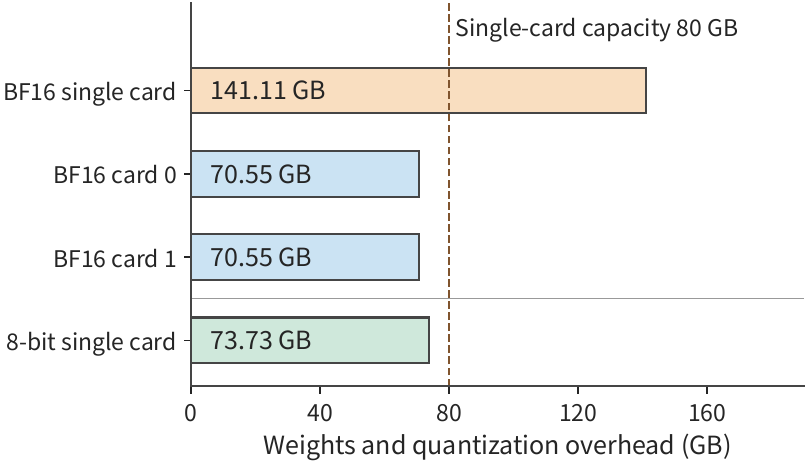
141,11 GB trọng số vượt quá bộ nhớ danh nghĩa 80 GB của một H100 SXM. Chia đều trọng số cho hai card ta được khoảng 70,55 GB mỗi card, mỗi card còn trống khoảng 9,45 GB. Sharding nghĩa là cho các accelerator khác nhau mỗi cái giữ và tính toán trên một phần của model. Các kết quả trung gian phải được trao đổi giữa hai card; Chương 6 bàn các phương pháp sharding và truyền thông cụ thể.
Độ chính xác lưu trữ của trọng số cũng có thể được thay đổi. Quantization biểu diễn giá trị với ít bit hơn — ví dụ, xấp xỉ các trọng số dấu phẩy động 16-bit ban đầu bằng số nguyên 8-bit, và dùng một scale (hệ số tỉ lệ) để chuyển các số nguyên trở lại thành giá trị xấp xỉ trong phạm vi tương ứng. Mỗi trọng số lượng tử hóa từ 2 byte xuống 1 byte, nên dấu chân bộ nhớ giảm đáng kể.
Sơ đồ quantization theo nhóm dùng trong cuốn sách này chia sẻ một scale cho mỗi 128 trọng số, đồng thời giữ một số tham số ở BF16. Tính theo cấu hình của model thực tế, toàn bộ trọng số của sơ đồ 8-bit cộng chi phí quantization chiếm khoảng 73,73 GB, vừa với một H100 SXM, còn trống khoảng 6,27 GB. Hình 1-7 đặt cả hai cách tiếp cận trên cùng một thang dung lượng: BF16 chia cho hai card, hoặc lượng tử hóa vừa một card.
KV cache làm tăng yêu cầu bộ nhớ của một request đơn như thế nào. Khi sinh văn bản, GPU memory cũng phải giữ KV cache để tái sử dụng trực tiếp trong phép tính sau; việc thực thi operator cũng cần một workspace tạm. Vì vậy phép kiểm tra dung lượng nên được viết thành
Ở đây là trọng số cộng chi phí quantization, là trạng thái context của request, là workspace, và là dung lượng lưu trữ có sẵn của accelerator. Lấy một request 8192 token của model này làm ví dụ: KV cache BF16 là 2,5 GiB, khoảng 2,68 GB; dành thêm 2 GiB, khoảng 2,15 GB, cho workspace, sơ đồ 8-bit tổng khoảng GB, vừa trong ngân sách dung lượng này. Chương 2 sẽ suy ra kích thước KV cache từ số tầng và cấu trúc attention của model, và tính yêu cầu bộ nhớ cho context dài hơn và nhiều request đồng thời hơn.
Chuyển sang RTX 4090 với bộ nhớ danh nghĩa 24 GB, cùng 73,73 GB trọng số vượt quá tổng 72 GB của ba card. Dưới cùng ngân sách dung lượng danh nghĩa, chỉ riêng việc giữ trọng số đã cần ít nhất bốn card; KV và workspace cũng phải được kiểm tra cho từng card. Với cùng model và độ chính xác nhưng dung lượng mỗi card khác nhau, số accelerator cần thiết thay đổi.
Truyền mạng cũng cần cùng kiểu chuyển đổi đơn vị. Băng thông mạng thường đo bằng bit/s, và 8 bit tạo thành 1 byte, nên một NIC 400 Gbit/s ConnectX-7 có tốc độ đường truyền (tốc độ truyền danh nghĩa của liên kết) bằng 50 GB/s. Ở tốc độ đường truyền này, truyền 1 GB dữ liệu mất 20 ms. Mỗi lần truyền cũng cần thời gian khởi động, và chi phí giao thức cùng các lưu lượng khác chia sẻ liên kết cũng ảnh hưởng đến băng thông ứng dụng thực sự nhận được. Tính đến các yếu tố này dọc theo đường truyền cho phép ước lượng chi tiết hơn về thời gian truyền thông.
Bài tập 1-2 [Cốt lõi]: Yêu cầu bộ nhớ và phân bổ nhiều card dưới các độ chính xác trọng số khác nhau
Trọng số BF16 của DeepSeek-R1-Distill-Llama-70B chiếm 141,11 GB, và trọng số lượng tử hóa 8-bit chiếm 73,73 GB. Triển khai trên card H100 SXM, mỗi card 80 GB bộ nhớ. Dành 5 GB mỗi card cho trạng thái và workspace, hãy xác định việc triển khai một card và sơ đồ chia đều trọng số cho hai card có giữ nổi model không. Rồi xét hai card có dung lượng khác nhau: một RTX A6000 48 GB và một H100 SXM 80 GB; với mỗi độ chính xác, xác định việc triển khai có khả thi không, và với mọi sơ đồ khả thi hãy đưa ra một cách phân bổ trọng số. Cuối cùng, chuyển 400 Gbit/s sang GB/s, và tìm thời gian lý tưởng để truyền 1 GB.## 1.3 Ước lượng một lần thực thi model bằng vài con số
1.3.1 Sinh một token: kiểm tra gì trước
Ví dụ 1-1: Một model 70B có thể đạt mục tiêu sinh từng bước trong 10 ms không? Với một H100 SXM, liệu DeepSeek-R1-Distill-Llama-70B ở phần trước có sinh được một token mới trong 10 ms không? Trước tiên xét một byte lưu trữ cho mỗi tham số, rồi so sánh việc tăng gấp đôi thông lượng tính toán, tăng gấp đôi băng thông và việc tái sử dụng trọng số trong batch.
Lời giải: trước tiên kiểm tra dung lượng bộ nhớ, rồi tính FLOPs và lượng đọc.
Để đơn giản hóa việc tính tay, xấp xỉ số tham số của model này là , và trước tiên ước lượng khối lượng dữ liệu của trọng số chính ở một byte mỗi tham số, sau khi nạp thì chuyển sang BF16 cho phép nhân ma trận. Một request đơn xử lý một token mới mỗi bước, và mỗi bước đọc qua các trọng số này một lần từ GPU memory.
Điều kiện ước lượng: việc đọc trọng số và phép tính ma trận chồng lấp hoàn toàn. Dung lượng dùng con số 73,73 GB ở phần trước, bao gồm chi phí quantization; phần này xấp xỉ lượng đọc trọng số chính là 70 GB. Mô hình thời gian chỉ tính phép nhân–cộng cho các ma trận trọng số chính và một lần đọc trọng số trọn vẹn, dùng ma trận BF16 đỉnh và băng thông HBM từ bảng tài nguyên; việc đọc và tính toán được ước lượng giả định chồng lấp hoàn toàn.
Ngân sách dung lượng của một request đơn đã được kiểm tra ở phần trước. Còn về tốc độ sinh: một khi trọng số đã được nạp vào GPU memory, mỗi bước vẫn cần gửi các trọng số tham gia tính toán đến các đơn vị tính toán; theo xấp xỉ trên, mỗi bước đọc khoảng 70 GB.
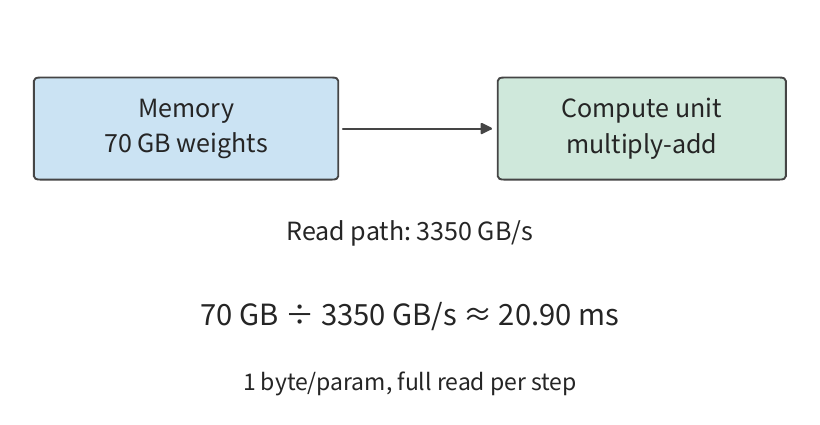
Chi phí đọc 20,90 ms này lặp lại ở mọi bước sinh. Với một request đơn, đầu vào của bước kế tiếp được quyết định bởi đầu ra hiện tại, và các bước sau phải tiến hành lần lượt dọc theo chuỗi phụ thuộc này.
Tải tính toán cũng có thể được xấp xỉ. Trong một phép nhân ma trận–vector, mỗi trọng số thường tham gia một phép nhân, và tích được cộng dồn vào kết quả; đếm riêng phép nhân và phép cộng, điều này tương ứng với khoảng hai phép toán dấu phẩy động. Vậy tải tính toán ma trận chính trong ví dụ này khoảng:
Nguồn gốc của là thế này: trong một projection (một phép biến đổi tuyến tính áp cho vector đặc trưng của một token dùng ma trận trọng số), mỗi trọng số được nhân với thành phần tương ứng của vector đặc trưng của token, và tích được cộng dồn vào đầu ra. Ma trận tham số càng nhiều trọng số, workload này càng lớn; khi số token được xử lý chung trong một batch tăng, cùng một ma trận trọng số xử lý vector đặc trưng của nhiều token hơn, và tải tính toán tăng theo. Chương 2 sẽ mở rộng sang một model thực tế, thêm các tương tác attention biến thiên theo độ dài context lên trên phần công việc tuyến tính này.
Gọi batch size là , và giả định request này chia sẻ một lần đọc trọng số, ta được ba đại lượng cho model giảng dạy này:
Hai biểu thức đầu tình cờ bằng nhau ở bước này vì trọng số được lưu một lần và đọc một lần. Khi thực thi bước sinh tiếp theo, lượng cư trú vẫn là , nhưng một lần đọc khác được phát sinh. Tăng làm tăng tải tính toán cho bước này: cùng một tập trọng số nay phải được nhân và cộng dồn với vector token đầu vào hiện tại của nhiều request hơn. Chương 2 sẽ thêm trạng thái context độc lập của từng request.
1.3.2 Tính toán và đọc mỗi cái mất bao lâu
Chia và cho năng lực tài nguyên tương ứng ta được hai cận dưới thời gian cho một request đơn.
Cận dưới của thời gian đọc trọng số lớn gấp khoảng 148 lần thời gian tính toán ma trận. Ở thông lượng tính toán danh nghĩa, phép toán ma trận mất rất ít thời gian; nhưng GPU memory mất nhiều thời gian hơn hẳn để đưa trọng số đến các đơn vị tính toán. Tất cả dữ liệu này phải được đọc vào trước khi bước hiện tại có thể hoàn thành.
Lý do là trong ví dụ này, mỗi lần đọc trọng số chỉ được dùng cho một phép nhân–cộng. Các đơn vị tính toán nhanh chóng xử lý xong dữ liệu đã đọc, rồi phải chờ thêm. Tăng thông lượng tính toán chỉ có thể rút ngắn thời gian nhân–cộng; nó không thể tăng tốc việc đọc bộ nhớ.
Việc hai thành phần thời gian này nên được cộng lại với nhau hay lấy cái lớn hơn làm tổng phụ thuộc vào việc đọc và tính toán có thể chồng lấp hay không. Nếu dữ liệu đến theo khối, khối tiếp theo có thể tiếp tục được đọc trong khi khối hiện tại đang được tính; theo mô hình chồng lấp hoàn toàn đơn giản hóa, cận dưới của thời gian là:
Một khi pipeline đạt trạng thái ổn định, mọi khối dữ liệu đều phải trải qua cả đọc và tính, và cái chậm hơn quyết định tốc độ xử lý. Trong ví dụ này, việc đọc trọng số chậm hơn hẳn tính toán ma trận, nên tối ưu hóa trước tiên nên nhắm vào thời gian đọc 20,90 ms này.
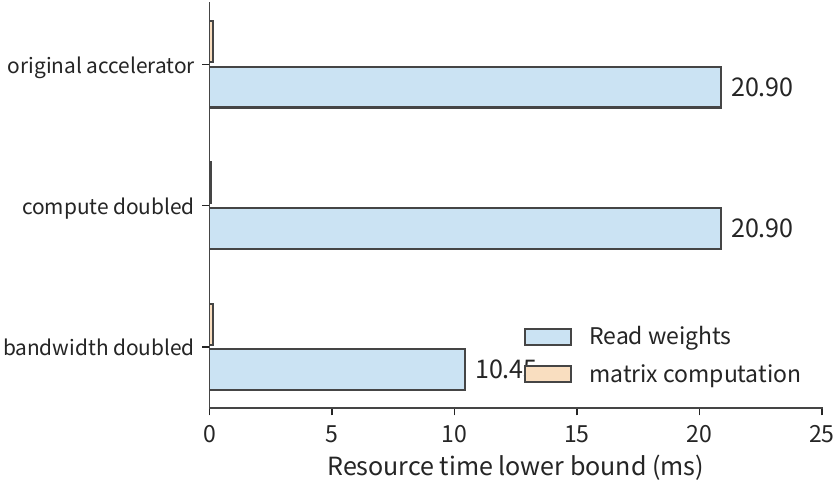
Thảo luận: thông lượng tính toán, băng thông và việc tái sử dụng trong batch — mỗi cái rút ngắn thời gian sinh được bao nhiêu? Riêng việc đọc trọng số đã mất ít nhất 20,90 ms, đã vượt quá mục tiêu 10 ms. Dù GPU memory có thể giữ dữ liệu này, tốc độ đọc vẫn chưa đạt những gì cần. Trước tiên hãy so sánh riêng tác động của việc tăng thông lượng tính toán với việc tăng băng thông.
Tăng gấp đôi thông lượng tính toán thay đổi thời gian tính toán ma trận từ khoảng 0,1415 ms xuống 0,0707 ms, trong khi đọc trọng số thuần vẫn mất khoảng 20,90 ms — cận dưới đọc quyết định thời gian thực thi vẫn không đổi. Ngược lại, tăng gấp đôi băng thông HBM đưa thời gian đọc xuống khoảng 10,45 ms, và cận dưới hiện tại giảm theo. Cả hai thay đổi đều cải thiện một năng lực phần cứng, nhưng chúng có tác động khác nhau đến thời lượng tác vụ.
Một cách tiếp cận khác là giảm lượng dữ liệu cần đọc. Giữ tải tính toán không đổi, giảm một nửa trọng số cũng đưa cận dưới đọc xuống khoảng 10,45 ms. Tăng gấp đôi băng thông làm tăng gấp đôi tốc độ đọc, còn giảm một nửa trọng số làm giảm một nửa lượng dữ liệu phải đọc; cả hai cách đều đạt cùng kết quả trong phép tính này. Chương 2 và 5 sẽ bàn các định dạng biểu diễn độ rộng bit thấp và quá trình chuyển đổi.
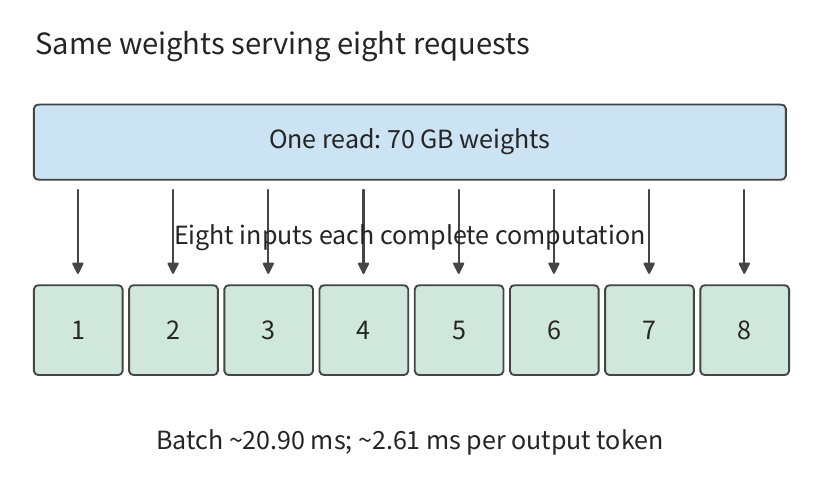
Tiếp theo, thay đổi cách tổ chức các request. Giả sử 8 request được xử lý chung và chia sẻ một lần đọc trọng số; tổng lượng đọc trọng số của batch vẫn là 70 GB, trong khi tải tính toán ma trận gấp khoảng 8 lần một request đơn. Cận dưới tính toán ma trận nay khoảng 1,13 ms, trong khi cận dưới đọc vẫn là 20,90 ms. Nếu batch này tạo ra 8 đầu ra, thời gian đọc trọng số phân bổ cho mỗi đầu ra khoảng 2,61 ms.
Thực thi cả batch tạo ra tám đầu ra, nên thông lượng tăng từ khoảng 47,9 token/s trong mô hình một request lên khoảng 383 token/s, trong khi mỗi request vẫn phải chờ toàn bộ batch thực thi xong. Tái sử dụng trong batch làm tăng số đầu ra sinh ra trong cùng một khoảng thời gian, còn độ trễ của một request đơn vẫn phụ thuộc vào việc thực thi và chờ đợi mà nó trải qua.
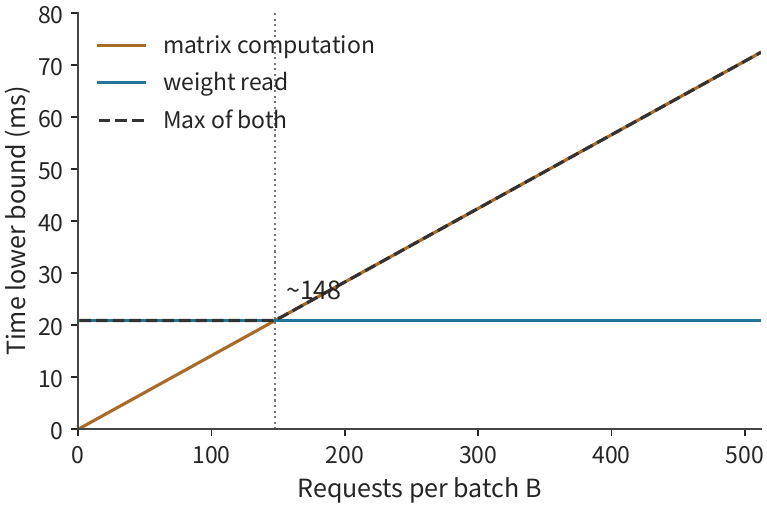
Khi batch size tăng vượt một mốc nào đó, thời gian tính toán đuổi kịp thời gian đọc trọng số. Đặt cho điểm ngoặt
Lấy , và trong ví dụ này ta được . Trong model này, chỉ tính phép toán ma trận chính và đọc trọng số, khi batch size nhỏ, thêm request sẽ phân bổ bớt chi phí đọc trọng số; một khi vượt khoảng 148, thời gian tính toán vượt thời gian đọc trọng số, và tiếp tục tăng batch size làm tăng thời gian toàn batch gần như tỷ lệ thuận. Điểm ngoặt này chỉ so sánh tính toán ma trận với đọc trọng số và không tính trạng thái context của từng request: theo ngân sách dung lượng ở Mục 1.2.3, một H100 SXM chỉ còn khoảng 6,27 GB sau khi giữ 73,73 GB trọng số, không đủ chứa KV của 148 request.
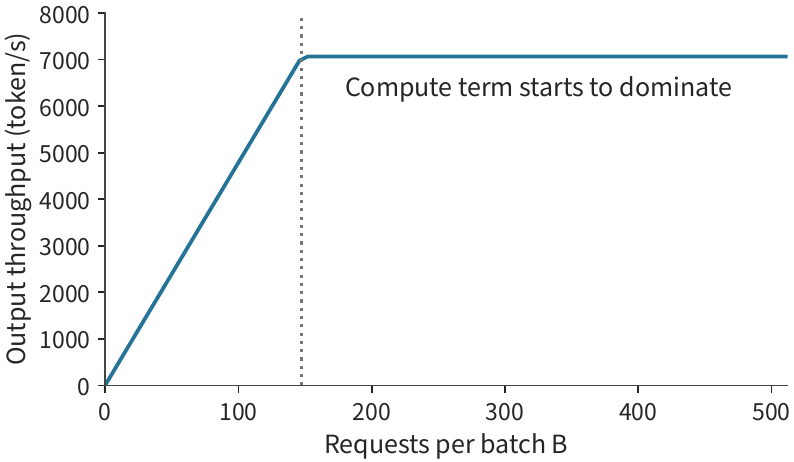
Chia số đầu ra mỗi batch cho cận dưới thời gian trong hình trên ta được cận trên thông lượng lý tưởng cho bộ giả định này. Trước điểm ngoặt, lần đọc dùng chung được phân bổ cho nhiều đầu ra hơn; sau nó, thời gian tính toán tăng cùng số đầu ra, và đường cong dần dẹt lại.
Điểm ngoặt tương tự cũng có thể được mô tả bằng cường độ số học , tức số phép toán thực hiện trên mỗi byte dữ liệu đọc. Khi nhỏ hơn tỷ lệ thông lượng tính toán trên băng thông của accelerator, , việc đọc lâu hơn; trên tỷ lệ đó, tính toán lâu hơn. Đây là điểm khởi đầu của mô hình Roofline trong Chương 4.
Bài tập 1-3 [Cốt lõi]: Băng thông và batch size ảnh hưởng đến hạn mức thời gian sinh từng bước thế nào
Dùng model và accelerator từ Ví dụ 1-1, đặt băng thông hiệu dụng là 70% danh nghĩa và thông lượng tính toán hiệu dụng là 50% đỉnh. Lấy lần lượt , tính cận dưới thời gian thực thi batch, thời gian thực thi trung bình phân bổ cho mỗi token đầu ra, và thông lượng lý tưởng. Mục tiêu là tối đa 10 ms mỗi request mỗi bước: dựa trên cận dưới thời gian, những batch size nào có thể bị kết luận là không khả thi cho mục tiêu này? Rồi giảm một nửa lượng đọc trọng số trong khi giữ tải tính toán không đổi, và đánh giá lại. Tìm batch size mà thời gian tính toán bằng thời gian đọc, và giải thích vì sao việc thời gian thực thi phân bổ cho mỗi đầu ra giảm không đồng nghĩa với độ trễ mỗi bước của mỗi request ngắn hơn.
1.3.3 Kiểm tra ước lượng với phép đo
Mô hình trước dự đoán hai xu hướng: ở batch size nhỏ, thông lượng tăng theo batch size; thời gian toàn batch khi đó bị giới hạn bởi một lần đọc trọng số. Trong các chương trình thực tế, mỗi request thêm vào cũng tăng truy cập context và tính toán. Hình 1-13 và 1-14 cho thấy các phép đo của Qwen3-8B dùng trọng số BF16 trên RTX PRO 6000 Blackwell Workstation Edition. Card này có 96 GB bộ nhớ, 1,792 TB/s băng thông bộ nhớ, và thông lượng ma trận đặc đỉnh 503,8 TFLOP/s với đầu vào BF16 và tích lũy FP32. vLLM là một hệ thống serving inference nguồn mở được các nhà nghiên cứu tại UC Berkeley và các tổ chức khác đề xuất năm 2023; nó tổ chức các request model và thực thi inference, và trọng tâm ban đầu là giải quyết vấn đề KV cache lãng phí bộ nhớ và giới hạn batch size. Phép đo này dùng phiên bản 0.23 ở chế độ eager, tức nộp công việc cho accelerator từng mục một theo thứ tự thực thi chương trình. Mỗi request có đầu vào 2048 token và sinh 256 token, và mỗi bung cài đặt batch size được đo ba lần. Throughput biểu thị số đầu ra sinh ra trên mỗi đơn vị thời gian; time per output token (TPOT) ở đây biểu thị khoảng cách đầu ra trung bình mà client quan sát được.
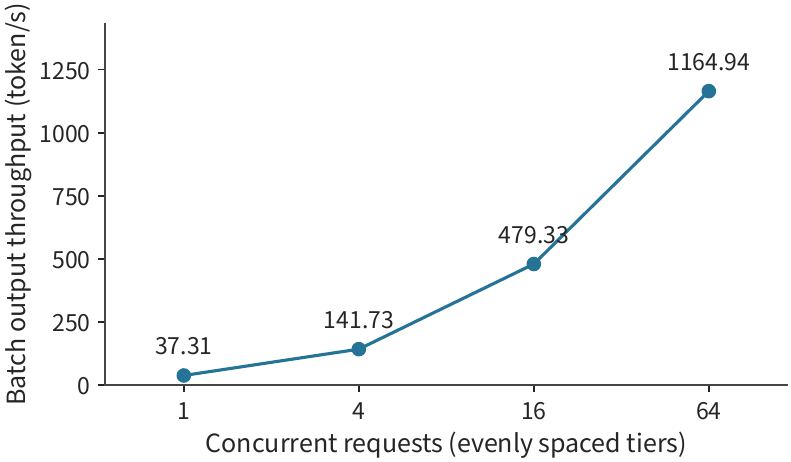
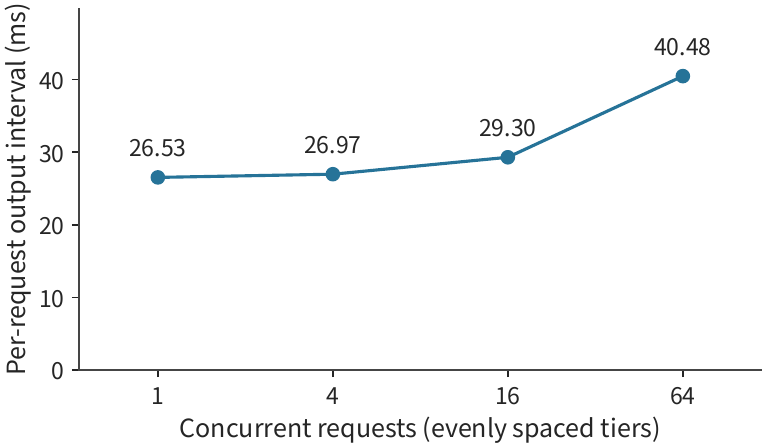
Từ 1 request lên 64 request, thông lượng toàn batch tăng khoảng 31 lần, trong khi khoảng cách đầu ra trung bình mỗi request tăng từ khoảng 26,5 ms lên 40,5 ms. Cùng nhau, hai hình mô tả sự đánh đổi của batching: accelerator hoàn thành nhiều công việc của nhiều request hơn trong cùng một khoảng thời gian, nhưng mỗi request mất nhiều thời gian hơn để hoàn thành một bước sinh.
Thông lượng trong Hình 1-13 được tính là số đầu ra toàn batch chia cho tổng thời gian xử lý batch đó, bao gồm thời gian xử lý đầu vào, với giá trị trung vị lấy trên ba lần đo. TPOT được tính bằng cách trước tiên lấy, cho mỗi request, thời gian giữa sự kiện đầu ra đầu tiên và cuối cùng, chia cho 255 khoảng đầu ra ở giữa, rồi lấy trung vị trên các request cùng batch, và cuối cùng lấy trung vị trên ba lần đo. Cái trước mô tả tốc độ đầu ra của toàn bộ instance, còn cái sau mô tả nhịp sinh mà một người dùng trải nghiệm. Chương 3 sẽ phân tích sâu hơn ảnh hưởng của sự đến của request, hàng đợi và một số ít request chậm lên các chỉ số này.
Xu hướng này có thể được giải thích bằng sự khác biệt giữa trọng số và trạng thái context. Nhiều request chia sẻ trọng số của model nhưng mỗi request duy trì trạng thái context của riêng nó. Khi độ đồng thời tăng, một phép toán ma trận xử lý vector token đầu vào hiện tại của nhiều request hơn cùng lúc, nên trọng số được tái sử dụng nhiều hơn; đồng thời, tính toán attention và truy cập context cũng tăng theo số request.
Thêm công việc phụ thuộc số request này vào mô hình cơ bản, thời gian mỗi bước trước tiên có thể được viết thành
trong đó là tải tính toán mỗi request và là lượng đọc/ghi trạng thái mỗi request. Khi batch size tăng, chi phí đọc trọng số được phân bổ cho nhiều đầu ra hơn, nhưng tổng lượng đọc/ghi trạng thái trên các request cũng tăng. Chương tiếp theo sẽ tính các workload này từ một model thực tế, và dự đoán điểm ngoặt — nơi thời gian tính toán bằng thời gian đọc — dịch chuyển đến đâu khi context dài ra.
Bài tập 1-4 [Cốt lõi]: Kiểm tra mô hình batching với thông lượng và khoảng cách đầu ra đo được
Dùng bốn mức độ đồng thời được đánh dấu trong Hình 1-13 và 1-14, tính tỷ lệ thông lượng và tỷ lệ tăng TPOT cho mỗi mức độ đồng thời so với một request đơn. Giả định rằng việc tăng độ đồng thời vẫn chỉ bị giới hạn bởi lần đọc trọng số dùng chung, với việc tính toán hay truy cập context không cộng thêm vào thời gian, thì thông lượng nên mở rộng thế nào? Đối chiếu với kết quả thực tế, đề xuất hai lời giải thích có thể được phân biệt bằng phép đo, và thiết kế một phép đo chỉ thay đổi độ dài context để xác định lời giải thích nào đúng. Nêu rõ những gì phải được giữ không đổi trước khi đo: model, độ dài đầu ra và điểm bắt đầu/kết thúc thời gian.
Nhìn lại bài tập ước lượng này, xuyên suốt chúng ta đã trả lời năm câu hỏi: cái gì được di chuyển, bao nhiêu, mấy lần, qua đường nào, và ai đang chờ. Cấu trúc model quyết định cần những trọng số nào, độ rộng bit và số tham số quyết định kích thước lưu trữ, việc tái sử dụng trong batch thay đổi số lần đọc, interface bộ nhớ cung cấp băng thông, còn các phụ thuộc thực thi quyết định việc chờ đợi. Năm câu hỏi này kết nối cấu trúc model, đường dữ liệu và thứ tự thực thi thành một ngân sách duy nhất có thể được tính từng số hạng.
1.3.4 Vì sao phép đo thấp hơn giới hạn: khoảng trống model hay chi phí hệ thống
Một cách tiếp cận phổ biến trong tối ưu hóa hệ thống là so sánh với triển khai trước: nếu operator mới nhanh hơn 30% so với operator cũ, nó được coi là thành công. Nhưng nếu không biết giới hạn nằm ở đâu, không có cách nào biết 30% đó đã gần trần hay vẫn còn cách một bậc độ lớn. Điểm khởi đầu đúng là tính giới hạn phần cứng cho phép từ những nguyên lý đầu tiên, rồi xem phép đo cách nó bao xa. Lấy phép đo của chương này làm ví dụ: ở băng thông GPU memory 1,792 TB/s, một bước decode đọc trọng số và KV cũ cần ít nhất 8,62 ms, trong khi khoảng cách đầu ra đo được ở batch size 1 là 26,5 ms — MBU chỉ 33%. Khoảng trống như vậy có thể đến từ hai nguồn, và chúng đòi hỏi cách xử lý khác nhau. Nguồn thứ nhất là khoảng trống trong mô hình lý thuyết: mô hình trên chỉ đếm việc đọc trọng số và KV, và bỏ qua các phép toán vector ngoài attention cùng bước sampling; thêm các số hạng này nâng cận dưới lên và thu hẹp khoảng trống, sửa chữa mô hình chứ không phải hệ thống. Nguồn thứ hai là chi phí vốn có của triển khai: thí nghiệm này nộp từng kernel một ở chế độ eager, và mỗi lần nộp đi qua code Python phía host, driver và PCIe, khiến accelerator rảnh rỗi giữa các lần khởi động kernel; client cũng ghi nhật ký kết quả từng bước, tiêu thụ thêm thời gian host. Chi phí này không liên quan gì đến phần cứng và có thể được loại bỏ. Phân biệt hai nguồn đòi hỏi các phép đo chỉ thay đổi một điều kiện mỗi lần. Trên cùng một card, sau khi tắt ghi nhật ký từng bước và đo lại, khoảng cách đầu ra giảm xuống 12,1 ms; chỉ đo các sự kiện trên accelerator, một bước thực thi model đơn lẻ mất 10,7 ms, trong phạm vi 20% so với cận dưới 8,62 ms. Điều này cho thấy phần lớn khoảng trống gấp ba lần đến từ chi phí hệ thống phía host. Trong các chương sau, bất cứ khi nào một phép đo bất đồng với cận dưới, chúng ta kiểm tra theo thứ tự sau: trước tiên xác định giới hạn từ các nguyên lý đầu tiên, rồi xác định khoảng trống là do một số hạng bị bỏ sót trong mô hình hay do chi phí hệ thống. Phương pháp này cũng áp dụng cho các trường hợp một phép đo nhanh bất thường: trước tiên kiểm tra xem nó có vượt quá giới hạn phần cứng không, rồi xem phép đo có thực sự đo đúng việc thực thi hoàn chỉnh hay không.## 1.4 Yêu cầu dẫn dắt thiết kế kiến trúc
Các ước lượng trên coi phần cứng là một điều kiện cho trước; trên thực tế, bản thân phần cứng được thiết kế để đáp ứng các yêu cầu cụ thể. Thiết kế kiến trúc bắt đầu từ vấn đề cần giải quyết. Quy mô của doanh nghiệp, năng lực của thiết bị và yêu cầu với phần mềm khác nhau giữa các thời đại, và những khác biệt này quyết định nhà thiết kế phải thay đổi điều gì trước tiên. Mục này lần lượt xem xét các yêu cầu về inference giọng nói Google đối mặt năm 2013, yêu cầu của Microsoft cho việc mở rộng mạng cloud Azure năm 2015–2016, và yêu cầu của Huawei cho việc tổ chức tính toán và lưu trữ nhiều thiết bị trong suốt quá trình phát triển model lớn.
1.4.1 TPU
TPU là một bộ xử lý tensor Google thiết kế cho tính toán mạng nơ-ron; sản phẩm thế hệ đầu tiên được ghi nhận là TPU v1. Bài báo giới thiệu thế hệ này kể lại một phán đoán về yêu cầu. Google đã thảo luận sớm về việc dùng GPU trong trung tâm dữ liệu, FPGA (có logic phần cứng cấu hình lại được sau khi triển khai), hoặc chip chuyên dụng, nhưng trong một số ứng dụng ban đầu, các tài nguyên rảnh rỗi trong các trung tâm dữ liệu hiện có đã đủ đáp ứng nhu cầu. Năm 2013, một dự báo về mức sử dụng tìm kiếm bằng giọng nói thay đổi cuộc thảo luận: nếu mỗi người dùng dành ba phút mỗi ngày cho tìm kiếm bằng giọng nói, việc đáp ứng nhu cầu tính toán này có thể đòi hỏi tăng gấp đôi quy mô các trung tâm dữ liệu. Google vì vậy đã thúc đẩy thiết kế một chip inference chuyên dụng; TPU v1 đi vào triển khai trung tâm dữ liệu năm 2015, và bài báo kiến trúc được công bố năm 2017.
Phán đoán này có thể được biểu diễn bằng một công thức đơn giản: gọi là khối lượng request hàng ngày và là tính toán cần cho mỗi request; tổng nhu cầu hàng ngày khi đó là . Khi khối lượng request tăng, năng lực rảnh rỗi của thiết bị hiện có cuối cùng bị cạn kiệt; lúc đó người ta có thể thêm máy chủ đa dụng hoặc phát triển một bộ xử lý chuyên dụng. Cách sau mang chi phí phát triển ban đầu nhưng có thể hạ thời gian thiết bị và năng lượng tiêu thụ cho mỗi request; quy mô dịch vụ càng lớn, khoản tiết kiệm tích lũy càng dễ bù đắp khoản đầu tư ban đầu.
Một bộ xử lý chuyên dụng có thể phân bổ nhiều đơn vị tính toán hơn cho các phép toán ma trận lặp lại thường xuyên, rồi dùng buffer on-chip và đường dữ liệu để cấp liệu cho các đơn vị tính toán đó. Yêu cầu độ trễ và năng lượng quyết định tài nguyên tính toán, lưu trữ và truyền thông nên được phân bổ thế nào. Bằng cách này, những thay đổi trong quy mô ứng dụng được chuyển trực tiếp thành thiết kế chip.
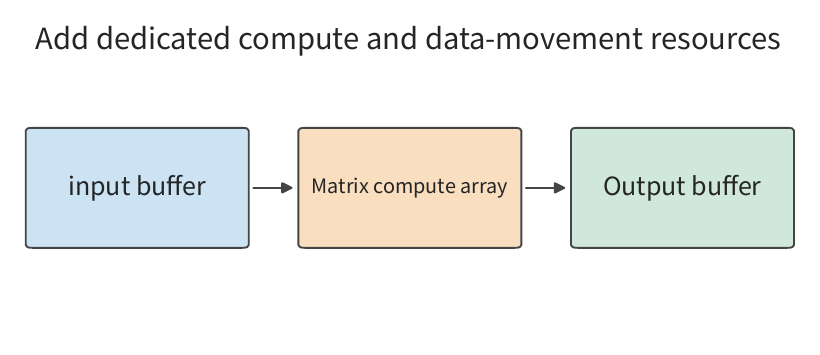
Chương 4 giới thiệu mảng ma trận, buffer và đường dữ liệu của TPU. Mối quan hệ ví dụ này minh họa là: một khi mức sử dụng của một ứng dụng đạt đến một quy mô nhất định, một bộ xử lý chuyên dụng có thể trở nên hiệu quả chi phí hơn một bộ xử lý đa dụng.
1.4.2 SmartNIC
Khi Microsoft Azure thiết kế máy chủ cloud 40 Gbit/s thế hệ tiếp theo năm 2015, nó đối mặt một kiểu tăng trưởng khác: băng thông mạng tăng lên cùng với chính sách mạng ảo ngày càng phức tạp. Một SmartNIC là một thiết bị có khả năng thực hiện một phần việc xử lý dữ liệu ngay trên card mạng. Bắt đầu từ cuối năm 2015, Microsoft lắp SmartNIC dựa trên FPGA vào các máy chủ Azure mới triển khai, và năm 2016 nó cung cấp cho khách hàng dịch vụ Accelerated Networking. Vì logic phần cứng của FPGA có thể được cấu hình lại, việc xử lý mạng có thể thay đổi khi chính sách được cập nhật.
Thiết kế này phải thỏa mãn hai yêu cầu cùng lúc: để lại nhiều lõi CPU hơn cho các ứng dụng của khách thuê, trong khi vẫn có thể nhanh chóng cập nhật các quy tắc cho việc cô lập mạng, chuyển tiếp và kiểm soát truy cập. Việc xử lý mạng trên một máy chủ cloud chiếm chính xác những lõi CPU này: ngoài việc chạy ứng dụng, CPU còn phải xử lý các gói tin gửi và nhận. Một máy ảo là một môi trường tính toán độc lập được phân chia từ một host vật lý. Khi nhiều máy ảo chia sẻ mạng vật lý, nền tảng phải xác định dữ liệu nào thuộc về máy nào, tra cứu quy tắc chuyển tiếp, thực hiện encapsulation và duy trì sự cô lập.
Bắt đầu bằng cách ước lượng việc xử lý này tiêu thụ bao nhiêu CPU. Một liên kết 40 Gbit/s, dưới điều kiện khung tối thiểu, cần xử lý khoảng sáu mươi triệu gói tin mỗi giây. Nếu một lõi đơn có thể xử lý mười đến hai mươi triệu gói tin mỗi giây, số lõi cần thiết cho việc chuyển tiếp liên tục gần đúng là
Ở đây là tốc độ đến của gói tin và là tốc độ xử lý của một lõi. Những lõi này lặp đi lặp lại thực hiện cùng một pipeline xử lý gói tin; chuyển công việc đó lên card mạng giải phóng thời gian CPU cho ứng dụng.
Cách tiếp cận của Azure là để phần mềm host quản lý chính sách phức tạp trong khi chuyển cho FPGA các quy tắc xử lý gói tin phù hợp để thực thi lặp lại. Khi dữ liệu đi qua card mạng, việc xử lý này được hoàn thành ngay tại đó, giải phóng CPU để dành nhiều thời gian hơn cho ứng dụng khách hàng. Chìa khóa của thiết kế là cân bằng khả năng cập nhật phần mềm với tốc độ xử lý phần cứng.
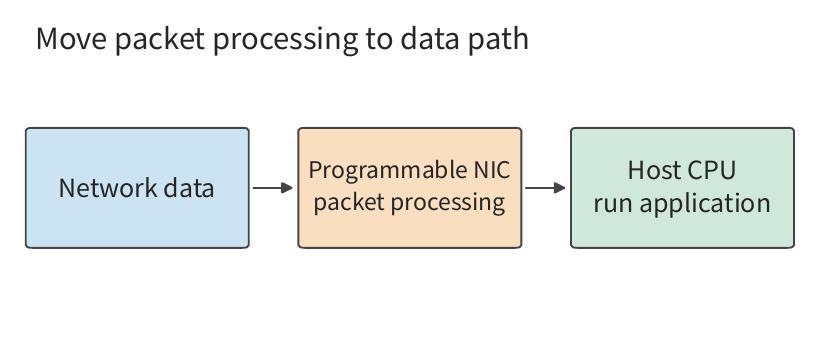
Một khi việc xử lý gói tin chuyển lên card mạng, một số thao tác có thể được hoàn thành trực tiếp khi dữ liệu đến, giảm khối lượng công việc của CPU. Nếu card mạng vẫn cần dữ liệu trong bộ nhớ host, nó phải đọc qua PCIe; trong trường hợp đó, độ trễ khứ hồi và số request phát hành đồng thời được quyết định tốc độ đọc. Chương 7 phân tích kiểu truy cập này bằng KV-Direct, một hệ thống cho phép một card mạng lập trình được xử lý trực tiếp các request key-value store. Một key-value store tra cứu, đọc hoặc cập nhật một giá trị bằng key duy nhất của nó.
1.4.3 Unified Bus
SmartNIC thay đổi sự phân công lao động trong một máy chủ đơn. Nếu vấn đề thay vào đó là tổng tài nguyên của một accelerator không đủ, người ta phải tiếp tục xem xét cách các accelerator hợp tác với nhau. Khi một accelerator không giữ nổi model và trạng thái chạy của nó, một trong những giải pháp trực tiếp nhất là thêm nhiều accelerator hơn. Nhưng giữa “tổng dung lượng lớn hơn” và “tác vụ thực thi hiệu quả” còn có việc phân chia công việc, trao đổi dữ liệu và đồng bộ.
Ví dụ, GPU memory gộp của hai card có thể đủ để giữ trọng số, nhưng accelerator thực hiện phép tính phải truy cập được dữ liệu nó cần. Nếu một bước tính toán phụ thuộc vào kết quả của card khác, nó phải chờ việc bàn giao; nếu nhiều card cùng hoàn thành một phép toán, sự hợp tác tương ứng cũng phải được tổ chức. Thêm accelerator mang về tài nguyên, nhưng cũng thêm công việc kết nối các tài nguyên đó.
UB (Unified Bus) của Huawei, được phát triển cho các thiết bị tính toán không đồng nhất như Ascend, mở rộng vấn đề sang hợp tác nhiều thiết bị. Theo hồi tưởng của những người tham gia dự án, nghiên cứu liên quan bắt đầu trước khi OpenAI phát hành language model tự hồi quy GPT-3 năm 2020; một khi GPT-3 thể hiện năng lực của các model lớn, ngành công nghiệp nhận rộng rãi hơn nhu cầu hợp tác nhiều thiết bị, và khoản đầu tư vào dự án mở rộng tương ứng.
Yêu cầu cốt lõi của giai đoạn này là cho các model ngày càng lớn tận dụng được nhiều card accelerator, và cho các thiết bị tính toán truy cập bộ nhớ và dữ liệu trên các thiết bị khác thuận tiện hơn. Một khi dữ liệu vượt qua ranh giới host, phần mềm phải chuyển sang interface truyền thông điệp, sắp xếp lại buffer, và đi qua driver card mạng cùng ngăn xếp giao thức — và mỗi tầng trừu tượng bổ sung thêm thời gian. UB cho phép một thiết bị truy cập trực tiếp bộ nhớ của thiết bị khác, loại bỏ các tầng trừu tượng này để chi phí thời gian của một truy cập từ xa tiến gần tới cận dưới do độ trễ dây dẫn đặt ra, trong khi các tầng trên cũng có thể tổ chức tài nguyên linh hoạt hơn. Một cơ chế truy cập hợp nhất cho phép các thiết bị dùng trực tiếp tài nguyên trên phạm vi rộng hơn, còn cấu trúc liên kết (topology) quyết định khoảng cách và băng thông của các truy cập này. Việc phân vùng model và thiết kế interconnect do đó gắn chặt với nhau. Mục 6.5.5 bàn tổ chức của UB từ góc độ quy mô supernode, còn Mục 7.3 và 7.4 truy vết đường đi của một truy cập từ xa đơn để suy ra độ trễ, tốc độ request và trạng thái kết nối của nó, và tính xem mỗi tầng trừu tượng bị loại bỏ đã chiếm bao nhiêu thời gian.
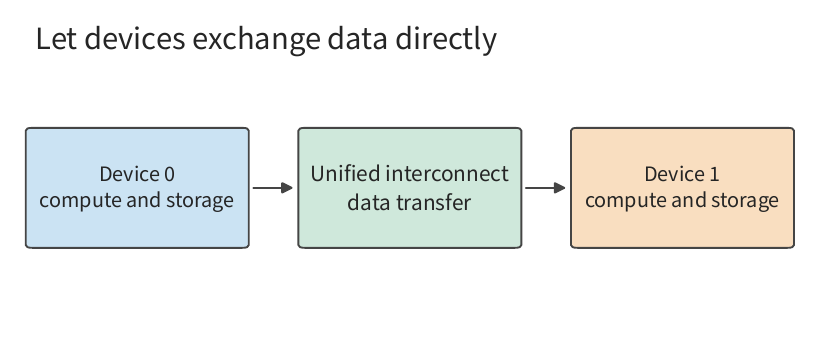
Từ inference giọng nói, đến mạng cloud, đến thực thi nhiều thiết bị cho model lớn, các thiết kế này mỗi cái tập trung cải thiện hiệu quả tính toán, giảm tiêu thụ CPU host và cải thiện truy cập xuyên thiết bị. Yêu cầu thay đổi đã chuyển dịch nút thắt cổ chai nào cần giải quyết trước, và cũng định hình lại sự phân công lao động giữa phần cứng, phần mềm và interconnect.
Đối chiếu lại với sơ đồ sáu tầng ở phần mở đầu: ba trường hợp mỗi cái bắt đầu từ một vấn đề khác nhau, nhưng tất cả cuối cùng đều định hình lại tổ chức của tính toán và di chuyển dữ liệu. Nhu cầu ứng dụng dẫn dắt thiết kế phần cứng chuyên dụng, vị trí xử lý chuyển dịch sự phân công lao động giữa host và card mạng, và các model lớn hơn đòi hỏi tổ chức lại sự hợp tác thiết bị. Các chương sau sẽ phát triển sợi chỉ chính của cuốn sách dọc theo những mối quan hệ này: di chuyển dữ liệu định hình kiến trúc của AI Infrastructure.
Lấy việc triển khai model hai card của chương này làm ví dụ: chia đều trọng số thỏa mãn ràng buộc dung lượng mỗi card, nhưng mỗi giai đoạn vẫn phải chờ dữ liệu đầu vào và kết quả từ các giai đoạn trước. Thêm accelerator thay đổi và lượng tính toán có sẵn, nhưng cũng đưa vào khối lượng truyền thông và phụ thuộc mới. Vì vậy bước đầu tiên là kiểm tra xem mỗi accelerator có giữ nổi dữ liệu nó cần không, bước thứ hai là tính khối lượng tính toán và đọc/ghi của mỗi accelerator, còn bước thứ ba là tính tổng thời gian dựa trên các phụ thuộc thực thi. Dù model lớn đến đâu hay có bao nhiêu accelerator, thứ tự phân tích này vẫn đúng.
Các cạm bẫy thường gặp
Cạm bẫy: tăng gấp đôi tính toán đỉnh sẽ tăng gấp đôi tốc độ thực thi. Trước tiên hãy kiểm tra việc thực thi hiện tại có thực sự bị giới hạn tính toán hay không. Trong Ví dụ 1-1, cận dưới của thời gian đọc trọng số lớn hơn hẳn cận dưới của thời gian tính toán ma trận, nên nâng tính toán ma trận đỉnh hầu như không thay đổi cận dưới của thời gian thực thi; và nếu tối ưu hóa chỉ nhắm vào một phần của một tác vụ hoàn chỉnh, định luật Amdahl cũng phải được dùng để kiểm tra trần của lợi ích.
Cạm bẫy: nếu GPU memory giữ được trọng số thì nó hỗ trợ được độ đồng thời mục tiêu. Trọng số chỉ là một phần của dữ liệu cư trú. Trạng thái context, workspace và các khoản dành riêng của runtime cùng chiếm GPU memory, và trên nhiều accelerator, mỗi card phải được kiểm tra riêng.
Cạm bẫy: nhanh hơn 30% so với triển khai cũ nghĩa là tối ưu hóa đã thành công. Nếu không biết giới hạn phần cứng cho phép, không có cách nào biết 30% đó gần trần hay vẫn còn cách một bậc độ lớn. Người ta nên tính giới hạn trước, rồi theo thứ tự ở Mục 1.3.4 để xác định khoảng trống đến từ mô hình bị thiếu số hạng hay từ chi phí hệ thống.
Cạm bẫy: thông lượng cao hơn nghĩa là thời gian chờ của mỗi người dùng ngắn hơn. Tái sử dụng trong batch giảm chi phí đọc phân bổ cho mỗi đầu ra, nhưng mỗi request vẫn phải trải qua hàng đợi và việc thực thi toàn batch. Thông lượng và thời gian phản hồi nên được báo cáo cùng nhau.
Bảng số tham chiếu nhanh
Bảng này tóm tắt, về phía model, các chỉ số quan trọng được đo cho Qwen3-8B trong Mục 1.3.3. Prefill xử lý đầu vào hiện có trong một lượt và tạo ra đầu ra đầu tiên; decode đưa lần lượt một token mới vào model, tiếp tục sinh bằng KV đã được lưu. Bảng này cố định trọng số, activation và KV ở BF16, với độ đồng thời 1; đầu vào của prefill là 2048 token, và decode thực thi một bước sau khi context 2048 token đã tồn tại.
| Yêu cầu model | Giá trị | Cách dùng |
|---|---|---|
| Toàn bộ trọng số BF16 | 16,38 GB | Xác định GPU memory cần để nạp model |
| KV toàn model mỗi token context | 144 KiB | Nhân với độ dài context để có dung lượng KV của một request |
| KV cho context 2048 token | 288 MiB | Khoảng 0,302 GB, mở rộng theo số request độc lập |
| Tính toán ma trận cho prefill 2048 token | 29,69 TFLOPs | Chia cho tốc độ ma trận tương ứng để có cận dưới thời gian tính toán |
| Tính toán ma trận cho một bước decode | 16,34 GFLOPs | Đầu vào là một token, cộng truy cập context hiện có |
| Đọc trọng số chính cho một bước decode | 15,14 GB | Trọng số được đọc một lần; tầng embedding (một bảng tra cứu ánh xạ id token sang vector) chỉ đọc hàng của token hiện tại |
| Đọc KV cũ cho một bước decode | 0,302 GB | Số byte đọc khi KV của mỗi context được đọc một lần |
Ước lượng cận dưới thời gian thực thi từ khối lượng tính toán và đọc. Dùng RTX PRO 6000 Blackwell Workstation Edition vốn dùng cho các phép đo trong Hình 1-13 và 1-14, trước tiên tính riêng tính toán ma trận và đọc dữ liệu: ở ma trận đỉnh 503,8 TFLOP/s, tính toán ma trận của prefill cần khoảng 58,9 ms, còn decode cần khoảng 0,0324 ms; ở băng thông GPU memory 1,792 TB/s, một bước decode đọc trọng số chính và KV cũ cần khoảng 8,62 ms. Khoảng cách đầu ra đo được ở batch size 1 khoảng 26,5 ms, gấp khoảng ba lần cận dưới đọc này; nguồn của khoảng trống này được bàn ở Mục 1.3.4. Ở đây tính toán và đọc được ước lượng riêng cho thời gian tối thiểu cần thiết của mỗi cái; một lần thực thi hoàn chỉnh còn phải cộng các thao tác khác, truy cập bộ nhớ thực tế và thời gian khởi động dọc theo chuỗi operator. Chương 2–5 sẽ xây dựng các phép tính này từng số hạng.
Những con số này giải thích sự khác biệt giữa hai giai đoạn: prefill xử lý một lượng lớn đầu vào trong một lần gọi, nên workload ma trận của nó lớn hơn; decode của một request đơn chỉ xử lý một token mỗi lần, nhưng vẫn phải đọc một lượng lớn trọng số và context. Tăng thông lượng tính toán, tăng băng thông và tăng việc tái sử dụng trong batch mỗi cái tác động lên một số hạng thời gian khác nhau.
Chú thích nguồn
- “Tháp mười tám tầng” do Tiến sĩ Liao Heng, Giám đốc Khoa học của Huawei Semiconductors, đề xuất trong một cuộc phỏng vấn dài công khai tháng 7/2026, để mô tả các phụ thuộc tầng-tầng từ ứng dụng xuống quy trình sản xuất.
- Jeff Dean, bài nói LADIS 2009, phần “Numbers Everyone Should Know” và mục ước lượng back-of-envelope. Ví dụ về thời gian seek giả định 20 lần đọc ngẫu nhiên liên tiếp.
- NVIDIA, sách trắng kiến trúc H100 và trang thông số. Chương này dùng dạng module SXM và thông số ma trận BF16 đặc.
- Kết quả ước lượng 70B ở Mục 1.3 đọc từ một tập cố định các kết quả xấp xỉ 70B; con số dung lượng ở Mục 1.2.3 dùng chỉ mục trọng số thực và kết quả lượng tử hóa theo nhóm.
- Williams, Waterman, Patterson, bài báo Roofline.
- Bản ghi phép đo theo dõi và đo thời gian sự kiện accelerator. Phép đo theo dõi cũng tắt prefix cache và dựng lại đầu vào, nên ảnh hưởng của việc ghi nhật ký từng bước không thể tách hoàn toàn khỏi các điều kiện này; các sự kiện accelerator chỉ bao phủ quá trình thực thi model, loại trừ sampling và đầu ra.
- Ghi chú Bài tập 1-4 và các kết quả phân tích có cấu trúc cùng phép đo theo dõi. Phần nội dung chính và Hình 1-13, 1-14 dùng nhóm đầu vào ngắn ghi ban đầu.
- Jouppi và cộng sự, bài báo TPU v1, Mục 2 về nguồn gốc, kiến trúc và triển khai. Con số ba phút tìm kiếm bằng giọng nói là một dự báo nhu cầu lịch sử ghi trong bài báo.
- Luận án tiến sĩ của tác giả, Mục 4.2.1 baseline chuyển tiếp đơn giản; con số khoảng sáu mươi triệu gói tin mỗi giây đến từ việc tính 40 Gbit/s với mức chiếm chỗ 84 byte mỗi khung trên dây; 3 đến 6 lõi tương ứng với baseline chuyển tiếp đơn giản.
- Khảo sát ranh giới trừu tượng; phần thảo luận về foundation model hỗ trợ nhiều tác vụ hạ nguồn có thể tham khảo báo cáo Stanford CRFM.
- Sơ đồ request minh họa trách nhiệm chung; việc phân chia trách nhiệm lập lịch và quản lý trạng thái có thể đối chiếu với tài liệu Scheduler vLLM v0.26.0; các phép đo ở Mục 1.3.3 dùng vLLM 0.23.0. Chính sách định tuyến, vị trí tokenizer và việc có tách prefill-decode hay không là các lựa chọn triển khai.
- Ví dụ sản phẩm cụ thể: NVIDIA GB200 NVL72, hướng dẫn phần cứng và hướng dẫn mạng. Hình 1-5 dùng một kết nối khái quát.
- Số tham số và số byte BF16 đến từ chỉ mục trọng số công khai và cấu hình phiên bản cố định của DeepSeek-R1-Distill-Llama-70B. Tổng khối lượng trọng số dưới lượng tử hóa theo nhóm dùng bản tóm tắt toàn model trong bản ghi tính toán từng mục, với 128 tham số mỗi nhóm và 2 byte mỗi scale. Thông số danh nghĩa 24 GB của RTX 4090 từ trang lưu trữ chính thức. Mục này dùng GB thông số danh nghĩa làm ngân sách dung lượng thống nhất.
- Firestone và cộng sự, Microsoft, Azure Accelerated Networking: SmartNICs in the Public Cloud, NSDI 2018. Tóm tắt đưa ngày triển khai cuối 2015 và khách hàng dùng được từ 2016; Mục 3 mô tả các mục tiêu thiết kế giảm tiêu thụ CPU, giữ tính lập trình được và hỗ trợ băng thông cao hơn.
- Các thông số GPU cố định từ cấu hình phần cứng, tương ứng với
rtx4090,a100-80gb-sxmvàh100-sxm; độ chính xác, cách tích lũy và điều kiện đặc được kiểm chứng riêng. GB và TB trong bảng này nhất quán là đơn vị thập phân. - Script tính số tham chiếu nhanh lập bảng tính toán ma trận prefill và decode dựa trên cấu hình Qwen3-8B cố định; khối lượng đọc đến từ phép tính tái sử dụng trọng số trong batch. Trọng số tiêu thụ bao gồm toàn bộ bảng embedding; trong quá trình sinh từng bước chỉ đọc hàng embedding của token hiện tại; thời gian đọc/ghi giả định điều kiện lý tưởng một lần truy cập cho mỗi mục dữ liệu chính.
- Báo cáo kỹ thuật chính thức DeepSeek V4.1, Mục 1, 2, 3 và 6; cùng các điều kiện cố định và tính lại cho phiên xuyên chương.
Tóm tắt chương
Ứng dụng biểu diễn hành vi thông qua model và context, và nhiều tác vụ do đó chia sẻ những tính toán nền tảng tương tự. Bằng cách nắm các phụ thuộc tính toán bên trong một model và trạng thái cư trú bao lâu, chúng ta có thể xem xét chung những lựa chọn thiết kế từng thuộc về các tầng riêng biệt: thay đổi biểu diễn dữ liệu, gộp các bước thực thi, tái sử dụng công việc chuẩn bị, hay rút ngắn thời gian dành cho truyền dữ liệu và đồng bộ giữa các accelerator. Các chương sau sẽ định lượng lợi ích của những thay đổi này, cho thấy những đánh đổi thiết kế nào dịch chuyển theo, rồi chọn model và phương án hệ thống dựa trên các ràng buộc mới.
Khi phân tích một hệ thống, trước tiên kiểm tra dữ liệu có vừa không, rồi dùng độ phức tạp tính toán và khối lượng đọc/ghi để ước lượng thời gian trôi qua, và cuối cùng phân tích sự chồng lấp và chờ đợi dựa trên thứ tự thực thi. Một cận dưới tính từ các giá trị đỉnh là giới hạn vật lý của phần cứng; tỷ lệ của cận dưới này với kết quả đo được là mức sử dụng. Bất kỳ khoảng trống nào giữa hai giá trị nghĩa là mô hình thiếu một số hạng hoặc hệ thống có chi phí có thể loại bỏ. Trong ví dụ 70B, đọc trọng số chậm gấp khoảng 148 lần tính toán ma trận, nên tăng băng thông, giảm đọc và cải thiện tái sử dụng đều giúp rút ngắn thời gian. Chia sẻ trong batch có thể nâng thông lượng, nhưng thời gian phản hồi của mỗi request vẫn phải bao gồm việc thực thi và xếp hàng của cả batch.
Các bài tập cốt lõi của chương này là 1-2, 1-3 và 1-4, lần lượt rèn luyện việc chuyển đổi đơn vị và phán đoán khả thi, ước lượng tài nguyên sau khi thay đổi điều kiện, và so sánh kết quả dự đoán với kết quả đo được. Chương tiếp theo sẽ tinh chỉnh việc ước lượng độ phức tạp tính toán và khối lượng đọc trọng số dựa trên các cấu hình model thực tế, cung cấp các kích thước ma trận và kích thước trạng thái cụ thể cho các phép tính này.