Chương 3 · Khối lượng công việc Inference & Training
Phân biệt các loại khối lượng công việc inference và training: prefill/decode, số lần gọi model, vòng đời trạng thái cư trú và chúng ảnh hưởng yêu cầu tài nguyên ra sao.
~82 phút đọc · Thuật ngữ
Khối lượng công việc Inference & Training
Giả sử một dịch vụ nhận trung bình bốn yêu cầu mỗi giây, mỗi yêu cầu có 4.608 token đầu vào và 1.152 token đầu ra. Chương 2 đã giải thích cách tính khối lượng công việc của model từ độ dài đầu vào và đầu ra. Nếu nhân khối lượng công việc trung bình với tốc độ yêu cầu mỗi giây, liệu chúng ta có thể xác định được tài nguyên cần thiết không?
Hai dịch vụ có thể có tốc độ yêu cầu trung bình và độ dài đầu vào/đầu ra trung bình giống hệt nhau: một dịch vụ nhận yêu cầu đều đặn ở mọi thời điểm, còn dịch vụ kia dành phút đầu tiên xử lý cường độ cao các tài liệu dài và phút thứ hai sinh phản hồi dài cường độ cao. Dịch vụ thứ nhất có nhu cầu tài nguyên tương đối ổn định qua các giai đoạn; dịch vụ thứ hai cần nhiều năng lực xử lý đầu vào hoặc năng lực sinh phản hồi hơn ở những thời điểm khác nhau. Ngoài thứ tự đến, các vòng trao đổi và thời gian chờ trong một nhiệm vụ cũng ảnh hưởng đến tải. Một agent đi lại giữa model và các công cụ; trong khi chờ kết quả của công cụ, model tạm dừng sinh, nhưng trạng thái ngữ cảnh vẫn phải được giữ lại cho các lần gọi sau. Trong training, độ dài chuỗi, nhãn hiệu quả (các token tham gia tính toán loss) và số lần cập nhật cũng ảnh hưởng đến khối lượng tính toán và thời gian trạng thái phải cư trú.
Chương 2 đã đưa ra dung lượng, tính toán và khối lượng truy cập bộ nhớ cho một lần gọi. Chương này bổ sung ba câu hỏi: khi nào công việc đến, bước nào phải chờ và kết quả nào được tính là hoàn thành nhiệm vụ. Từ đó, lần lượt xây dựng các mô hình cho hàng đợi, thời gian cư trú trạng thái, đường găng (critical path) và chi phí của một nhiệm vụ thành công, rồi kết hợp chúng để tính chi phí của training và các dịch vụ chạy lâu dài.
3.1 Từ một yêu cầu đơn lẻ đến tải đến liên tục
3.1.1 Prefill và Decode
Tải là tập hợp công việc đến, chờ đợi và thực thi trong hệ thống trong một khoảng thời gian nào đó. Trước tiên hãy phân tích một yêu cầu đơn lẻ theo thứ tự thời gian. Khôi phục token ngữ cảnh, xử lý token đầu vào mới và trả về token, chuỗi lần gọi gồm một lần prefill và lần gọi decode. Đánh số các lần gọi decode tiếp theo bắt đầu từ , tại thời điểm bắt đầu lần gọi thứ , ngữ cảnh hiện có là . Do đó, yêu cầu tài nguyên của mỗi lần gọi có thể được tính bằng các phương pháp ở Chương 2, và thứ tự giữa các lần gọi được xác định bởi sự phụ thuộc sinh (generation dependency).
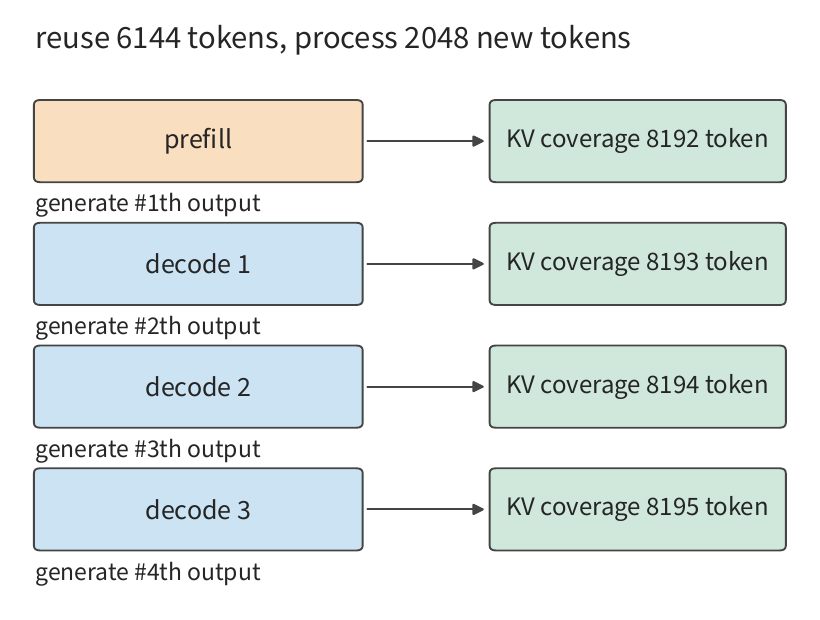
Hai giai đoạn dùng cùng một bộ trọng số nhưng có yêu cầu tài nguyên khác nhau. Lấy một bộ ma trận trọng số làm ví dụ: đầu vào của prefill chứa hàng, trong khi một bước decode chỉ có hàng. Khi có nhiều token đầu vào hơn, các trọng số được đọc trong một lượt có thể tham gia nhiều phép nhân-cộng hơn; ở mức đồng thời thấp, decode có thể đọc toàn bộ một bộ trọng số chỉ để phục vụ một số ít token. Đây là nguồn gốc của nhận định “prefill thường bị giới hạn bởi tính toán (compute-bound) còn decode thường bị giới hạn bởi băng thông bộ nhớ (memory-bandwidth-bound)”.
Ngoài một yêu cầu đơn lẻ, các cơ hội tái sử dụng mới cũng xuất hiện giữa các yêu cầu khác nhau. Khi nhiều lần gọi decode thực thi đồng thời, chúng chia sẻ cùng các trọng số trong khi mỗi lần gọi đọc ngữ cảnh riêng của mình; khi một đầu vào dài đến, prefill có thể xử lý nhiều token đã biết cùng lúc, và các vector đặc trưng của chúng tạo thành một ma trận đầu vào với nhiều hàng hơn. Hệ thống serving cần phân bổ thời gian giữa các phần công việc có hình dạng khác nhau này. Đơn giản cộng tổng số token sẽ làm mất thông tin về việc mỗi token thuộc giai đoạn nào và khi nào nó có thể thực thi.
Bài tập 3-1 [Mở rộng]: Số lượng yêu cầu thay đổi số lần gọi model như thế nào khi tổng đầu ra giống nhau
Xét một yêu cầu đơn lẻ sinh 1.024 token, so với tám yêu cầu mỗi yêu cầu sinh 128 token. Mỗi yêu cầu có đầu vào 1.024 token. Hãy tìm số lần gọi prefill, tổng số bước decode tiếp theo và độ dài ngữ cảnh ở cuối mỗi yêu cầu trong cả hai tình huống. Giả sử tám yêu cầu sinh đồng bộ, so sánh số vòng đọc khi mỗi lô dùng chung một lần đọc trọng số, rồi giải thích vì sao tổng đầu ra giống nhau không đủ để xác định thời gian hoàn thành.
3.1.2 Mục tiêu nhiệm vụ và chỉ số đánh giá
Các yêu cầu model và nhiệm vụ của người dùng thường không tương ứng một-một. Trả lời một câu hỏi có thể chỉ cần một lần gọi sinh, trong khi sửa một hàm có thể cần đọc tệp, chỉnh sửa mã, chạy kiểm thử và sửa lại mã dựa trên lỗi. Khi đánh giá một hệ thống, trước tiên hãy viết ra điều gì được tính là hoàn thành, sau đó quyết định đo lường điều gì.
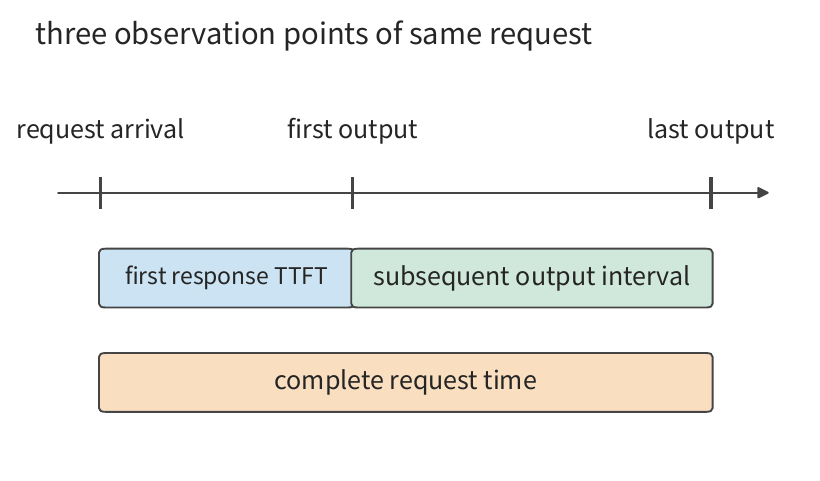
Trước tiên đánh dấu ba sự kiện trên trục thời gian: yêu cầu đến , token đầu tiên trả về và token cuối cùng trả về . Từ đó ta có
TTFT (time to first token — thời gian đến token đầu tiên) là khoảng thời gian từ khi yêu cầu đến cho đến khi token đầu tiên được trả về; cuốn sách này còn gọi nó là phản hồi phần đầu (first-chunk response). Phản hồi phần đầu đo thời gian bắt đầu xuất ra, độ trễ hoàn thành yêu cầu đo thời gian kết thúc sinh, còn khoảng cách token trung bình đo nhịp độ xuất ra. Rút ngắn một khoảng thời gian nhất định chỉ trực tiếp thay đổi các chỉ số bao gồm khoảng đó. Chẳng hạn, giảm thời gian xếp hàng trước khi yêu cầu bắt đầu thực thi giúp cải thiện TTFT, nhưng không tự động rút ngắn khoảng cách token khi quá trình sinh đã bắt đầu.
Trước khi token đầu tiên tới client, một yêu cầu lần lượt đi qua các giai đoạn như xếp hàng, chuẩn bị đầu vào, tính toán trên accelerator và trả kết quả. Việc đầu vào ban đầu được lưu trên host hay trên accelerator quyết định chuyển dữ liệu xảy ra ở đâu; sau khi tính toán hoàn tất, kết quả vẫn phải trải qua xử lý trên host và gửi qua kết nối. Bằng cách ghi lại thời điểm bắt đầu và kết thúc của từng giai đoạn cho cùng một yêu cầu, ta có thể thấy TTFT chủ yếu được tiêu vào đâu. Chương 5 sẽ trình bày chi tiết hơn về thời điểm cụ thể của việc đệ trình, truyền tải và hoàn thành trên accelerator.
Khi client nhận nhiều token theo khối, ta có thể ghi trực tiếp thời điểm đến và số token của mỗi khối, rồi tính các thống kê về nhịp độ xuất ra. Các model reasoning đưa thêm một điểm quan sát: chúng sinh nội dung suy nghĩ trung gian (gọi là token thinking) trước khi tạo ra câu trả lời hiển thị, nên khi token nội bộ đầu tiên xuất hiện, người dùng có thể chưa thấy câu trả lời. Do đó, sinh nội bộ, đầu ra người dùng thấy được và hoàn thành nhiệm vụ tương ứng với các thời điểm khác nhau trong thời gian. Việc phát lại âm thanh đầu tiên còn phải trải qua giải mã và bộ đệm thiết bị, được thảo luận thêm trong Mục 3.3.3.
| Câu hỏi cần trả lời | Chỉ số hoặc bản ghi cần thiết |
|---|---|
| Bao lâu thì phản hồi bắt đầu? | TTFT; với reasoning, còn ghi lại đầu ra hữu ích đầu tiên |
| Đầu ra có liên tục không? | khoảng cách theo token/theo khối và phân bố của nó |
| Bao lâu thì mọi việc xong? | thời gian yêu cầu hoàn chỉnh, thời gian nhiệm vụ hoàn chỉnh |
| Mỗi giây hoàn thành bao nhiêu nhiệm vụ đạt yêu cầu? | throughput hiệu quả dưới các yêu cầu về chất lượng và deadline |
| Chi phí để có một kết quả thành công là bao nhiêu? | chi phí model, công cụ và môi trường của mọi lần thử / số nhiệm vụ thành công |
| Điều gì vẫn bị chiếm dụng trong lúc chờ? | yêu cầu và phiên bản model mà trạng thái thuộc về, kích thước, vị trí lưu trữ và thời gian cư trú của nó |
Chỉ nhìn vào giá trị trung bình sẽ che khuất phần yêu cầu chậm hơn. p95 là phân vị thứ 95, dùng để mô tả phần chậm hơn của các quan sát đối với chỉ số đã chọn. Chương này dùng phương pháp hạng gần nhất (nearest-rank): sắp xếp quan sát theo thứ tự tăng dần và lấy quan sát thứ . p95 của bốn yêu cầu là giá trị lớn nhất; p95 của 480 yêu cầu là yêu cầu thứ 456. Việc sắp xếp riêng thời gian hoàn thành yêu cầu, xếp hàng và phản hồi phần đầu sẽ cho thấy thời gian chờ dài nằm ở đâu; p95 của yêu cầu hoàn chỉnh có được trực tiếp bằng cách sắp xếp tổng thời gian trôi qua của từng yêu cầu.
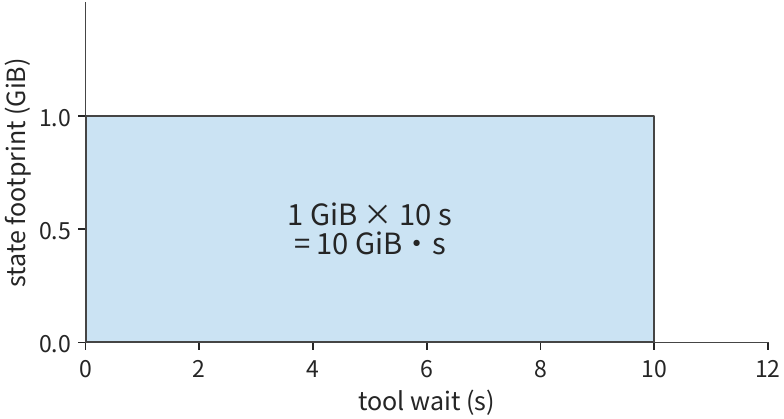
Ngoài thời gian phản hồi, mức chiếm dụng trạng thái trong lúc chờ cũng cần được đo. Trạng thái cư trú càng lâu, cùng một năng lực càng phục vụ được ít nhiệm vụ đồng thời. Gọi kích thước trạng thái nhiệm vụ là ; tích phân mức chiếm dụng trạng thái theo thời gian là
Nhân không gian chiếm dụng trong mỗi khoảng thời gian với thời lượng của nó rồi cộng lại sẽ ra diện tích dưới đường cong không gian chiếm dụng theo thời gian. Đơn vị của nó là byte·s: 1 GiB trạng thái chiếm không gian liên tục trong 10 giây tương ứng với 10 GiB·s. Bản thân trạng thái không lớn lên, nhưng trong khoảng thời gian đó khối không gian này không thể được các yêu cầu khác sử dụng. Nếu nhiệm vụ đến liên tục với tốc độ trung bình mỗi giây, mỗi nhiệm vụ chiếm byte và chờ trung bình giây, thì ở trạng thái ổn định, mức chiếm dụng trung bình chỉ riêng từ các nhiệm vụ đang chờ này là khoảng . Do đó, chờ công cụ cũng trở thành một vấn đề năng lực.
Ngoài thời gian và trạng thái, chi phí hoàn thành nhiệm vụ cũng phải được tính đến. Chi phí nhiệm vụ thành công cộng chi phí của mọi lần thử và chia cho số nhiệm vụ thành công. Theo cách này, các lần sinh thất bại, kiểm thử công cụ và chạy môi trường đều đi vào tử số, còn mẫu số tương ứng với các kết quả đạt yêu cầu mà người dùng thực sự nhận được. Khi một lô không có lần thành công nào, hãy ghi lại tổng tiêu thụ và nguyên nhân thất bại của nó; khi đã có kết quả thành công, chia tổng chi phí của mọi lần thử cho số nhiệm vụ thành công.
3.1.3 Phân bố yêu cầu
Nếu accelerator rảnh rỗi trong phút đầu tiên, rồi đột nhiên nhiều yêu cầu cần sinh dài xuất hiện trong phút thứ hai, thì các yêu cầu sau đó vẫn phải xếp hàng: phần thời gian tính toán rảnh rỗi trước đó không thể để dành dùng sau. TTFT và khoảng đầu ra mô tả trải nghiệm của một yêu cầu đơn lẻ; khi nhiều yêu cầu đến nối tiếp nhau, các chỉ số này còn phụ thuộc vào việc các yêu cầu có tranh chấp năng lực trong cùng một cửa sổ thời gian hay không.
Một mô tả tải nên giữ lại phân bố chung (joint distribution) của thời điểm đến, độ dài đầu vào và độ dài đầu ra. Yêu cầu dài vừa tăng thời gian phục vụ của chính nó vừa có thể kéo dài thời gian cư trú trạng thái; yêu cầu ngắn hoàn thành sớm có thể để các yêu cầu sau bắt đầu sớm hơn. Vì vậy, ngay cả với khối lượng công việc trung bình giống hệt nhau, thời gian chờ, thời gian hoàn thành và mức chiếm dụng trạng thái đỉnh có thể khác nhau. Dưới đây, giữ nguyên tổng số yêu cầu và độ dài trung bình của tải hai phút ở đầu chương, trước tiên ta tính thứ tự đến thay đổi tồn đọng (backlog) như thế nào, sau đó xem xét một hệ thống thực.
Các yêu cầu thực tế thường đến từ nhiều client khác nhau. Một client chủ yếu gửi tài liệu dài, client khác chủ yếu sinh phản hồi dài; ngay cả khi hình dạng yêu cầu của mỗi client ổn định, sự thay đổi tốc độ đến giữa các client vẫn làm thay đổi tải tổng thể. ServeGen, một nghiên cứu về các dịch vụ sản xuất, đã quan sát hiện tượng này và tái dựng phân bố yêu cầu bằng cách dùng cấu thành client và biến thiên theo thời gian.
Ví dụ làm việc 3-1: Nếu năng lực xử lý trung bình đủ, vì sao tồn đọng vẫn xảy ra? Decode được xử lý bởi hai card RTX PRO 6000 Blackwell Workstation Edition; xác định xem chúng có duy trì được tải ở đầu chương hay không.
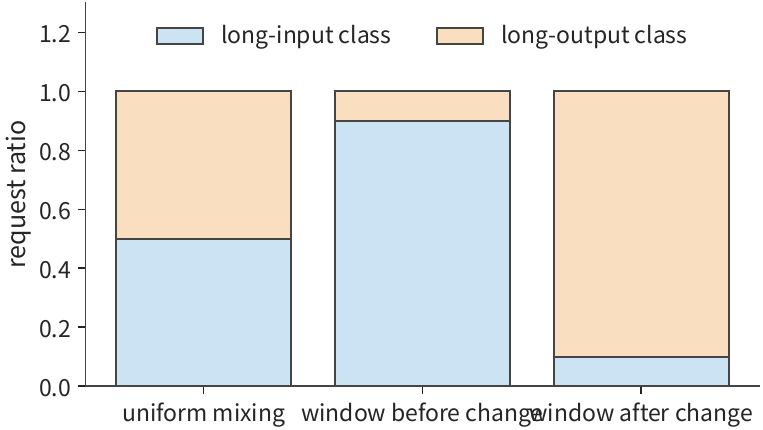
Lời giải: Định nghĩa hai loại yêu cầu: loại đầu vào dài có 8.192 token đầu vào và 256 token đầu ra; loại đầu ra dài có 1.024 token đầu vào và 2.048 token đầu ra. Trong hai phút, có 240 yêu cầu mỗi loại đến, tổng cộng trung bình bốn yêu cầu mỗi giây. Trong một kịch bản tải, hai loại mỗi loại chiếm một nửa số yêu cầu suốt thời gian; trong kịch bản khác, tỷ lệ là trong phút đầu và trong phút thứ hai. Đầu ra đầu tiên của mỗi yêu cầu do prefill tạo ra, và số bước decode tiếp theo bằng số đầu ra trừ một, cho ta:
| Cửa sổ thời gian | Token đầu vào mới/s | Bước decode tiếp theo/s |
|---|---|---|
| Hỗn hợp đều | 18.432 | 4.604 |
| Biến thiên theo thời gian, phút đầu | 29.900,8 | 1.736,8 |
| Biến thiên theo thời gian, phút thứ hai | 6.963,2 | 7.471,2 |
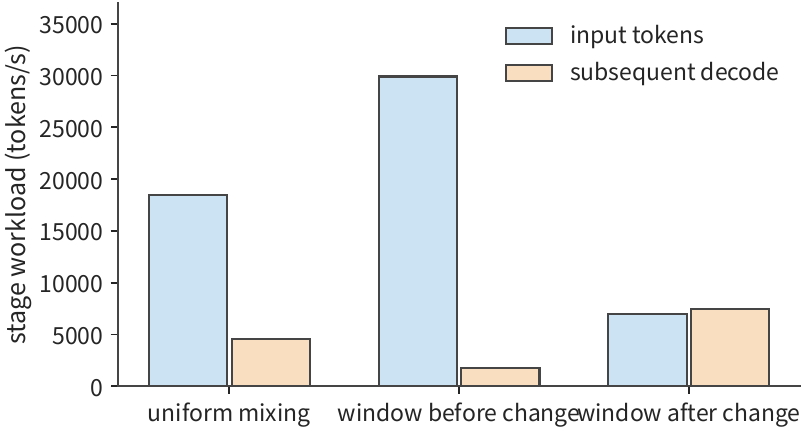
Giả định về hàng đợi: đến đều và tốc độ xử lý cố định trong một cửa sổ. Dùng mô hình hàng đợi chất lỏng (fluid queue), chúng ta xấp xỉ công việc sinh rời rạc như một dòng chảy liên tục; sự đến là đều trong mỗi cửa sổ, tốc độ xử lý cố định và hàng đợi ban đầu rỗng. Đơn vị là một bước decode tiếp theo của một yêu cầu; năng lực prefill được tính riêng.
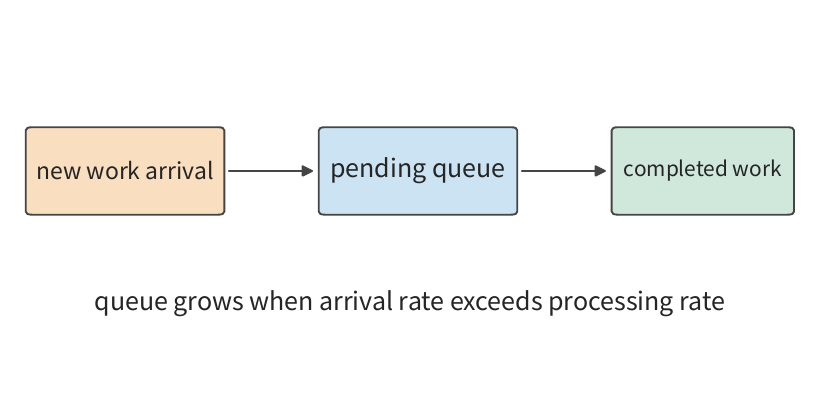
Lấy cửa sổ thời gian làm bước, tồn đọng có thể được tính theo từng cửa sổ như sau:
Ở đây là công việc chờ xử lý ở đầu cửa sổ, là công việc mới đến trong cửa sổ và là lượng có thể hoàn thành. Khi tốc độ đến thấp hơn tốc độ xử lý, tồn đọng giảm dần cho đến khi hàng đợi rỗng; khi tốc độ đến vượt tốc độ xử lý, công việc chưa xong được chuyển sang cửa sổ tiếp theo.
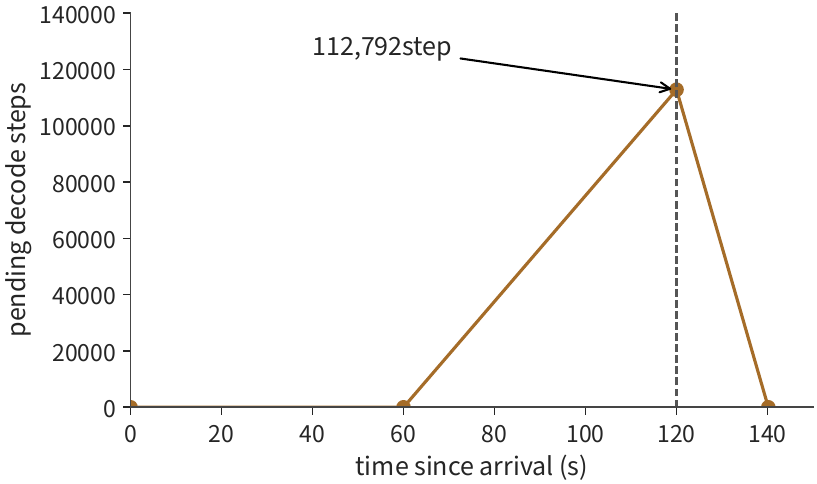
Tốc độ xử lý trong hệ thức truy hồi phải được suy ra từ thông số phần cứng. Vì đầu ra đầu tiên của mỗi yêu cầu trong bốn yêu cầu mỗi giây do prefill tạo ra, nên 4.604 trong số 4.608 đầu ra thuộc về decode tiếp theo. Tốc độ xử lý decode được xác định bởi băng thông bộ nhớ. RTX PRO 6000 Blackwell Workstation Edition có 96 GB bộ nhớ GPU và băng thông 1.792 GB/s; mỗi card giữ một bản đầy đủ trọng số BF16 của Qwen3-8B và thực thi tối đa 64 chuỗi đồng thời. Mỗi bước decode phải đọc ít nhất một lần 15,14 GB trọng số dùng chung, cộng thêm đọc toàn bộ KV cũ của mỗi chuỗi, với 144 KiB cho mỗi token ngữ cảnh. Trong lúc decode, ngữ cảnh trung bình của loại đầu vào dài là token, còn của loại đầu ra dài là token; với hỗn hợp đều, tính theo trọng số của bước decode, ngữ cảnh trung bình là token. Với 64 chuỗi thực thi đồng thời, một bước đọc và ghi ít nhất 41,02 GB, mất 22,89 ms, nên một card có thể hoàn thành tối đa khoảng 2.795,66 bước mỗi giây, và hai card khoảng 5.591,33 bước mỗi giây. Tốc độ xử lý này là giới hạn vật lý cho phép của băng thông bộ nhớ; tốc độ đo được sẽ chỉ thấp hơn. Cả ba cửa sổ thời gian đều dùng cùng tốc độ xử lý này.
Cho hàng đợi decode bắt đầu rỗng và trải đều công việc sinh của mỗi yêu cầu theo các cửa sổ: năng lực xử lý đủ cho cả hỗn hợp đều và phút đầu; trong phút thứ hai, thêm khoảng bước đến mỗi giây, để lại tồn đọng khoảng 112.792 bước sau 60 giây; sau khi sự đến dừng, cần thêm khoảng giây để xử lý hết. Năng lực không dùng đến trong phút đầu không thể để dành cho phút thứ hai — đây chính là lý do vì sao giá trị trung bình tổng thể che giấu tồn đọng.
Các ràng buộc năng lực KV ảnh hưởng đến xếp hàng và phản hồi phần đầu như thế nào. Chạy hai chuỗi đến này trên Qwen3-8B/vLLM 0.23, ta có thể quan sát các khác biệt trên ảnh hưởng đến sự chờ đợi của người dùng như thế nào. Accelerator là một RTX PRO 6000 Blackwell Workstation Edition với 96 GB bộ nhớ GPU; vùng chứa KV (KV pool) là vùng bộ nhớ GPU dành riêng cho ngữ cảnh khóa-giá trị của các yêu cầu, với dung lượng 24 GiB ở đây, thực thi tối đa 64 chuỗi đồng thời; bộ nhớ đệm tiền tố (prefix cache) dùng để tái sử dụng KV hiện có giữa các yêu cầu dùng chung tiền tố, bị tắt ở đây, mỗi yêu cầu sinh một số token xác định. Khi không gian KV cạn, scheduler có thể tạm dừng một yêu cầu đã bắt đầu và giải phóng không gian KV nó đang chiếm, sau đó tiếp tục hoặc tính lại — hành vi này được gọi là preemption (giành quyền ưu tiên). Cả hai kịch bản tải đều có 480 yêu cầu đến trong 120 giây; kết quả sau khi tất cả yêu cầu hoàn thành như sau.
| Quan sát đo được | Hỗn hợp đều | 9:1 đầu, 1:9 sau |
|---|---|---|
| Yêu cầu hoàn chỉnh p95 | khoảng 299,4 s | khoảng 299,4 s |
| TTFT p95 | 242,9 s | 258,9 s |
| Chờ lập lịch đầu tiên p95 | 242,4 s | 258,4 s |
| Thời gian từ bắt đầu đến hoàn thành yêu cầu cuối | 419,8 s | 418,7 s |
| Sự kiện preemption | 62 | 24 |
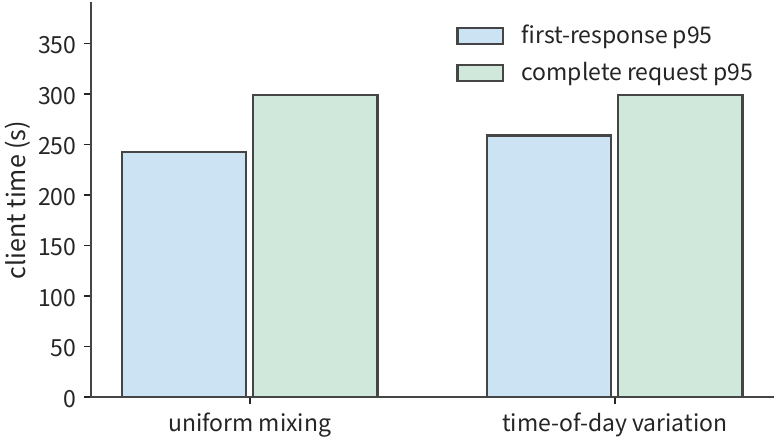
Cả hai lần phát lại đều cho tồn đọng đáng kể, điều đã có thể dự đoán từ cận dưới băng thông trong Ví dụ làm việc 3-1: một card có thể hoàn thành tối đa khoảng 2.796 bước decode mỗi giây, thấp hơn nhu cầu trung bình 4.604 bước mỗi giây trong hỗn hợp đều, và chính card đó còn phải thực hiện prefill. Tổng cộng 480 yêu cầu cần 552.480 bước decode tiếp theo; riêng phần công việc này đã cần ít nhất 197,6 giây, trong khi tất cả yêu cầu đã đến trong 120 giây.
Yêu cầu hoàn chỉnh p95 và thời gian hoàn thành cuối cùng gần nhau giữa hai lần phát lại, nhưng TTFT và thời gian chờ lập lịch đầu tiên chênh khoảng 16 giây. Các bản ghi lấy mẫu cho thấy mức chiếm dụng vùng chứa KV đạt 100% trong cả hai thí nghiệm, và các yêu cầu chờ rất lâu trước khi vào thực thi. Sự kết hợp theo thời gian của đầu vào và đầu ra đã thay đổi khi trạng thái được giải phóng và khi yêu cầu mới được nhận vào, nên dù thời gian hoàn thành của toàn bộ lô gần nhau trong cả hai trường hợp, thời điểm người dùng bắt đầu nhận phản hồi vẫn có thể khác. Việc preemption xảy ra khi vùng chứa KV đầy cũng làm thay đổi thời gian chờ và thứ tự thực thi tiếp theo của các yêu cầu.
Do đó, xếp hàng có thể phát sinh hoặc do tốc độ xử lý không đủ, hoặc do trạng thái của các yêu cầu hiện có chưa được giải phóng: một khi vùng chứa trạng thái đầy, các yêu cầu mới phải chờ dù một số đơn vị tính toán đang rảnh.
Hệ thức tồn đọng từ Ví dụ làm việc 3-1 cũng có thể dự đoán tồn đọng trong các điều kiện bùng nổ (bursty) khác. Nếu tốc độ đến của công việc vượt tốc độ xử lý liên tục trong giây, với hàng đợi ban đầu rỗng, tồn đọng là ; thời gian xử lý hết sau khi sự đến dừng là . Nhân đôi thời lượng bùng nổ sẽ nhân đôi cả tồn đọng lẫn thời gian xử lý hết.
Bài tập 3-2 [Cốt lõi]: Yêu cầu bùng nổ và chờ công cụ làm tăng tồn đọng và chiếm dụng trạng thái như thế nào
Dùng cường độ tải phút thứ hai từ Ví dụ làm việc 3-1, tức 7.471,2 bước decode thêm mỗi giây, đổi thời lượng của tải bùng nổ này thành 30 giây, với tài nguyên decode là hai và ba card RTX PRO 6000 Blackwell Workstation Edition, tốc độ xử lý mỗi card theo khoảng 2.796 bước/giây suy ra trong Ví dụ làm việc 3-1. Với hàng đợi ban đầu rỗng, hãy tìm tồn đọng biến thiên thế nào trong 30 giây này và thời gian cần thiết để xử lý hết tồn đọng sau khi sự đến dừng. Sau đó xét một tải khác: hai nhiệm vụ mỗi giây bước vào giai đoạn chờ công cụ, mỗi nhiệm vụ chờ 10 giây, trong thời gian đó trạng thái của nó chiếm 1 GiB không gian. Hãy tìm số nhiệm vụ đang chờ trung bình và mức chiếm dụng trạng thái ở trạng thái ổn định; tính lại sau khi kéo dài thời gian chờ thành 30 giây.
3.2 Tương tác nhiều lượt và nhiệm vụ Agent
3.2.1 Hội thoại nhiều lượt và sự tăng trưởng tiền tố
Mục 3.1 coi mỗi yêu cầu là một lần gọi độc lập; trong hội thoại và nhiệm vụ agent, nhiều lần gọi của cùng một nhiệm vụ được liên kết theo trình tự. Yêu cầu tiếp theo trong hội thoại nhiều lượt thường mang theo ngữ cảnh. Đầu vào của lượt đầu bao gồm system prompt và câu hỏi của người dùng; lượt thứ hai, ngoài câu hỏi mới, còn có thể bao gồm câu trả lời của lượt trước; mỗi lượt tiếp theo tiếp tục tích lũy. Chỉ nhìn vào số ký tự người dùng mới gõ sẽ đánh giá thấp độ dài đầu vào thực sự được đưa vào model.
Gọi độ dài đầu vào của lượt là và độ dài tiền tố tái sử dụng được là ; thì đầu vào phải xử lý mới trong lượt này là
Thay và vào các công thức ở Chương 2: các phép chiếu và quá trình FFN chỉ xử lý các token mới thêm, còn attention vẫn yêu cầu query mới truy cập toàn bộ tiền tố. Tái sử dụng bộ nhớ đệm do đó giảm việc tính lại, nhưng không loại bỏ ngữ cảnh cũ khỏi tính toán tiếp theo.
Lấy một nhiệm vụ sửa mã gồm bốn lần gọi model làm ví dụ để tính lợi ích của caching. Qua bốn lượt, đầu vào tích lũy là 5.297 token, trong đó 4.480 token trúng bộ nhớ đệm và 817 token trượt. Đầu vào của lượt thứ hai là 1.443 token, trong đó 1.392 trúng, nên chỉ có 51 token chưa được lưu đệm cần xử lý; nhưng các lần gọi decode tiếp theo vẫn cần truy cập trạng thái ngữ cảnh này. Nếu mỗi lượt tính lại toàn bộ đầu vào từ đầu, các phép toán ma trận của prefill sẽ cần tổng cộng 76,196 TFLOPs; bằng cách tái sử dụng tiền tố đã trúng đệm, tổng cộng chỉ cần 11,976 TFLOPs. Do đó, trúng bộ nhớ đệm vừa giảm việc tính lại đầu vào cũ vừa đòi hỏi hệ thống tiếp tục giữ trạng thái cũ.
Việc sửa đổi ngữ cảnh thay đổi độ dài của tiền tố tái sử dụng được. Khi nội dung mới được thêm vào cuối, tiền tố ban đầu không đổi; khi một bản tóm tắt thay thế một đoạn ngữ cảnh cũ, các biểu diễn sau vị trí thay thế phải được tính lại từ tiền tố mới; thay đổi định nghĩa công cụ hoặc template có thể làm thay đổi đầu vào sớm hơn nữa. Các thao tác này quyết định bao nhiêu token trúng bộ nhớ đệm ở lượt sau và bao nhiêu token quay lại prefill.
Chiến lược ngữ cảnh cũng làm thay đổi tải tương lai. Liên tục thêm nội dung mới vào cuối ngữ cảnh có lợi cho việc tái sử dụng tiền tố ban đầu, nhưng để nội dung cũ tiếp tục chiếm ngữ cảnh; thay thế nội dung sớm hơn có thể rút ngắn ngữ cảnh, nhưng bộ nhớ đệm phía sau nó có thể phải được dựng lại. Chi phí giữ lại, loại bỏ và tính lại phụ thuộc vào chi phí dựng lại, kích thước trạng thái và khoảng tái sử dụng (Chương 8).
Dùng quan hệ tái sử dụng tiền tố của mục này, so sánh hai cách sửa: thêm 100 token vào cuối chỉ thêm 100 hàng đầu vào mới; trái lại, sửa token thứ 501 trong 2.000 token hiện có sẽ thay đổi tất cả biểu diễn sau nó, để lại tối đa 500 token tiền tố tái sử dụng trực tiếp. Lợi ích của caching không chỉ phụ thuộc vào lượng văn bản được thay đổi, mà còn vào vị trí thay đổi xảy ra.
Từ góc độ ứng dụng, ngữ cảnh là giao diện để điều phối nhiệm vụ; từ góc độ hệ thống, cách tổ chức ngữ cảnh quyết định khối lượng tính toán và thời gian cư trú trạng thái. Thêm nội dung trả về của công cụ, thay thế nội dung trước đó và sinh nhiều nhánh ứng viên lần lượt thay đổi tính toán mới thêm, tiền tố tái sử dụng được và trạng thái riêng. Cho hệ thống serving hiểu các quan hệ này cho phép nó sắp xếp caching dựa trên các mẫu tái sử dụng, chia sẻ lịch sử giữa các nhánh và hoán đổi trạng thái trong thời gian chờ công cụ. Do đó, các bản ghi tải cũng nên bao gồm tiền tố ổn định, vị trí viết lại, phụ thuộc nhánh và khoảng tái sử dụng. Chương 8 sẽ dùng thông tin này để chọn chiến lược ngữ cảnh và caching, và Chương 9 sẽ đưa thêm vị trí trạng thái và thời gian truyền tải.
3.2.2 Reasoning và xác minh: chi phí hoàn thành một nhiệm vụ là bao nhiêu
Prefix caching giảm tính toán lặp lại trên đầu vào hiện có. Một lớp phương pháp khác chủ động tăng tính toán sinh, hy vọng nâng cao độ đúng của câu trả lời. Có ba cách chính để tăng tính toán ở giai đoạn inference: kéo dài quá trình suy nghĩ trong một phản hồi đơn lẻ, sinh song song nhiều phản hồi rồi chọn lọc, hoặc phân bổ số lượng và độ dài sinh theo độ khó của bài toán. Kéo dài suy nghĩ làm tăng thời gian sinh tuần tự và trạng thái ngữ cảnh; sinh nhiều phản hồi làm tăng số lần tính toán và xác minh; phân bổ theo độ khó đòi hỏi quyết định khi nào dừng cho từng bài toán.
Liệu việc tăng tính toán sinh có đáng hay không cần so sánh chi phí cho mỗi nhiệm vụ thành công. Gọi chi phí trung bình mỗi lần thử là và tỷ lệ thành công là ; dưới cùng một chiến lược, số lần thử lặp lại kỳ vọng là , nên
Gọi chi phí và tỷ lệ thành công của phương pháp mới là , của phương pháp cũ là ; việc giảm chi phí đòi hỏi . Do đó, cơ sở để kéo dài suy nghĩ hay tăng lấy mẫu là liệu mức cải thiện tương đối về độ đúng có vượt qua mức tăng tương đối về chi phí hay không. Chi phí của mọi lần sinh, xác minh và các lần thử thất bại đều được đưa vào .
Ví dụ: kéo dài sinh vẫn không cải thiện tỷ lệ thành công trên một bài toán. Tốc độ sinh chỉ phản ánh một hệ thống có hữu ích hay không khi được xét cùng với độ đúng của nhiệm vụ. Trong một thí nghiệm toán, nhiều phản hồi được sinh cho mỗi bài trong bốn bài, và giới hạn đầu ra được nâng từ 1.024 lên 4.096 token; sau hai vòng thử, không câu trả lời cuối nào qua được chấm điểm. Sinh đã tiêu thụ tài nguyên, nhưng nhiệm vụ không hoàn thành; tăng độ dài đầu ra không tự động tạo ra lời giải hợp lệ.
Kiểm tra câu trả lời nên phân biệt định dạng giao diện với độ đúng nội dung. Một phản hồi có định dạng đúng vẫn có thể tính sai, và một phản hồi đúng về số vẫn có thể thiếu các trường mà nhiệm vụ yêu cầu. Chỉ khi tách hai loại lỗi này mới có thể đánh giá nên điều chỉnh cách sinh, các ràng buộc đầu ra hay quá trình giải.
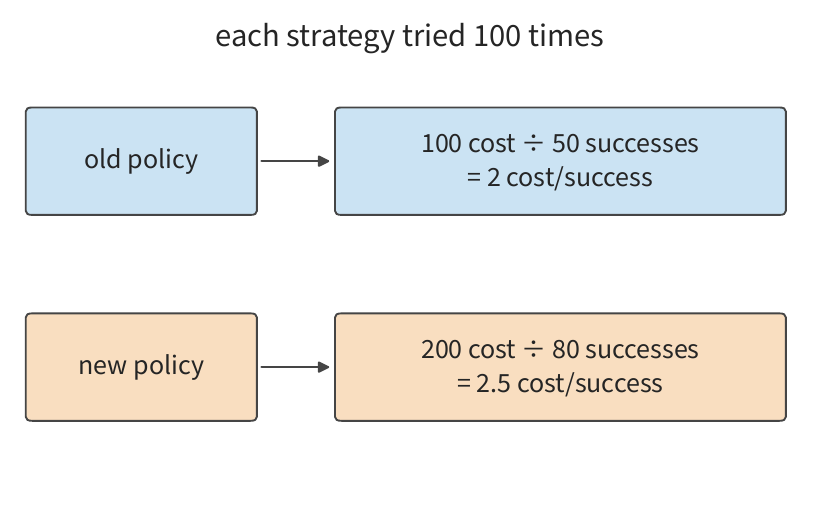
Khi hạch toán chi phí, bản thân sự thay đổi giá cũng phải được xét đến. Ngay cả sau khi giá mỗi token giảm, tổng chi phí hoàn thành nhiệm vụ vẫn cần được tính. Một giả định đơn giản minh họa điều này: giá mỗi token của hệ thống mới giảm xuống còn 1/10 so với ban đầu, nhưng mức sử dụng mỗi nhiệm vụ tăng lên 20 lần, và tỷ lệ thành công tăng từ 50% lên 80%. Chỉ tính chi phí model, và giả định phân bố các lần thử lặp lại ổn định, tỷ lệ chi phí cho mỗi nhiệm vụ thành công là . Giá giảm, chất lượng tăng và chi phí mỗi nhiệm vụ thành công tăng đều có thể xảy ra cùng lúc. Với một agent có ngữ cảnh, ta có thể cộng từng lần thử dọc theo quỹ đạo thực tế và dùng số nhiệm vụ vượt qua kiểm tra làm mẫu số.
Bài tập 3-3 [Mở rộng]: Tỷ lệ thành công cao hơn có thể bù đắp chi phí mỗi lần thử tăng lên không
Phương pháp cũ tốn 1 đơn vị mỗi lần thử với tỷ lệ thành công 50%; phương pháp mới tốn 2 đơn vị mỗi lần thử với tỷ lệ thành công 80%. Hãy tính chi phí trung bình cho mỗi nhiệm vụ thành công đã hoàn thành và xác định phương pháp mới có tiết kiệm hơn không. Nếu chi phí của phương pháp mới giảm xuống 1,5 đơn vị, nó phải đạt tỷ lệ thành công bao nhiêu để chi phí trung bình mỗi nhiệm vụ thành công không cao hơn phương pháp cũ? Với các nhiệm vụ cần nhiều mẫu, hãy giải thích chi phí của sinh, xác minh và các lần thử thất bại nên được đưa vào tổng chi phí như thế nào.
Tiếp tục ví dụ quyết định chuyển giao ở cuối Mục 3.2.4: model quyết định tốn 0,000081 đô la mỗi yêu cầu, và chuyển một yêu cầu cho LLM tốn 0,013880 đô la. Gọi tỷ lệ thành công trước và sau khi chuyển giao là . Hãy tính chi phí trung bình mỗi yêu cầu cho các tỷ lệ chuyển giao 1% và 5%; tối thiểu phải là bao nhiêu để chuyển giao làm giảm chi phí mỗi nhiệm vụ thành công?
3.2.3 Khối lượng công việc Agent
Phản hồi cũng có thể thay đổi quá trình tính toán tiếp theo. Một agent mã nguồn trước tiên sinh một kế hoạch sửa đổi, một công cụ viết mã và chạy kiểm thử, rồi model đọc kết quả kiểm thử để quyết định bước tiếp theo. Mỗi vòng lặp liên quan cả tính toán model lẫn thực thi công cụ; các log công cụ trả về trở thành đầu vào của vòng tiếp theo. Do đó, giảm log không liên quan sẽ giảm tính toán prefill và diện tích trạng thái ngữ cảnh của vòng tiếp theo, còn giảm các sửa đổi không hiệu quả trực tiếp giảm số vòng lặp.
Nhiệm vụ được đo trong chương này là sửa một hàm gộp khoảng (interval-merging), kiểm tra kết quả trả về có đúng không và đầu vào có được giữ nguyên không. Model chịu trách nhiệm quyết định sửa đổi và gọi công cụ; công cụ chịu trách nhiệm ghi tệp và chạy kiểm thử. Dưới đây, dùng quỹ đạo đã hoàn thành thành công các kiểm tra quy định ban đầu trong bốn vòng, chúng tôi lập bảng riêng thời gian model, thời gian công cụ và trạng thái được giữ lại trong lúc chờ. Chi tiết gọi công cụ được đưa ở cuối chương trong Dấu vết nhiệm vụ Code.
Hỏi đáp tăng cường truy hồi (retrieval-augmented question answering) liên quan một quá trình tương tự: một bộ truy hồi tìm tài liệu, sau đó chuyển cho model ngôn ngữ sinh câu trả lời. Khi chất lượng câu trả lời ngang nhau, nội dung truy hồi ít hơn nghĩa là chi phí thấp hơn cho prefill tiếp theo, lưu trữ KV và đọc ngữ cảnh. Do đó, nội dung mà bộ truy hồi trả về ảnh hưởng trực tiếp đến khối lượng công việc của model. Chương 8 sẽ so sánh các sơ đồ truy hồi khác nhau trong bối cảnh nhiệm vụ cụ thể.
3.2.4 Rẽ nhánh, chờ công cụ và cư trú trạng thái
Quan hệ thứ tự ưu tiên giữa các lần gọi model và thực thi công cụ có thể được vẽ thành một đồ thị phụ thuộc. Dọc theo một đường tuần tự, thời gian các giai đoạn cộng dồn; các nhánh không phụ thuộc lẫn nhau có thể bắt đầu đồng thời, và điểm hội tụ chờ nhánh chậm hơn. Trong đồ thị phụ thuộc, đường có tổng thời gian dài nhất từ đầu đến cuối được gọi là đường găng (critical path), và nó quyết định thời điểm hoàn thành sớm nhất có thể của nhiệm vụ. Trước tiên chúng ta dùng một nhiệm vụ mã thực để quan sát model và công cụ mỗi bên mất bao nhiêu thời gian, rồi thay đổi quan hệ phụ thuộc để dự đoán tính song song tiết kiệm được bao nhiêu thời gian. Bảng dưới so sánh hai lần chạy cùng một nhiệm vụ với chế độ thinking tắt và bật; chế độ thinking quyết định model có sinh trước các token thinking mô tả trong Mục 3.1.2 hay không.
| Quan sát | Chế độ thinking tắt | Chế độ thinking bật |
|---|---|---|
| Số vòng gọi model | 12 | 4 |
| Tổng token đầu ra | 765 | 2.733 |
| Tổng thời gian gọi model thực tế | 13,156 s | 76,294 s |
| Tổng thời gian thực thi công cụ thực tế | 0,476 s | 0,078 s |
| Độ đúng giá trị trả về và kiểm tra đầu vào không đổi | 315/1013 | 1013/1013 |
| Kiểm tra bổ sung: không alias trong danh sách con trả về | 1/1013 | 710/1013 |
Với chế độ thinking tắt, tỷ lệ trúng bộ nhớ đệm khoảng 83,4%, nhưng mã vẫn chưa được sửa; với chế độ bật, thời gian model tăng, và cả hai kiểm tra quy định ban đầu — độ đúng giá trị trả về và đầu vào không đổi sau khi gọi — đều vượt qua. Kiểm tra alias bổ sung yêu cầu danh sách con trả về độc lập với đầu vào gốc; chương trình với chế độ thinking bật vượt qua 710 trong số này, còn 303 trường hợp khác vẫn dùng chung danh sách con. Hai kiểm tra này tương ứng với hai thuộc tính chương trình khác nhau, cho thấy tiêu chí hoàn thành của một nhiệm vụ phải được cụ thể hóa đến mức xác minh thực thi được.
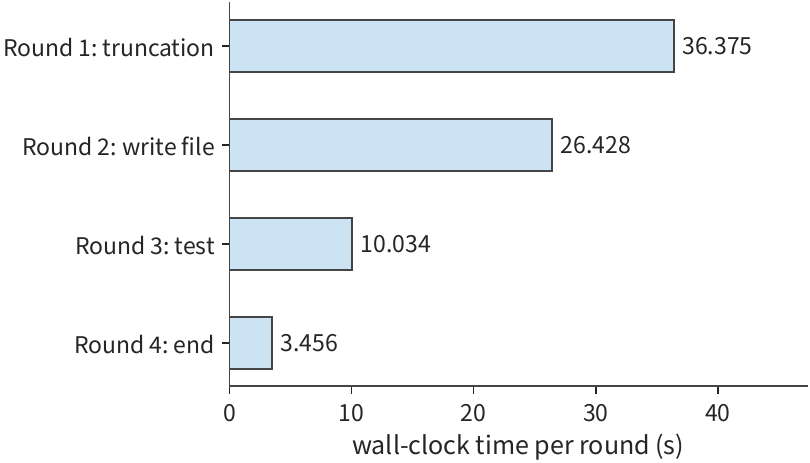
Với chế độ thinking bật, nhiệm vụ sinh tổng cộng 2.733 token đầu ra, trong đó 2.553 token đến trước marker kết thúc thinking (token đánh dấu hết nội dung suy nghĩ), 3 token là chính marker kết thúc và 177 token đến sau. Thinking chiếm phần lớn công việc sinh, còn gọi công cụ chuyển các quyết định của model thành sửa đổi tệp và thao tác kiểm thử. Tích lũy thời gian thực tế của các lần gọi model và thực thi công cụ theo thứ tự thực thi, cộng thời gian điều khiển và chuyển giao, ta được tổng thời gian người dùng chờ cho toàn bộ nhiệm vụ hoàn thành.
Ví dụ làm việc 3-2: Tăng tốc tính toán model vòng đầu có thể rút ngắn một nhiệm vụ mã bao nhiêu? Phân tích bằng định luật Amdahl ở Chương 1, giả định hành vi và chất lượng các bước sau không đổi.
Lời giải: Dùng cùng quỹ đạo thực thi làm đường cơ sở, rút ngắn tính toán model vòng đầu là 36,375 giây xuống một nửa — với mọi giai đoạn, đầu ra, hành vi công cụ và chất lượng khác không đổi — làm giảm tổng thời gian từ 76,510 giây xuống 58,323 giây. Ở đây , , cho tốc độ tăng tổng thể khoảng 1,31. Vòng đầu chiếm khoảng 47,5% tổng thời gian; giảm một nửa phần đó tiết kiệm khoảng 23,8% tổng thời gian; các giai đoạn còn lại vẫn tổng cộng khoảng 40,1 giây. Lợi ích của tối ưu hóa phụ thuộc vào phần mà phần được rút ngắn ban đầu chiếm bao nhiêu.
Các phụ thuộc giữa các công cụ cũng ảnh hưởng đến tổng thời gian. Giả sử model trước tiên tính toán trong 2 giây, rồi gọi hai công cụ lần lượt mất 6 giây và 10 giây, và cuối cùng tính thêm 3 giây. Nếu công cụ thứ hai phụ thuộc vào kết quả của công cụ thứ nhất, tổng thời gian là giây; nếu hai công cụ độc lập với nhau, tổng thời gian là giây. Tính song song tiết kiệm 6 giây, nhưng tổng công việc thực thi của hai công cụ vẫn là 16 giây.
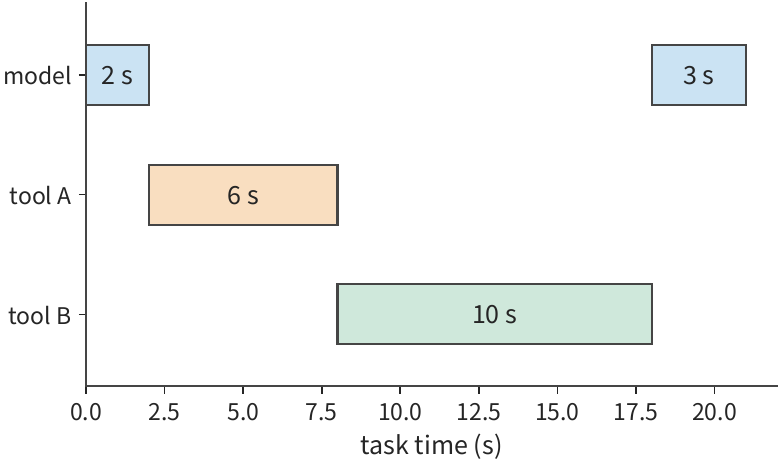
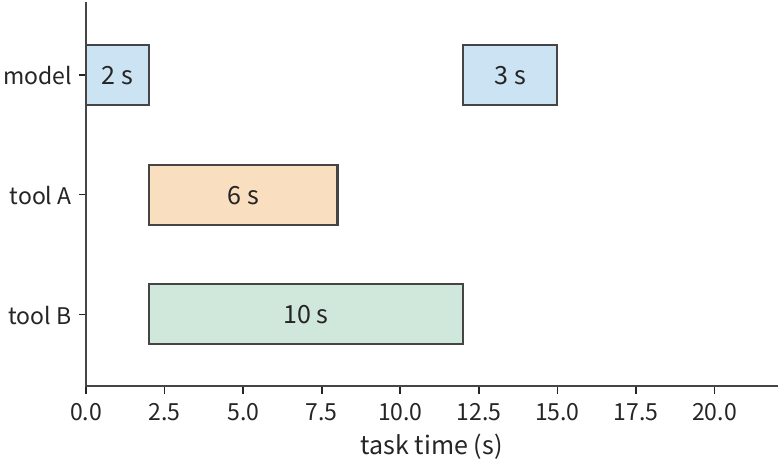
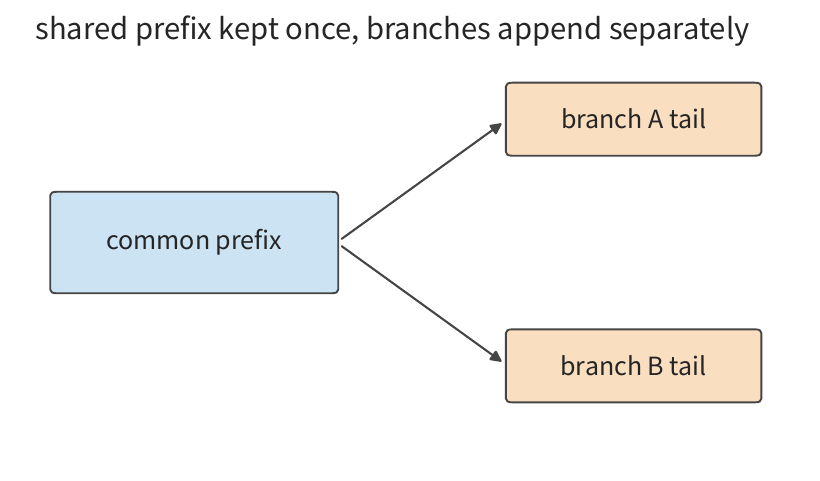
Tính song song và rẽ nhánh không chỉ thay đổi thời gian mà còn thay đổi diện tích trạng thái. Nếu các nhánh phải mỗi nhánh sinh văn bản riêng, tiền tố dùng chung có thể được chia sẻ trong khi các đuôi nhánh lớn lên độc lập. Gọi độ dài tiền tố dùng chung là , nhánh thêm token mới, và trạng thái mỗi token là ; thì tổng trạng thái là . Tính song song rút ngắn đường găng, nhưng cũng nghĩa là trạng thái của nhiều nhánh hơn chiếm bộ nhớ đồng thời.
Trong bản ghi đo của nhiệm vụ sửa mã ở Mục 3.2.3, gọi công cụ mất rất ít thời gian, và phần lớn thời gian bị tiêu vào tính toán model. Nếu thay vào đó thao tác công cụ là một lần biên dịch 10 giây, ngữ cảnh cần cho vòng tiếp theo vẫn chiếm năng lực trong khi model tạm dừng; nếu nhiều nhiệm vụ đang chờ cùng lúc, lượng giữ lại tích lũy theo từng nhiệm vụ. Công cụ thực thi càng lâu thì trạng thái được giữ càng lâu và hệ thống càng xử lý được ít yêu cầu cùng lúc. Các Chương 8 và 9 sẽ sắp xếp caching và chuyển giao dọc theo dòng thời gian này.
Bài tập 3-4 [Cốt lõi]: Tính song song của công cụ và tăng tốc cục bộ tiết kiệm được bao nhiêu thời gian nhiệm vụ
Một nhiệm vụ trước tiên cho model tính toán 2 giây, sau đó gọi hai công cụ độc lập lần lượt mất 6 giây và 10 giây. Sau khi cả hai công cụ hoàn thành, model tính thêm 3 giây và nhiệm vụ kết thúc. Hãy tính tổng thời gian nhiệm vụ cho trường hợp hai công cụ thực thi tuần tự và trường hợp chúng thực thi đồng thời. Giả sử trạng thái chiếm 1 GiB chỉ trong lúc chờ công cụ trả về, hãy tìm tích của mức chiếm dụng trạng thái và thời lượng chiếm dụng cho cả hai chế độ thực thi, tính bằng GiB·s.
Bản ghi đo của nhiệm vụ mã trong mục này cho thấy tổng thời gian nhiệm vụ là 76,510 giây, trong đó tính toán model vòng đầu mất 36,375 giây và mọi thực thi công cụ cộng lại mất 0,078 giây. Giữ các giai đoạn khác không đổi, hãy tính mỗi tối ưu hóa sau tiết kiệm được bao nhiêu thời gian nhiệm vụ: tăng tốc độ tính toán model vòng đầu lên gấp bốn lần ban đầu; tăng tốc độ thực thi của mọi công cụ lên gấp hai lần ban đầu. Dựa trên kết quả, hãy giải thích vì sao riêng hệ số tăng tốc cục bộ không thể quyết định lợi ích của một tối ưu hóa đối với nhiệm vụ hoàn chỉnh.
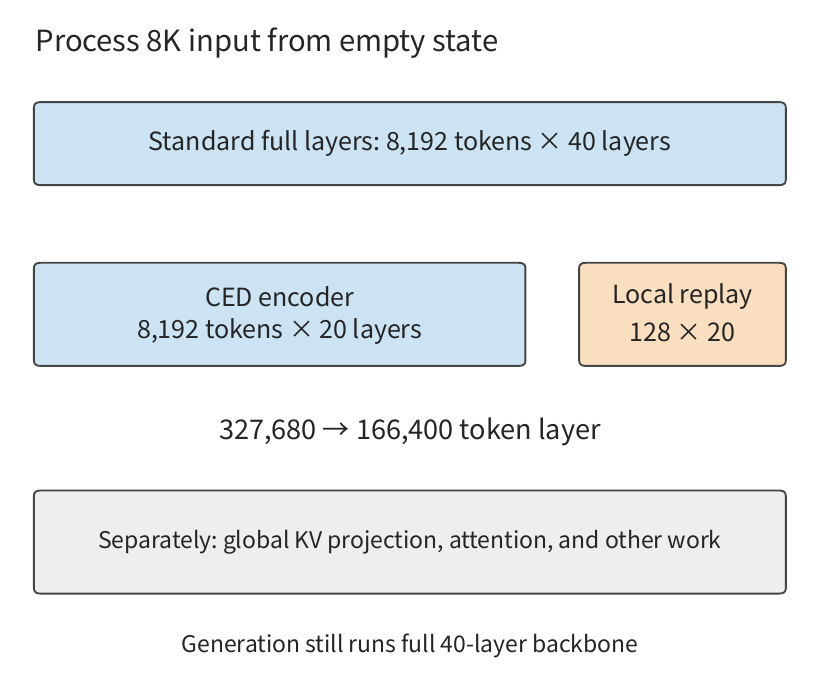
Nhu cầu khối lượng công việc cũng có thể thúc đẩy thay đổi kiến trúc model. Chuyển cùng một hội thoại sang DeepSeek V4.1 Flash cung cấp một ví dụ cụ thể. Giả sử một agent đã có một đoạn ngữ cảnh chung, và một công cụ sau đó trả về tài liệu mới; nếu tiền tố không trúng đệm, dịch vụ phải xử lý lại một lượng đầu vào tương đối lớn, trong khi đầu ra của vòng này có thể ngắn. Việc giảm chi phí prefill cho các kịch bản nặng đầu vào như vậy có giá trị hơn việc chỉ tối ưu hóa sinh đơn bước. V4.1 do đó áp dụng cấu trúc CED đã giới thiệu ở Chương 2, dùng 20 lớp encoder nhân quả và 20 lớp decoder: phần lớn đầu vào chỉ đi qua thân encoder, và KV toàn cục của decoder được lấy bằng cách chiếu từ biểu diễn lớp cuối của encoder; để dựng trạng thái SWA của decoder, đầu ra encoder của nhiều nhất 128 token cuối của prompt được đưa ngược lại vào decoder, xấp xỉ khôi phục phần trạng thái cục bộ này. Các token đầu ra tiếp tục đi qua cả 40 lớp.
Trước tiên chúng ta so sánh khối lượng công việc của tính toán ma trận chuyên gia, đo công việc bằng tổng trên các token của số lớp chuyên gia mà mỗi token đi qua. Gọi đầu vào từ trạng thái rỗng là token; đường 40 lớp thông thường khi đó là , còn lịch trình CED mô tả trong báo cáo là . Khi , hai giá trị lần lượt là 327.680 và 166.400, giá trị sau bằng khoảng 50,8% giá trị trước; khi , số hạng phụ này không cho thấy sự giảm.
Với một tiền tố đã có, khối lượng công việc xử lý đầu vào được quyết định chung bởi độ dài phần thêm vào và phương pháp khôi phục. Nếu SWA của encoder trúng bộ nhớ đệm, thân encoder có thể tiếp tục xử lý đầu vào được thêm; nếu SWA của encoder trượt, cửa sổ đuôi của tiền tố phải được phát lại trước. Cả hai đường sau đó phải dựng SWA decoder của vòng này. Chương 8 sẽ dùng các ví dụ dạy học với ngữ cảnh 8K và 128K để so sánh chi phí lưu trạng thái so với thực thi lại.
Ví dụ: vì sao Jev trả lời trong nháy mắt. Vào tháng 9 năm 2026, TypeSafe AI, do cựu nghiên cứu viên OpenAI Diogo Almeida thành lập, phát hành model Jev. Theo bài đăng ra mắt của nhà sáng lập, tại OpenAI ông đã giúp xây dựng các phương pháp dạy model ngôn ngữ tuân theo chỉ dẫn và duy trì hội thoại, công việc trở thành nền tảng nghiên cứu đằng sau ChatGPT. Bản demo chính thức của Jev gây ấn tượng: với cùng một yêu cầu dịch vụ khách hàng, GPT-5.6 Terra mất 8,566 giây còn Jev mất 0,114 giây, với chi phí bằng 1/171. Phản ứng đầu tiên của nhiều người là: đây có còn là Transformer không? Họ đã xây dựng hạ tầng đáng kinh ngạc nào chăng? Bất kỳ ai đọc cuốn sách này sẽ thấy không có bí mật thực sự nào ở đây, và độc giả có thể dễ dàng tự xây dựng nó.
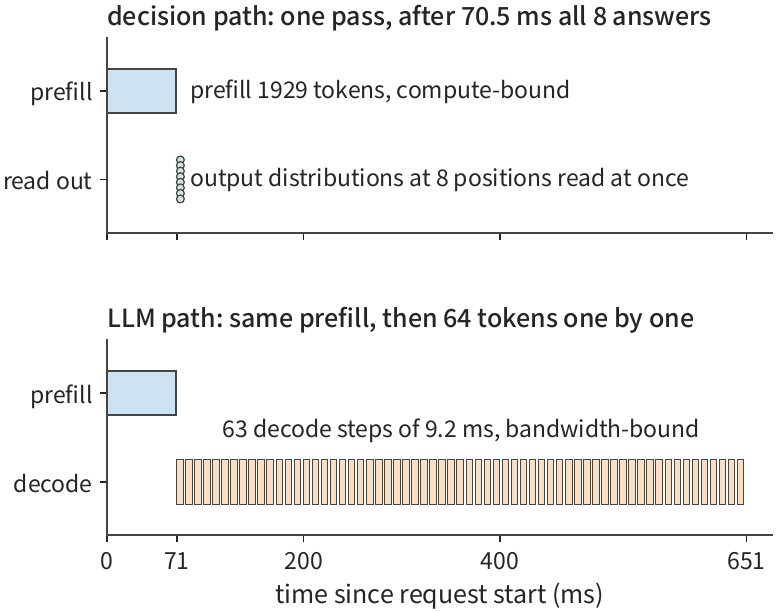
Jev không sinh văn bản. Người gọi gửi một phần trạng thái (chẳng hạn một phiếu hỗ trợ) và vài câu hỏi, mỗi câu hỏi có các lựa chọn được xác định trước, và model trả về xác suất cho từng lựa chọn. Quay lại chuỗi lần gọi ở Mục 3.1.1, một yêu cầu như vậy có một lần prefill và không có decode. Trạng thái và tất cả các câu hỏi được ghép thành một lượt forward, và phân bố đầu ra tại vị trí cuối của mỗi câu hỏi chính là câu trả lời của câu hỏi đó, giống như các nhánh trong Hình 3-13 tách ra từ một tiền tố, ngoại trừ mỗi nhánh dừng sau một bước. Các câu hỏi không phụ thuộc lẫn nhau, và không cần giữ KV nào sau khi yêu cầu kết thúc. Liệu các xác suất này có thể dùng trực tiếp làm độ tin cậy hay không phụ thuộc vào training: TypeSafe gọi phương pháp của họ là RLCD, theo cùng ý tưởng với RLCR trong tài liệu nghiên cứu, thêm điểm Brier vào phần thưởng để các xác suất model báo cáo khớp với tần suất nó thực sự đúng.
Các đầu vào của chính cuốn sách đủ để kiểm tra điều này. Jev chỉ tính phí đầu vào, 0,042 đô la mỗi triệu token; yêu cầu demo tốn 0,000081 đô la, tương đương khoảng 1.929 token đầu vào. Trên Qwen3-8B, yêu cầu này là một lượt forward khoảng 28 TFLOPs, mất khoảng 70 ms trên H100 SXM với hiệu suất tính toán 40%, phù hợp với 0,114 giây trong demo. Trên DeepSeek V4.1 Flash dọc theo đường CED, công việc chỉ tăng thêm khoảng một phần tư. Một LLM thông thường, sau prefill, vẫn phải sinh token từng cái một, mỗi bước bị giới hạn bởi băng thông bộ nhớ và mất khoảng 9 ms. Sinh 64 token đẩy độ trễ lên 0,65 giây, gấp 9 lần yêu cầu quyết định; vì decode có thể được gom lô, thời gian GPU chỉ tăng 28%. Hình 3-15 đặt hai cách thực thi trên cùng một dòng thời gian: câu trả lời tức thì đến từ việc bỏ qua sinh tuần tự.
Định giá cũng không phải bí ẩn. Lấy con số 2 đô la mỗi GPU-giờ từ báo cáo hệ thống inference của DeepSeek, một model dense 8B hoặc V4.1 Flash tiêu khoảng 0,02 đến 0,025 đô la tính toán cho mỗi triệu token đầu vào, và giá của Jev cao gấp 1,7 đến 2 lần con số đó. Nói cách khác, một model thuộc lớp này đạt được mức giá này chỉ với một prefill thông thường; ngược lại, nếu giá phải bù chi phí, công việc mỗi token của Jev khó có thể vượt quá khoảng hai lần một model dense 8B. Trong khoảng chênh 171 lần chi phí ở demo, chỉ một phần nhỏ đến từ việc bỏ sinh: trên cùng model, bỏ 64 đến 512 token đầu ra chỉ làm giảm thời gian GPU xuống còn 1/1,3 đến 1/3,4 so với ban đầu. Phần còn lại đến từ giá của chính model tiên tiến và vô số token nó sinh trong lúc suy luận.
Trong thực tế, các yêu cầu mà model quyết định không chắc chắn vẫn phải được chuyển cho một LLM. Gọi tỷ lệ chuyển giao là ; chi phí trung bình mỗi yêu cầu khi đó là . Với hai chi phí từ demo, một khi vượt khoảng 0,58%, chi phí chuyển giao lớn hơn chi phí của chính model quyết định. Do đó, trong chi phí nhiệm vụ thành công ở Mục 3.2.2 phải bao gồm chi phí chuyển giao. Việc một model quyết định có tiết kiệm tiền hay không phụ thuộc vào có bao nhiêu yêu cầu phải chuyển giao và LLM nhận có đắt đến đâu.
3.3 Tương tác đa phương thức và thời gian thực
Kết quả công cụ của một agent thường vào đầu vào vòng tiếp theo dưới dạng văn bản. Nếu đầu vào trở thành hình ảnh hoặc lời nói liên tục, đầu vào phải được mã hóa trước khi gọi model, và phía đầu ra cũng có thể cần phát liên tục. Mục này trước tiên phân tích hình dạng dữ liệu thay đổi thế nào giữa các giai đoạn, sau đó phân tích mỗi giai đoạn phải hoàn thành khi nào.
3.3.1 Mã hóa thị giác, sinh ngôn ngữ và trạng thái
Trước khi một hình ảnh vào model ngôn ngữ, nó phải trải qua tiền xử lý, mã hóa thị giác và phép chiếu. Gọi là mã hóa thị giác, là prefill ngôn ngữ và là decode tiếp theo; một nhiệm vụ hỏi đáp thị giác đơn lẻ do đó tuân theo phụ thuộc cơ bản . Kích thước hình ảnh ảnh hưởng đến khối lượng công việc của , còn số token thị giác được mã hóa ảnh hưởng đến khối lượng công việc của phần ngôn ngữ; hai khối lượng công việc này nên được tính riêng.
Trước tiên đếm số token thị giác, sau đó đếm chiều đặc trưng của mỗi vector. Gọi chiều cao và chiều rộng của ảnh đã tiền xử lý là ; chia ảnh thành các khối vuông (patch) mỗi khối có cạnh dài , và gộp thêm khối mỗi cạnh, số token thị giác là
Lấy một cấu hình cụ thể làm ví dụ. Với model thị giác-ngôn ngữ Qwen3-VL-4B, một ảnh , chia thành các patch , cho 1.600 patch, sau khi gộp thêm cho 400 token thị giác. Độ rộng đặc trưng cuối là 2.560, và tensor BF16 , với hai byte mỗi phần tử, chiếm byte.
Nhưng kết quả mã hóa không chỉ là một tensor này. Để cung cấp cho model ngôn ngữ thông tin thị giác ở các độ sâu khác nhau, DeepStack đưa các đặc trưng từ các lớp giữa của bộ mã hóa thị giác vào các lớp ngôn ngữ tương ứng. Model cũng lấy các đặc trưng như vậy từ ba lớp thị giác giữa và ghép chúng với các đặc trưng lớp cuối, cho một tensor hoàn chỉnh , chiếm 8.192.000 byte, tức 7,8125 MiB. Bốn bộ đặc trưng tương ứng với cùng một bộ 400 token thị giác: độ rộng đặc trưng lớn gấp bốn lần, trong khi chuỗi ngôn ngữ vẫn chỉ thêm 400 token thị giác. Tính toán ma trận cho mã hóa thị giác khoảng 1,310 TFLOPs; giải mã và điều chỉnh kích thước ảnh xảy ra trước khi mã hóa, còn tính toán ngôn ngữ xảy ra sau khi mã hóa.
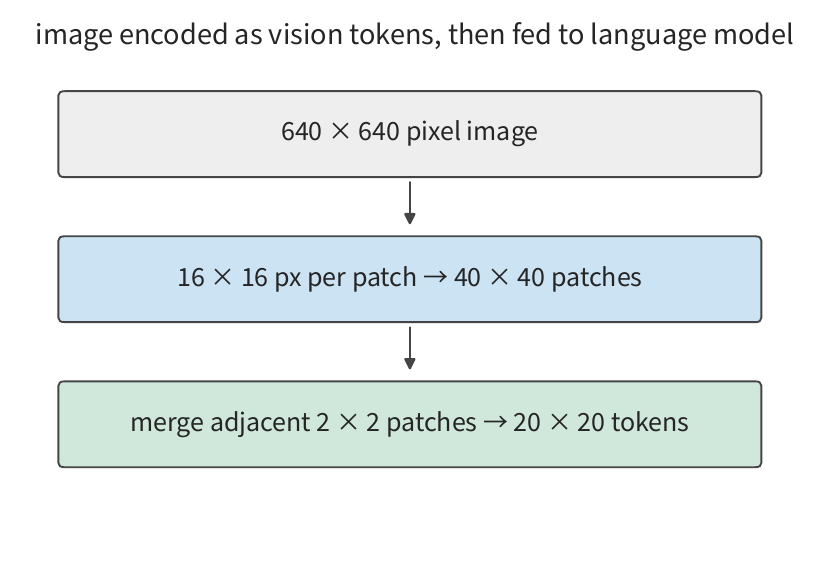
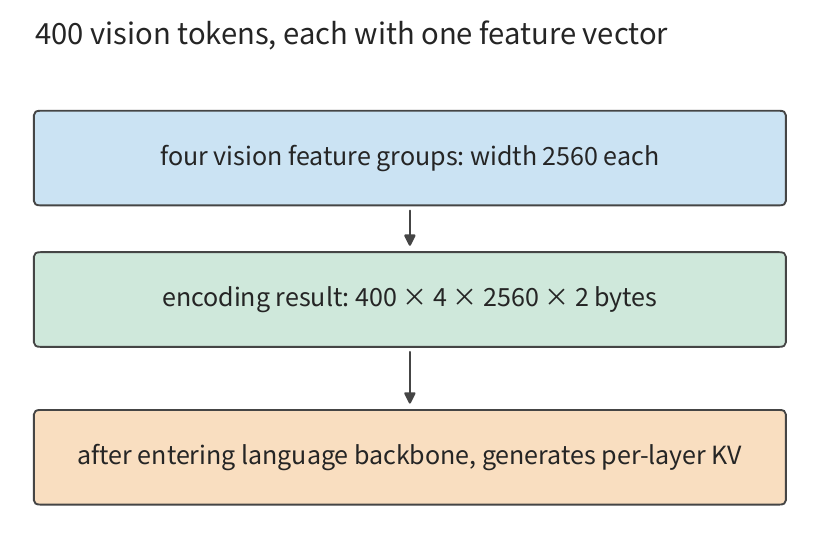
Trong Hình 3-15 và 3-16, mã hóa thị giác thay đổi số token thị giác và độ rộng đặc trưng; sau khi vào model ngôn ngữ, một loại biểu diễn khác được tạo ra. Bộ nhớ đệm encoder (EC) giữ đầu ra của bộ mã hóa thị giác, còn backbone ngôn ngữ tạo ra KV cache. Trong cấu hình này, KV ngôn ngữ chiếm 144 KiB mỗi token, nên 400 token thị giác tương ứng với 56,25 MiB. Như vậy, cùng một ảnh chụp dạy học tương ứng với các khối lượng dữ liệu khác nhau ở ba giai đoạn xử lý: tệp nén gốc 0,8 MB, EC BF16 hoàn chỉnh 7,8125 MiB và KV logic của các token thị giác 56,25 MiB.
| Đối tượng | Kích thước trong ví dụ này | Điều kiện quyết định khả năng tái sử dụng |
|---|---|---|
| Ảnh chụp nén | 0,8 MB, đầu vào cho trước | Cùng nội dung tệp |
| Kết quả mã hóa hoàn chỉnh EC | 7,8125 MiB | Ảnh, tiền xử lý, bộ mã hóa và định dạng đầu ra đều phải khớp |
| KV ngôn ngữ của token thị giác | 56,25 MiB | Còn phụ thuộc vào ngữ cảnh trước đó, thứ tự, vị trí và trạng thái model |
Khi ảnh và cấu hình mã hóa giống nhau, EC có thể được tái sử dụng. KV ngôn ngữ còn phụ thuộc vào ngữ cảnh trước ảnh: nếu câu hỏi được đặt trước ảnh, thay đổi câu hỏi sẽ thay đổi KV của các token thị giác; nếu câu hỏi được đặt sau ảnh, attention nhân quả giữ KV của các token thị giác trước đó không đổi.
Trạng thái mã hóa và ngân sách năng lực KV cho đầu vào đa phương thức. Giả sử đầu vào chứa bốn ảnh và 400 token văn bản; hãy tính EC và KV logic cho các token đầu vào này. EC cho bốn ảnh cùng quy cách là 31,25 MiB, và KV token thị giác là 225 MiB; cộng thêm 400 token văn bản, KV logic của đầu vào là 281,25 MiB.
Ảnh gốc, EC và KV — ba biểu diễn dữ liệu này — tương ứng với ba điểm chuyển giao khác nhau. Gửi ảnh gốc nghĩa là bên nhận vẫn phải thực hiện mã hóa thị giác; gửi EC nghĩa là bên nhận bắt đầu từ prefill ngôn ngữ; gửi KV nghĩa là chuyển giao ngữ cảnh ngôn ngữ đã hoàn tất. Chương 8 sắp xếp thực thi trên cùng một card, Chương 9 so sánh các chuyển giao giai đoạn, và Chương 12 đặt chính dòng dữ liệu này lên các liên kết edge, edge-server và cloud.
Giữ nguyên kích thước patch và sơ đồ gộp, nhân đôi cả chiều cao và chiều rộng của ảnh làm số token thị giác lớn gấp bốn lần. Do đó, cả EC lẫn KV ngôn ngữ của các token thị giác đều lớn gấp bốn lần; các tương tác giữa các token bên trong mã hóa thị giác vẫn phải được tính theo cấu trúc attention. Ghép nối đặc trưng làm tăng độ rộng, còn phóng to ảnh làm tăng số token thị giác; hai điều này tạo ra các hệ quả khác nhau bên trong backbone ngôn ngữ.
3.3.2 Quá trình tính toán cho sinh âm thanh và hình ảnh
Hỏi đáp thị giác vẫn sinh văn bản token từng cái qua model ngôn ngữ. Nếu đầu ra chính là âm thanh hoặc hình ảnh, dữ liệu được xử lý mỗi lần lặp và số lần lặp cũng thay đổi.
Đầu ra âm thanh cũng liên quan một vòng lặp trong mỗi khung (frame). Lấy model sinh giọng nói S2 Pro của Fish Audio làm ví dụ: đường chậm tiến từng khung âm thanh một, còn đường nhanh điền mã cho nhiều codebook trong một khung. Codebook là một tập vector ứng viên cho biểu diễn âm thanh rời rạc; một codec chuyển các chỉ số mã này trở lại dạng sóng. Mỗi khung trước tiên dùng một lượt forward đường nhanh để thiết lập trạng thái, sau đó dùng chín dự đoán nữa để điền các codebook, nên sinh một khung cần tổng cộng mười lần tính toán forward đường nhanh. Theo đó, token ngôn ngữ/s, khung âm thanh/s và số giây âm thanh sinh ra mỗi giây là các thước đo tốc độ sinh khác nhau.
Sinh hình ảnh liên quan một loại vòng lặp khác. Latent là một biểu diễn hình ảnh nén, liên tục; khử nhiễu (denoising) dần dần chuyển một biểu diễn nhiễu thành ảnh đích. Một Diffusion Transformer (DiT) thực thi phép biến đổi ở mỗi bước, hướng dẫn không phân loại (classifier-free guidance, CFG) kết hợp các dự đoán có điều kiện và không điều kiện, và một autoencoder biến phân (variational autoencoder, VAE) xử lý chuyển đổi giữa pixel và biểu diễn nén. Lấy model sinh ảnh Qwen-Image-2512 làm ví dụ: một ảnh tạo thành 4.096 vị trí latent, thực thi 50 bước khử nhiễu, và với đường true-CFG có hai lượt forward DiT mỗi bước, tổng cộng 100 lần tính toán forward DiT được thực thi. Tính toán ma trận khử nhiễu khoảng FLOPs; bộ mã hóa văn bản và VAE mỗi bên có công việc riêng. Tập các vị trí latent được giữ cố định suốt quá trình khử nhiễu, trong khi nội dung của chúng được cập nhật lặp lại ở mỗi bước, nên công việc tích lũy tăng theo số bước khử nhiễu.
Gọi tính toán mỗi bước khử nhiễu là , số bước khử nhiễu là và số nhánh hướng dẫn mỗi bước là ; tổng tính toán là . Nhân đôi số bước làm nhân đôi tính toán; tăng độ phân giải làm tăng số vị trí không gian trong biểu diễn latent của ảnh, từ đó tăng cả số hàng ma trận trong một bước lẫn các tương tác giữa các vị trí. Sinh văn bản liên tục thêm vào ngữ cảnh, nên lượng truy cập mỗi bước không ngừng tăng; khử nhiễu ảnh cập nhật lặp lại cùng một tập latent, nên ở độ phân giải cố định, tính toán tích lũy tăng tuyến tính theo số bước khử nhiễu.
3.3.3 Nhận thức liên tục, phản hồi phần đầu và gián đoạn
Tổng khối lượng công việc quyết định nhu cầu xử lý trung bình, nhưng phát thời gian thực còn yêu cầu mọi khối dữ liệu đến đúng giờ. Gọi là thời lượng âm thanh phát được đã đến tại thời điểm , và là thời lượng âm thanh đã phát; âm thanh còn lại trong bộ đệm là
Trong lúc phát liên tục, mỗi giây trôi qua, thời lượng đã phát tăng thêm một giây, còn tăng theo bước nhảy khi các khối dữ liệu đến. Khoảng cách giữa hai đường cong là biên bộ đệm; nếu biên này về không trước khi khối tiếp theo đến, âm thanh sẽ bị ngắt. Phát trước (pre-buffering) làm tăng biên ban đầu đồng thời trì hoãn việc bắt đầu phát.
Các yêu cầu về thời gian tác động lên cả đầu vào lẫn đầu ra. Ở phía đầu vào, nếu một agent chụp màn hình chỉ quan sát màn hình sau khi một hành động hoàn tất, nó có thể bỏ lỡ một cửa sổ bật lên xuất hiện rồi biến mất giữa hành động. Nghiên cứu quan sát và tương tác liên tục như AOI nhắm đúng loại kịch bản này: nó tách quan sát màn hình khỏi thực thi hành động, liên tục thu thập hình ảnh, âm thanh và sự kiện, rồi lọc các bản ghi để đưa vào model. Tăng tần suất quan sát có thể bắt được nhiều sự kiện ngắn hơn, nhưng giữ nhiều keyframe hơn cũng tiêu tốn ngữ cảnh; quá nhiều keyframe cũng có thể lấn át thông tin quan trọng, làm giảm hiệu quả nhiệm vụ. Do đó, quan sát liên tục phải đi kèm lọc lựa để quyết định nội dung nào đáng giữ và chuyển cho model.
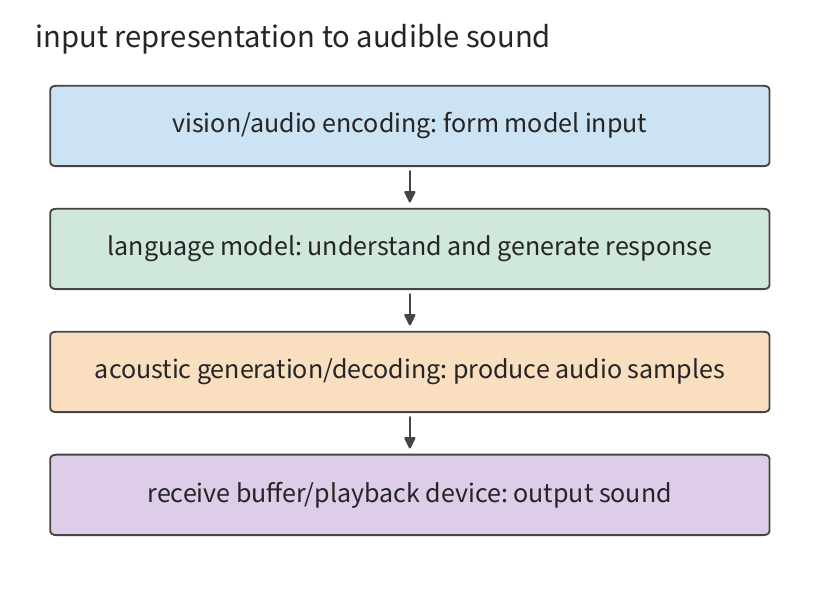
Lời nói có các ràng buộc thời gian trực tiếp hơn. Sau khi người dùng ngừng nói, hệ thống phải thu hoặc xác nhận đầu vào, rồi trải qua nhận dạng/mã hóa, inference, sinh giọng nói và phát lại. Khi phát đã bắt đầu, âm thanh tiếp theo vẫn phải đến đúng giờ để tránh gián đoạn.
Sau khi một khối âm thanh tới ứng dụng, nó vẫn trải qua giải mã, xếp hàng và phát. Trong hai tương tác giọng nói được đo, thời gian từ khi người dùng ngừng nói đến khi khối âm thanh đầu tiên đến lần lượt khoảng 400 ms và 370 ms, và khoảng thời gian đến trung vị giữa các khối âm thanh tiếp theo khoảng 94 ms trong cả hai trường hợp. Thời gian đến cho biết dữ liệu trở nên sẵn sàng khi nào, còn đồng hồ phát quyết định âm thanh thực sự được phát ra khi nào.
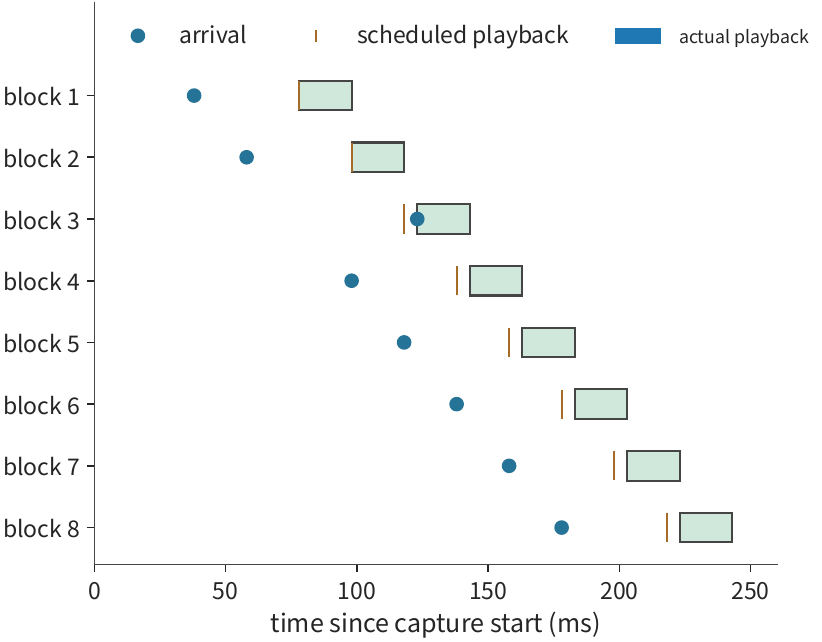
Dùng bộ thông số sau để dựng một dòng thời gian cho thấy việc đệm giữa hai quá trình tránh ngắt âm như thế nào. Đầu vào tạo một khối mỗi 20 ms, ở 24 kHz, mono, 2 byte mỗi mẫu, nên dung lượng dữ liệu mỗi khối là:
Sau khi mỗi khối hoàn tất thu thập, xử lý model mất 12 ms, gửi mất 1 ms và truyền qua mạng thường mất thêm 5 ms. Khối đầu tiên đến ở mốc 38 ms, chờ 40 ms trong bộ đệm chống rung (jitter buffer — bộ đệm tạm giữ âm thanh đã đến để hấp thụ dao động thời gian đến), và được phát ở mili-giây thứ 78 tính từ khi bắt đầu thu. Độ trễ truyền của khối thứ ba được đặt là 50 ms, nên nó đến muộn ở mốc 123 ms, bỏ lỡ thời điểm phát dự kiến 118 ms và gây ra 5 ms gián đoạn thêm. Các khối sau, dù đã đến, vẫn phải chờ đến lượt theo thứ tự âm thanh.
Đổi bộ đệm thành 60 ms loại bỏ gián đoạn này, nhưng trì hoãn lần phát đầu tiên đến 98 ms. Tăng bộ đệm có thể hấp thụ dao động thời gian đến cụ thể này và tránh gián đoạn phát, với cái giá là bắt đầu muộn hơn; nếu tốc độ đến trung bình của âm thanh thấp hơn bền vững so với tốc độ phát, một bộ đệm hữu hạn cuối cùng sẽ cạn.
Ngoài tính liên tục của phát, phản hồi gián đoạn phải được kiểm tra riêng. Hình 3-20 tính thời gian từ khi người dùng phát lệnh gián đoạn, theo dõi thời điểm phát cục bộ thực sự dừng; việc sinh ở phía xa có dừng hay không phải được đánh giá theo một đường điều khiển riêng.
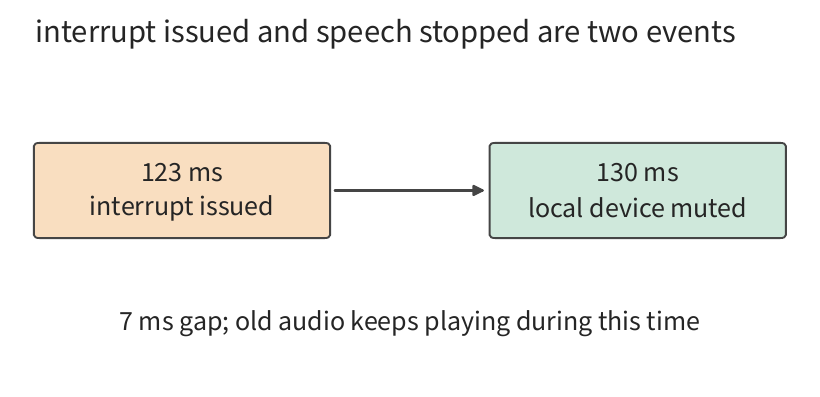
Gián đoạn liên quan nhiều thao tác: ứng dụng phát lệnh hủy, thiết bị phát tắt tiếng, backend dừng sinh, và các bộ đệm cùng trạng thái được giải phóng. Trong dòng thời gian dạy học, lệnh gián đoạn được phát ra ở mốc 123 ms, độ trễ điều khiển là 5 ms, và thiết bị kiểm tra cũng như thực thi lệnh điều khiển mỗi 10 ms, nên nó tắt tiếng ở mốc 130 ms, cho người dùng cảm nhận độ trễ gián đoạn là 7 ms. Tắt tiếng thiết bị, backend dừng sinh và giải phóng bộ đệm cùng trạng thái lần lượt tương ứng với các mốc phát dừng, tính toán dừng và lưu trữ được giải phóng: thời điểm backend dừng sinh quyết định tính toán tiếp theo kết thúc khi nào, còn giải phóng bộ đệm quyết định khi nào năng lực trở nên sẵn sàng cho các nhiệm vụ khác.
Không phải nhiệm vụ nào cũng cần đầu ra liên tục. RAW là một biểu diễn hình ảnh giữ lại thông tin lấy mẫu gốc của cảm biến máy ảnh. Tăng cường ảnh RAW quan tâm đến khi nào có thể thu được một ảnh hoàn chỉnh, và không cần đầu ra liên tục kiểu lời nói. Tăng cường cũng cần giữ lại thông tin ảnh gốc; EC dùng cho hiểu thị giác không thể thay thế ảnh gốc. Điều này cho thấy các nhiệm vụ khác nhau có các yêu cầu thời gian khác nhau: một số cần bắt đầu càng sớm càng tốt, một số cần duy trì trơn tru liên tục, và một số cần được hoàn thành trọn vẹn càng sớm càng tốt.
Bài tập 3-5 [Mở rộng]: Độ phân giải hình ảnh và bộ đệm âm thanh ảnh hưởng đến yêu cầu tài nguyên như thế nào
Đổi độ phân giải của ảnh đầu vào Qwen3-VL-4B từ thành , giữ nguyên kích thước patch, sơ đồ gộp và độ chính xác đặc trưng, và tìm số token thị giác, kích thước của bộ nhớ đệm encoder EC hoàn chỉnh và kích thước KV tương ứng với các token thị giác này. Sau đó, dùng dòng thời gian âm thanh của mục này, so sánh thời điểm phát đầu tiên và hành vi gián đoạn cho các bộ đệm ban đầu 40 ms và 60 ms. Nếu chỉ có 0,9 giây âm thanh có thể phát mỗi giây nhận được và 0,3 giây âm thanh đã được đệm sẵn khi bắt đầu phát, hãy tìm việc phát liên tục có thể kéo dài bao lâu trước khi bộ đệm cạn, và giải thích việc tăng một bộ đệm hữu hạn có thể giải quyết vấn đề gì.
3.4 Yêu cầu tính toán và trạng thái của Training
3.4.1 Tính toán forward, lan truyền ngược và cập nhật tham số
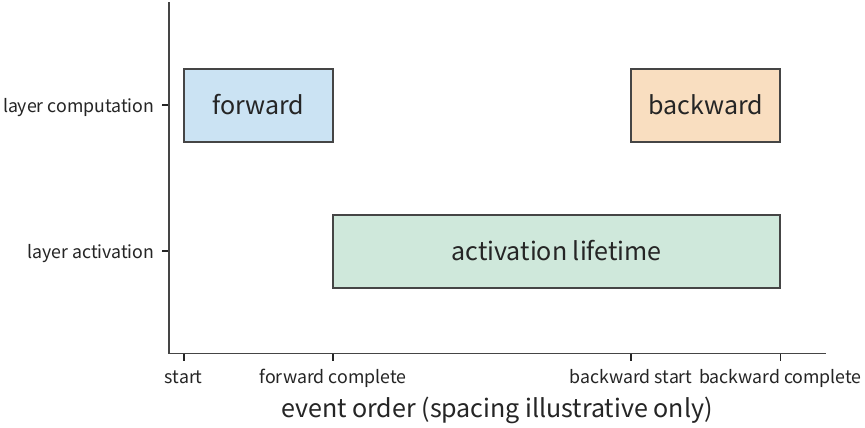
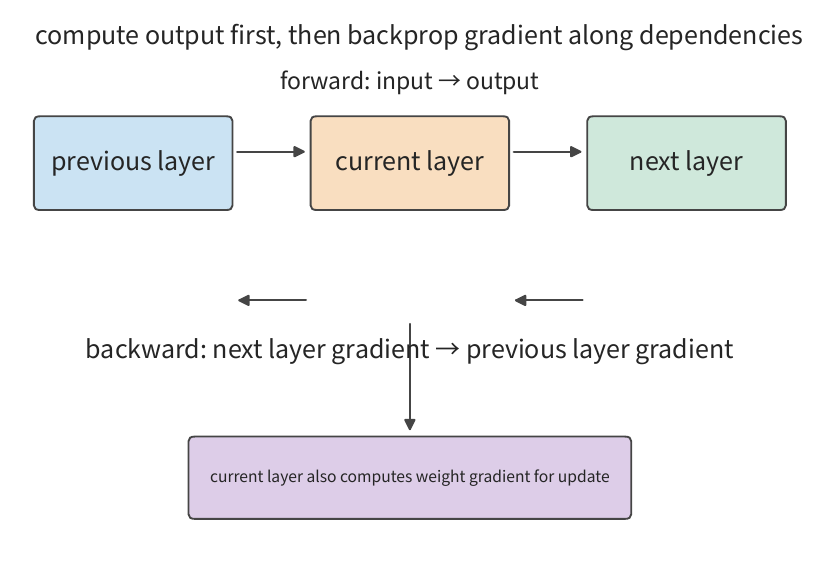
Inference dùng trọng số để tính đầu ra; training cũng dùng chênh lệch giữa đầu ra và đích để điều chỉnh trọng số. Lấy trường hợp đơn giản nhất, một phép nhân đơn lẻ: đầu vào x nhân với trọng số w cho y. Khi lớp tiếp theo truyền ngược lại độ nhạy của loss với y, việc tính độ nhạy của loss với w vẫn cần x từ bước đó; truyền độ nhạy lại bước trước cần w. Vì vậy sau khi lượt forward trao kết quả cho lớp tiếp theo, một số đầu vào vẫn phải được giữ lại cho đến khi lượt backward đã dùng chúng, tại thời điểm đó chúng có thể được giải phóng.
Với một lớp tuyến tính , đầu vào có hình dạng và trọng số có hình dạng . Loss là thước đo số thể hiện độ xa của đầu ra model so với đích training; mục tiêu của training là giảm loss. Gradient mô tả độ nhạy của loss với một thay đổi nhỏ trong một đầu vào hay tham số nào đó. Lan truyền ngược (backpropagation) mang các độ nhạy này ngược dọc theo chuỗi phụ thuộc từ đầu ra. Với giả định lớp tiếp theo truyền về , lớp hiện tại phải tính hai gradient:
Lượt forward tính đầu ra; lượt backward tính gradient đầu vào và gradient trọng số riêng biệt. Ba phép nhân ma trận liên quan cùng một lượng công việc, nên FLOPs ma trận của training lớp tuyến tính này bằng khoảng ba lần lượt forward. Bảng dưới tính một phép nhân-cộng là hai FLOPs.
| Thao tác | Vấn đề nó giải quyết | Hình dạng của hai đầu vào trái và phải | Hình dạng đầu ra | FLOPs ma trận |
|---|---|---|---|---|
| Forward | Tính đầu ra từ đầu vào | và | ||
| Gradient đầu vào | Truyền lỗi về lớp trước | và | ||
| Gradient trọng số | Tìm hướng điều chỉnh cho trọng số lớp này | và |
Gradient đầu vào truyền tín hiệu lỗi cho lớp trước; gradient trọng số quyết định điều chỉnh tham số của lớp này. Nhìn vào ba bộ chiều ma trận, dù thứ tự nhân khác nhau, cả ba thao tác liên quan cùng phép nhân-cộng, nên cùng nhau tổng cộng khoảng FLOPs. Nếu mỗi token training đi qua cùng một bộ ma trận tham số chính, tích lũy điều này cho xấp xỉ phổ biến , trong đó là số tham số và là tổng số token training.
Các thay đổi cấu trúc cũng có thể được xử lý bằng cùng suy luận này. Đóng băng một ma trận trọng số loại bỏ nhu cầu tính gradient trọng số của nó; nếu các lớp trước vẫn cần gradient, gradient đầu vào vẫn phải được tính. MoE tích lũy hai loại gradient này trên các chuyên gia thực sự được chọn, còn attention tích lũy chúng trên các cặp query–key. Cộng từng số hạng dọc theo chuỗi phụ thuộc backward cho ta lượng tính toán cần thiết của mỗi phương pháp training.
Ngoài lượng tính toán, training còn đưa ra các yêu cầu giữ trạng thái mới. Ngoài cần thiết để tính , việc tính gradient cho các thao tác phi tuyến cũng cần các kết quả trung gian tương ứng. Gradient tham số được tạo ra trong quá trình lan truyền ngược rồi được optimizer dùng để tính cập nhật tham số. Trạng thái của optimizer ghi lại thông tin tích lũy qua nhiều lần cập nhật, nên nó phải được giữ lại cho đến lần cập nhật tiếp theo. Mỗi loại dữ liệu phải được giữ bao lâu phụ thuộc vào thao tác cuối cùng sử dụng nó: activation của một lớp thường được giải phóng một khi tính toán backward của lớp đó đã dùng xong chúng, còn momentum của optimizer phải tồn tại qua nhiều lần cập nhật.
Ví dụ 3-3: Vì sao gradient và trạng thái optimizer nhân lên yêu cầu bộ nhớ của training?
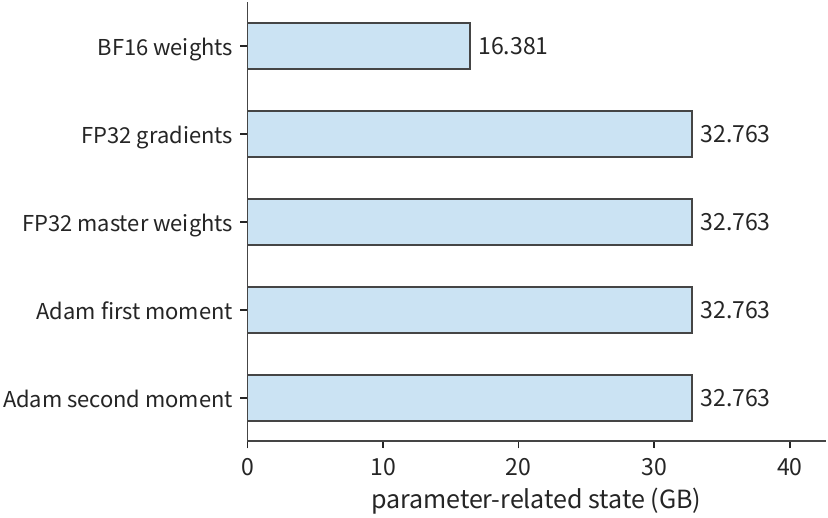
Lời giải: Lấy 8.190.735.360 tham số của Qwen3-8B làm ví dụ, lưu trọng số BF16, gradient FP32, một bản trọng số chủ FP32 riêng và hai ước tính moment FP32 của Adam. Adam là một optimizer điều chỉnh độ lớn cập nhật dựa trên trung bình động của gradient và gradient bình phương; hai ước tính moment lưu hai trung bình này tương ứng. Không phân shard (chia các trạng thái này cho nhiều card để lưu), mỗi tham số cần byte, tổng cộng 147,433 GB, khoảng 137,308 GiB. Ngay cả trước khi tính activation, trạng thái này đã vượt bộ nhớ GPU định mức của một H100 SXM (80 GB), một RTX PRO 6000 Blackwell Workstation Edition (96 GB), thậm chí cả H200 (141 GB). Trọng số BF16 được dùng cho tính toán forward và backward, gradient được dùng để tính cập nhật, trọng số chủ FP32 dùng cho cập nhật độ chính xác cao, và hai ước tính moment của Adam tích lũy thống kê trên gradient và bình phương của nó. Cùng nhau, dữ liệu này chiếm gấp chín lần không gian của trọng số BF16 khi inference.
Sau khi làm rõ yêu cầu trạng thái, giờ chúng ta phân tích dữ liệu được gom lô vào training như thế nào. Micro-batch là tập con dữ liệu thực sự được xử lý bởi một lượt forward và backward đơn lẻ; một batch training hoàn chỉnh có thể gồm nhiều micro-batch. Micro-batch cũng phải được phân biệt với cập nhật tham số. Khi bộ nhớ GPU không chứa nổi một batch training hoàn chỉnh, gradient có thể được tích lũy qua nhiều micro-batch trước một lần cập nhật tham số. Chừng nào mục tiêu, nhãn hiệu quả và chuẩn hóa vẫn nhất quán, việc tách cùng một batch training thành nhiều micro-batch hơn thay đổi thứ tự thực thi và vòng đời activation, trong khi tổng lượng dữ liệu training không đổi. Chương 10 sẽ dựa trên điều này để thảo luận về phân shard và pipeline.
Training cũng phải liên tục chuẩn bị batch đầu vào tiếp theo. CPU đọc, giải mã và token hóa dữ liệu, lắp ráp thành một batch, rồi gửi các tensor đến accelerator. Double buffering cho phép batch tiếp theo được chuẩn bị trong khi batch hiện tại đang được tính toán: một bộ đệm được đọc để tính toán trong khi bộ đệm kia nhận dữ liệu mới, và hai bộ đệm luân phiên nhau. Một khi tính toán dùng xong dữ liệu đã chuẩn bị, nó phải chờ đầu vào mới; lấy kết quả của accelerator cũng liên quan chờ tính toán tương ứng hoàn tất. Chương 5 sẽ kết hợp thứ tự thực thi của lượt forward, lượt backward và cập nhật tham số để phân tích cách chuẩn bị dữ liệu và tính toán có thể chồng lấn.
3.4.2 Pretraining, training giai đoạn giữa và SFT
Các giai đoạn training có tên khác nhau, nhưng hệ thống phải trả lời cùng các câu hỏi mỗi lần: có bao nhiêu token đầu vào, token nào đóng góp vào loss và sau bao nhiêu micro-batch thì cập nhật tham số xảy ra. Pretraining thường thực hiện dự đoán token tiếp theo trên văn bản liên tục; training giai đoạn giữa điều chỉnh thành phần dữ liệu hoặc độ dài ngữ cảnh; tinh chỉnh có giám sát (supervised fine-tuning, SFT) tiếp tục training model bằng các đầu vào và phản hồi đích cho trước, thường đưa chỉ dẫn và phản hồi vào cùng nhau trong khi chỉ tính loss trên phần phản hồi. Khi ước tính tài nguyên, các khác biệt này phải được chuyển thành hình dạng đầu vào, số token dưới sự giám sát và tần suất cập nhật.
Quá trình training của Qwen3 minh họa các biến thể này: giai đoạn tổng quát training trên các chuỗi dài 4096 với hơn 30 nghìn tỷ token, sau đó khoa học, công nghệ, kỹ thuật và toán học (STEM), mã nguồn, reasoning và dữ liệu tổng hợp được thêm vào, và training tiếp tục khoảng 5 nghìn tỷ token nữa; giai đoạn ngữ cảnh dài sau đó kéo dài độ dài lên 32768. Thay đổi thành phần dữ liệu ảnh hưởng đến điều được học, còn độ dài chuỗi trực tiếp thay đổi lượng ngữ cảnh trước mà mỗi token có thể truy cập, nên hai điều phải được xem xét riêng.
Yêu cầu hệ thống thay đổi theo độ dài. Giả sử hai tài liệu độc lập đều chứa 8192 token: một tài liệu chia thành , tài liệu kia thành . Số hàng trong các phép chiếu tham số giống nhau, nhưng các cặp query–key attention nhân quả hiệu quả khác nhau, lần lượt là 16.781.312 và 26.218.496. Trong một lớp đơn của Qwen3-8B, công việc forward cho và tăng từ khoảng 0,275 lên 0,430 TFLOPs, tăng khoảng 56%. Các token trong tài liệu dài hơn có thể thấy nhiều ngữ cảnh trước hơn, nên với cùng tổng số hàng, tương tác ngữ cảnh tăng, trong khi các phép chiếu và FFN vẫn xử lý cùng 8192 biểu diễn token. Tính toán của cả lớp tăng bao nhiêu phụ thuộc vào tương tác mới thêm này chiếm bao nhiêu phần của khối lượng công việc ban đầu.
Trong SFT, các token model đọc và các token đóng góp vào loss thường khác nhau. Một mẫu có thể gồm system prompt, câu hỏi người dùng, kết quả công cụ và một phản hồi, nhưng training chỉ tính loss trên phần phản hồi. Các token khác vẫn đi qua mạng backbone, cung cấp ngữ cảnh cho phản hồi. Một cách triển khai cũng có thể chỉ tính phép chiếu từ vựng cho các token dưới sự giám sát; nếu thay vào đó nó chỉ che (mask) các token không dưới sự giám sát khi tính loss, mà không bỏ qua phép chiếu từ vựng cho các token đó, phép nhân ma trận đó vẫn chạy như thường.
Ngoài việc chỉ tính loss trên một phần token, tinh chỉnh cũng có thể chỉ training một phần tham số, trong trường hợp đó các tham số cần lưu gradient và trạng thái optimizer sẽ thu nhỏ tương ứng. Trọng số của một mô-đun bị đóng băng không đổi, nhưng gradient vẫn phải xuyên qua nó để tới các mô-đun trainable phía trước, nên gradient đầu vào của nó vẫn phải được tính. Đi từng lớp dọc theo đồ thị backward và quyết định có tính gradient đầu vào và có tính gradient trọng số hay không cho phép chúng ta tính riêng trạng thái và tính toán training.
Số micro-batch và số lần cập nhật điều khiển có bao nhiêu lần công việc được lặp lại. Giả sử mỗi micro-batch có chuỗi dài , và micro-batch được tích lũy trước mỗi lần cập nhật; thì mỗi lần cập nhật đọc token đầu vào. Nếu mỗi chuỗi chỉ có token dưới sự giám sát, số token hiệu quả dùng cho chuẩn hóa loss là . Tăng số lần tích lũy làm lớn batch cho mỗi lần cập nhật trong khi cho phép một lần cập nhật thực thi qua nhiều lượt forward-backward; trạng thái tham số được giữ suốt quá trình, còn activation của mỗi micro-batch có thể được giải phóng khi lượt backward của nó kết thúc.
3.4.3 Từ ước tính đến chi phí training chi tiết theo hạng mục
Một khi dữ liệu training và số token hiệu quả được xác định, tổng lượng tính toán có thể được tích lũy. Bắt đầu với ước tính thô rằng chi phí training của một lớp tuyến tính “bằng khoảng ba lần lượt forward”, rồi cộng lại từng số hạng attention, đầu từ vựng và cập nhật trạng thái, để thấy khoảng cách giữa ước tính thô và model hoàn chỉnh.
Lấy một lượt forward và backward training đầy đủ làm ví dụ: Qwen3-8B, , training đủ tham số, đầu từ vựng được thực thi cho mọi token đầu vào, không tái tính toán (thực thi lại một phần lượt forward trong lượt backward để tiết kiệm activation được lưu). Tích lũy từng lớp qua các phép chiếu, FFN, , và đầu ra sẽ cho các FLOPs ma trận sau.
| Tính toán ma trận | TFLOPs |
|---|---|
| Ma trận forward | 143.789 |
| Ma trận backward | 287.579 |
| Forward cộng backward | 431.368 |
| Trong đó, attention nhân quả và , forward cộng backward | 59.381 |
| Tổng tham số cắm vào | 402.591 |
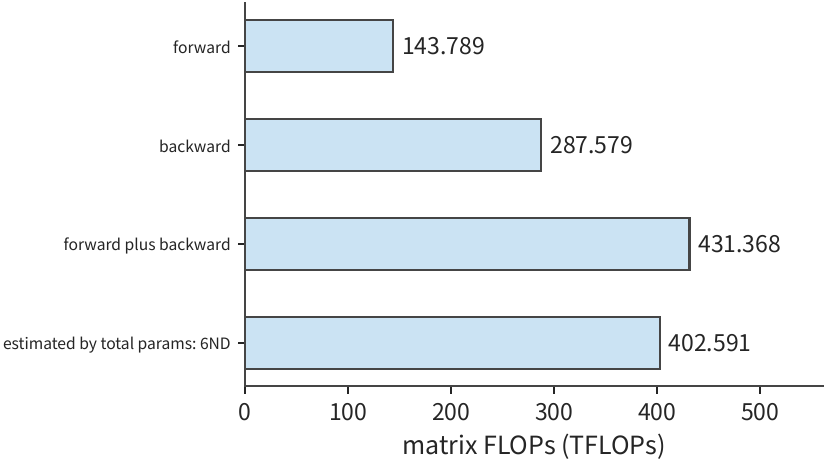
Việc hiệu chỉnh ước tính thô 402,591 TFLOPs lên 431,368 TFLOPs đòi hỏi trước tiên xác định công việc nào đã bị bỏ sót và công việc nào bị đếm hai lần. Phép nhân ma trận giữa query và ngữ cảnh không tương ứng với một tập tham số model, nhưng nó đóng góp 59,381 TFLOPs cho forward và backward cộng lại; mặt khác, các mô-đun như word embeddings chứa tham số nhưng không thực thi một phép nhân ma trận đầy đủ cho mỗi token, nên chúng không thể đơn giản được tính qua . Sau khi hai hiệu chỉnh này bù trừ lẫn nhau, tổng tính toán ma trận cao hơn ước tính thô khoảng 7,15%. Đây là loại khoảng cách đầu tiên được mô tả trong Mục 1.3.4: ước tính thô bỏ sót số hạng bậc hai của attention và đếm quá tham số không tham gia một phép nhân ma trận đầy đủ. Điều cần hiệu chỉnh là chính model, độc lập với cách triển khai. Chỉ có cận dưới đã hiệu chỉnh mới có thể dùng để đo mức sử dụng của hệ thống.
Nếu số nhãn hiệu quả giảm xuống 4096 trong khi phép chiếu từ vựng vẫn được tính cho mọi token, tính toán ma trận không đổi. Nếu thay vào đó, các vector ẩn cho các token dưới sự giám sát trước tiên được trích xuất và phép chiếu từ vựng chỉ được tính cho chúng, tổng giảm xuống 416,074 TFLOPs. Mạng backbone vẫn xử lý mọi token đầu vào; điều được tiết kiệm là phép chiếu từ vựng cho các token không dưới sự giám sát. Trong lượt backward, các gradient sau đó được đặt lại vào các vị trí tương ứng.
Chuẩn hóa, activation, loss và optimizer đều cũng yêu cầu tính toán cũng như đọc/ghi. Lấy cập nhật tham số làm ví dụ: ngay cả với một chuỗi ngắn, trọng số, gradient và trạng thái optimizer vẫn phải được đọc và ghi; chuỗi càng ngắn, phần đóng góp của chi phí này trong tổng thể càng lớn. Ngân sách training do đó phải tính đến cả tính toán ma trận tăng theo số token lẫn chi phí cập nhật được quyết định bởi số tham số.
Các thao tác forward mới thêm vào model cũng thêm tính toán backward tương ứng. Nén ngữ cảnh yêu cầu gradient qua phép chiếu, gộp và cập nhật trạng thái; mHC yêu cầu truyền gradient qua mọi đường dư; MoE phải chỉ tính gradient cho các chuyên gia thực sự được chọn. Đồ thị tính toán của Chương 2 do đó cũng có thể dùng để xác định kết quả trung gian nào phải được lưu trong training và thao tác nào lượt backward phải thực thi.
Vì vậy, khi độ dài chuỗi thay đổi, trước tiên chúng ta có thể đánh giá xu hướng của từng chi phí: phép chiếu tham số tăng theo số hàng đầu vào, attention tăng theo số cặp query–key, và cập nhật optimizer tăng theo số tham số và tần suất cập nhật. Với tái tính toán, yêu cầu năng lực giảm, nhưng công việc forward được tính lại phải được cộng ngược vào . Tất cả các thay đổi này có thể được giải thích từng số hạng dọc theo cùng đồ thị forward-backward.
Bài tập 3-6 [Mở rộng]: Một lần cập nhật tham số cần bao nhiêu tính toán, trạng thái training và token dưới sự giám sát
Suy ra kích thước của gradient đầu vào và gradient trọng số từ , và giải thích vì sao ba phép nhân ma trận liên quan cùng một lượng tính toán. Với Qwen3-8B, tính tổng năng lực trạng thái training dài hạn ở 18 byte mỗi tham số, rồi đổi gradient thành BF16 và tìm năng lực tiết kiệm được. Giả sử mỗi micro-batch chứa 2 chuỗi, mỗi chuỗi có 4.096 token đầu vào, trong đó 1.024 token dưới sự giám sát. Sau khi tích lũy 8 micro-batch, một cập nhật tham số xảy ra; hãy tìm tổng token đầu vào và tổng token giám sát hiệu quả được xử lý mỗi lần cập nhật. Giải thích sự khác biệt về tính toán giữa chỉ che các token không giám sát trong loss so với chỉ tính phép chiếu từ vựng cho các token dưới sự giám sát.
3.5 Học tăng cường (RL)
3.5.1 Rollout, phần thưởng và xác minh môi trường
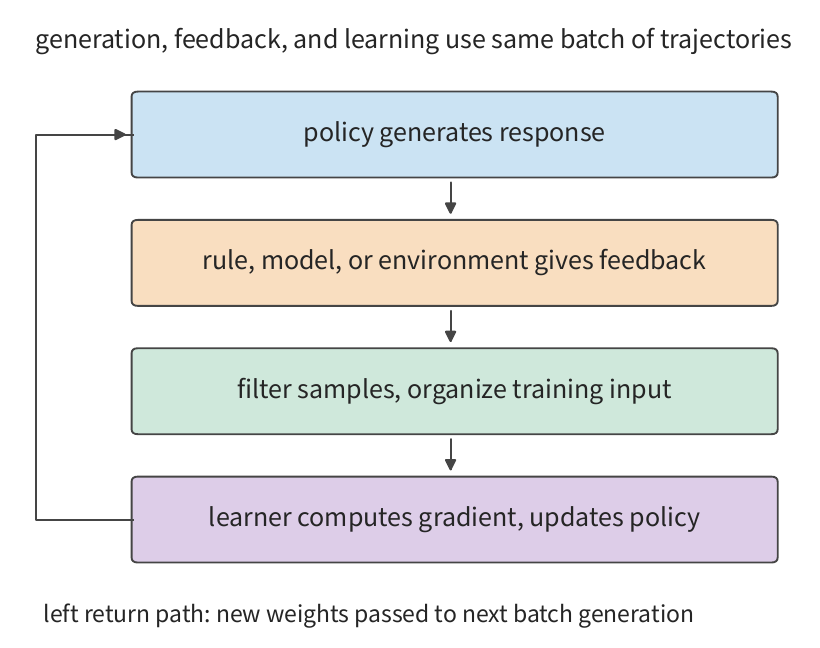
Inference bắt đầu từ một yêu cầu bên ngoài; pretraining bắt đầu từ văn bản hiện có. Học tăng cường (reinforcement learning, RL) dùng phản hồi thu được từ các hành động để cải thiện các hành động sau. Trong một model ngôn ngữ, policy là phân bố xác suất trên token tiếp theo với ngữ cảnh cho trước. RL nối hai đường: policy hiện tại trước tiên sinh một phản hồi, sau đó phản hồi quyết định cách cập nhật tham số, và policy đã cập nhật tiếp tục tạo ra lô dữ liệu tiếp theo. Quá trình sinh thường được gọi là rollout.
Cách training này đã có thực tiễn công khai phía sau: DeepSeek-R1 trình bày một cách tiếp cận bắt đầu từ các nhiệm vụ reasoning và phần thưởng xác minh được. Với các nhiệm vụ như mã nguồn và toán học dễ kiểm tra, phản hồi có thể đến từ quy tắc hoặc kiểm thử; với các nhiệm vụ cần thao tác thực tế, các công cụ và môi trường phải được chạy. Phần thưởng (reward) là một giá trị số dùng để đánh giá hiệu quả của một phản hồi hoặc hành động. Nếu phần thưởng được tạo ra bởi một model khác, điều này thêm inference phụ trợ. Một “vòng lặp training” đơn lẻ do đó có thể liên quan nhiều model, kiểm thử CPU, chờ sandbox và một lần cập nhật gradient.
Các model gần đây hơn kết hợp RL với các giai đoạn training khác. DeepSeek V4-Flash trước tiên training các chuyên gia miền qua SFT và RL, sau đó tích hợp năng lực của nhiều chuyên gia vào một model đơn qua chưng cất theo policy bổ trợ nhiều teacher (multi-teacher on-policy distillation, OPD). Chưng cất cho phép một model học sinh học từ thông tin đầu ra do các model teacher cung cấp; trong OPD, học sinh hiện tại tự sinh ra các quỹ đạo, và các teacher cung cấp phân bố xác suất trên các đầu ra ứng viên tại các vị trí token đó, từ đó học sinh học. Các lượt forward của teacher do đó trở thành một phần công việc model bổ sung giữa sinh và cập nhật; xác minh theo quy tắc, song song đó, cung cấp phản hồi qua kiểm thử hoặc thực thi chương trình, đòi hỏi một bộ tài nguyên tính toán riêng.
Khi phân tích tài nguyên dọc theo chu kỳ này, trước tiên xác định nhà sản xuất và người tiêu thụ dữ liệu: policy tạo ra token, hàm phần thưởng hoặc teacher đọc các phản hồi, học sinh đọc các mẫu training và tạo ra trọng số mới, và các bản sao model chịu trách nhiệm sinh sau đó dùng trọng số mới. Nếu một vai trò chậm lại, các vai trò sau phải chờ; thêm một model teacher đòi hỏi thêm tính toán forward và không gian lưu trữ trọng số. Mọi sắp xếp song song sau đó phải được xây dựng trên đồ thị phụ thuộc này.
3.5.2 Mẫu hiệu quả, cập nhật policy và đồng bộ trọng số
Sau khi sinh các phản hồi và tính phần thưởng, vẫn phải quyết định mẫu nào được dùng cho việc học. Điểm mấu chốt là phân biệt các mẫu đã sinh với các mẫu cuối cùng đi vào cập nhật: mẫu trước quyết định chi phí sinh, mẫu sau quyết định batch training, và hai số lượng không nhất thiết khớp.
Giả sử một vòng cần giữ lại mẫu, và tỷ lệ giữ lại trung bình của các mẫu đã sinh là ; thì số mẫu kỳ vọng phải sinh là
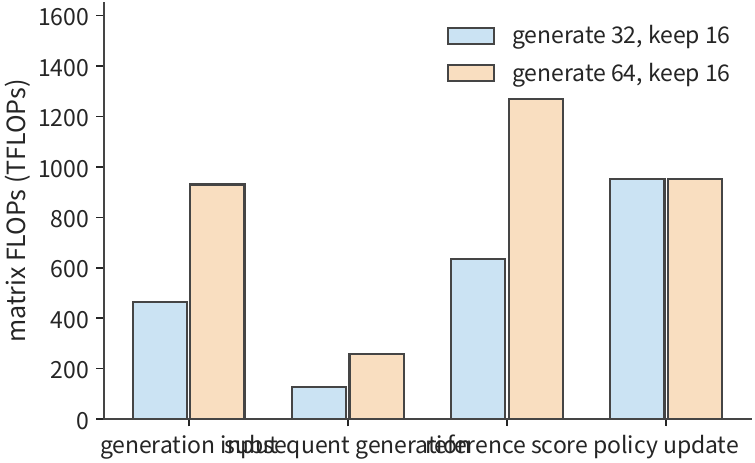
Để giữ lại 16 mẫu, khi tỷ lệ là một nửa, trung bình phải sinh 32; khi nó giảm xuống một phần tư, trung bình phải sinh 64. Sinh và chấm điểm xử lý mọi phản hồi, còn cập nhật tham số chỉ xử lý các mẫu được giữ lại; tỷ lệ giữ lại giảm làm tăng công việc của hai giai đoạn đầu mà không mở rộng batch cập nhật theo cùng tỷ lệ. Mục 3.5.3 sẽ dùng các mẫu có độ dài bằng nhau và một số lượng sinh cụ thể để so sánh hai trường hợp này.
Việc một mẫu có được giữ lại hay không được quyết định bởi phương pháp training và các quy tắc lọc của nó. Một số phương pháp coi phản hồi thất bại là phản hồi tiêu cực; một số khác loại trừ các phản hồi bị cắt ngắn hoặc phản hồi có phần thưởng không hợp lệ. Advantage biểu diễn một phản hồi tốt hơn hay tệ hơn bao nhiêu so với một đường cơ sở so sánh. Khi dùng advantage tương đối theo nhóm, nhiều phản hồi cho cùng một câu hỏi phải được so sánh. Vì vậy số mẫu được giữ lại quyết định bao nhiêu dữ liệu được xử lý tại thời điểm cập nhật, còn hàm phần thưởng và loss quyết định dữ liệu này tạo ra gradient gì.
Ví dụ: vì sao phần thưởng giống hệt nhau triệt tiêu tín hiệu học trong nhóm. Trong cập nhật policy dùng phần thưởng tương đối theo nhóm, nếu mọi phản hồi trong một nhóm nhận cùng một phần thưởng, thì sau khi trừ phần thưởng trung bình của nhóm, advantage của mỗi phản hồi bằng không, và gradient policy tương ứng cũng bằng không. Điều này có thể xảy ra khi mọi phản hồi đều đúng. Model đã trải qua toàn bộ đường ống sinh, chấm điểm và cập nhật, nhưng không thu được tín hiệu nào phân biệt phản hồi tốt với phản hồi xấu trong nhóm này. Chỉ khi các phần thưởng khác nhau mới xuất hiện advantage khác không, cho phép loss policy đẩy các tham số theo hướng tương ứng.
Cách loss được lấy trung bình cũng ảnh hưởng đến training. Nếu mục tiêu là lấy trung bình trên mọi token hiệu quả trong toàn bộ batch, thì việc tích lũy gradient qua các micro-batch phải dùng tổng số token hiệu quả của toàn bộ batch làm mẫu số. Nếu thay vào đó trung bình được tính riêng cho từng micro-batch rồi các trung bình này được lấy trung bình với nhau, các token trong micro-batch có ít token hiệu quả hơn có thể bị gán trọng số lớn không cân xứng. Chương 10 sẽ giải thích sự khác biệt này bằng các phương pháp training cụ thể.
Sau khi cập nhật, trọng số policy vẫn phải được gửi đến phía sinh. Nếu phía sinh tiếp tục dùng phiên bản cũ, lô dữ liệu tiếp theo vẫn sẽ do policy cũ tạo ra. Một chu kỳ đồng bộ có thể chờ trọng số sẵn sàng trước khi sinh; các sơ đồ bất đồng bộ cho phép một số giai đoạn chồng lấn nhưng phải xử lý quản lý phiên bản và độ cũ của mẫu. Chương này đã thiết lập phụ thuộc này; Chương 10 sẽ thảo luận chuyển giao, preemption, khôi phục và các tỷ lệ tài nguyên.
3.5.3 Với số mẫu hiệu quả cố định, mỗi giai đoạn cần bao nhiêu tính toán
Sự phân biệt này có thể được định lượng bằng một mục tiêu cố định: mỗi vòng phải giữ lại 16 mẫu cho cập nhật. Nếu các phản hồi khó vượt qua bộ lọc hơn, nhiều phản hồi hơn phải được sinh trước.
Ví dụ 3-4: khi tỷ lệ giữ mẫu giảm, cần thêm bao nhiêu tính toán để giữ số mẫu cập nhật không đổi?
Lời giải: Lấy Qwen3-8B làm ví dụ, với tám câu hỏi, bốn phản hồi sinh cho mỗi câu hỏi, , giữ lại tổng cộng 16 mẫu cho một lần cập nhật policy. Model tham chiếu (reference model — một model có trọng số cố định dùng để giới hạn policy có thể lệch bao xa) có cùng cấu trúc với model policy và lưu trọng số riêng; model tham chiếu chạy một lượt forward trên mỗi phản hồi trong 32 phản hồi, và ví dụ này không gọi model teacher. Tất cả mẫu có cùng độ dài, sinh không dừng sớm và không có tái sử dụng tiền tố dùng chung.
Trong lúc sinh, mỗi mẫu trước tiên làm một prefill, rồi 255 bước decode. Trong training và chấm điểm, vì quỹ đạo đã cố định, tính toán forward có thể dùng teacher forcing: mỗi bước dự đoán dùng token trước đó đã được cố định trong quỹ đạo thay vì chờ model tái sinh nó. Nên các token đã biết này có thể được tính cùng nhau. Độ dài đầu vào là , với 256 nhãn đầu ra nằm tại các vị trí tương ứng. Qua 16 mẫu được giữ lại, mỗi lần cập nhật đọc tổng cộng 20.464 token đầu vào và giám sát tổng cộng 4.096 token đầu ra. Token đầu vào quyết định tính toán ngữ cảnh, còn token dưới sự giám sát quyết định loss tác động lên gì; hai loại đi vào ngân sách training riêng biệt.
| Giai đoạn | Mẫu được xử lý | FLOPs ma trận (TFLOPs) |
|---|---|---|
| Rollout prefill | 32 | 465.143 |
| Rollout decode, 255 bước/mẫu | 32 | 129.056 |
| Model tham chiếu, một lượt forward | 32 | 634.944 |
| Chấm điểm teacher, đặt bằng không | 0 | 0 |
| Cập nhật policy, một lượt | 16 | 952.416 |
| Tổng cộng | 16 được giữ lại | 2.181.559 |
Ký hiệu tổng tính toán sinh và model tham chiếu cho một phản hồi là , và tính toán cho một batch cập nhật cố định là ; thì
Model tham chiếu đọc một phản hồi hoàn chỉnh và có thể xử lý nhiều token đã biết cùng lúc; trái lại, sinh tiến hành từng token một. Dù công thức trên cộng các lượng tính toán lại với nhau, hình dạng ma trận ở mỗi giai đoạn vẫn phải được ghi riêng để ước tính thời gian thực thi dựa trên hiệu suất thực thi tương ứng.
Nếu tỷ lệ giữ lại giảm từ 1/2 xuống 1/4 trong khi vẫn yêu cầu 16 mẫu được giữ lại, so sánh dạy học của chúng ta đổi số lượng sinh thành 64. Sinh và tính toán model tham chiếu nhân đôi, lượng cập nhật không đổi, và tổng tính toán ma trận tăng lên 3.410,701 TFLOPs, tăng khoảng 56,3%. Tính toán ma trận quy cho mỗi mẫu được giữ lại tăng từ 136,347 lên 213,169 TFLOPs. 1.229,142 TFLOPs thêm vào đều đến từ sinh và tính toán model tham chiếu cho các phản hồi bổ sung; 16 mẫu đi vào cập nhật không đổi.
Một khi cập nhật hoàn tất, các bản sao sinh cần lấy trọng số mới. Với bản sao, mỗi bản sao được gửi độc lập một bản đầy đủ trọng số có kích thước , khối lượng truyền là . Một bản trọng số BF16 của Qwen3-8B khoảng 16,381 GB, nên bốn bản sao cùng nhau cần khoảng 65,526 GB. Trạng thái optimizer ở lại với bộ học, để dùng cho lần cập nhật tiếp theo; các bản sao sinh chỉ cần trọng số cho lượt forward. Truyền quảng bá hoặc phân cấp có thể giúp nhiều bản sao chia sẻ một phần đường truyền, giảm truyền dư thừa.
Khi phân bổ tài nguyên qua các giai đoạn, cả lượng tính toán lẫn cách tính toán được thực hiện đều quan trọng. Mỗi bước decode trong giai đoạn sinh thường chỉ xử lý một token mới cho mỗi yêu cầu, nên với batch nhỏ, tương đối ít token được xử lý cùng lúc; trái lại, chấm điểm và training có thể xử lý nhiều token của một phản hồi đã biết cùng nhau, và xác minh công cụ còn cần tài nguyên CPU và một môi trường thực thi. Ước tính thời gian cho từng giai đoạn riêng, rồi sắp xếp chúng theo thứ tự sinh, phản hồi, cập nhật và đồng bộ trọng số, chính là điều tạo nên chu kỳ hoàn chỉnh. Các Chương 4 đến 10 sẽ lần lượt giới thiệu phần cứng và phương pháp lập lịch tương ứng.
Bài tập 3-7 [Cốt lõi]: với số mẫu cập nhật cố định, sinh thêm phản hồi cộng thêm bao nhiêu chi phí RL
Giữ một lần cập nhật dùng 16 mẫu có độ dài bằng nhau. Dùng tổng tính toán chu kỳ từ Ví dụ 3-4 cho việc sinh lần lượt 32 và 64 phản hồi, hãy tìm tính toán sinh-cộng-model-tham-chiếu bổ sung được thêm cho mỗi phản hồi sinh thêm, cùng với tính toán cố định cần cho một lần cập nhật. Giữ số mẫu cập nhật cố định, dùng điều này để dự đoán tổng tính toán chu kỳ khi sinh 48 phản hồi. Sau đó, dùng một model teacher cùng cấu trúc với model sinh, chạy một lượt forward trên mỗi phản hồi trong 48 phản hồi và tìm tính toán bổ sung nó thêm vào. Nếu trọng số BF16 đã cập nhật được gửi đến bốn bản sao, mỗi bản sao độc lập nhận một bản đầy đủ, hãy tìm tổng khối lượng truyền. Cuối cùng, vẽ các phụ thuộc giữa sinh, phản hồi, cập nhật và đồng bộ, và xác định giai đoạn nào có thể chồng lấn giữa các batch khác nhau.
3.6 Từ yêu cầu tải đến ngân sách training và serving
3.6.1 Scaling Law: Mối quan hệ giữa quy mô model và khối lượng dữ liệu
Tính toán của một lần cập nhật có thể được suy ra từng số hạng, nhưng bao nhiêu tham số để training và bao nhiêu dữ liệu để dùng đòi hỏi một quyết định riêng. Gọi tổng ngân sách tính toán training là , số tham số là và số token training là ; tính toán chi phối xấp xỉ thỏa . Tăng buộc giảm . Chọn giữa hai cái đòi hỏi biết tham số và dữ liệu ảnh hưởng chất lượng riêng rẽ như thế nào. Scaling Law khớp, qua thí nghiệm, mối quan hệ giữa quy mô model, dữ liệu training và loss. Dưới đây chúng ta áp dụng mô hình lũy thừa (power-law), trong đó cả số hạng tham số lẫn số hạng dữ liệu đều dương, với cấu hình training và cách đánh giá loss được giữ cố định:
là loss xác thực, là loss tiệm cận, mô tả ảnh hưởng của quy mô tham số không đủ, và mô tả ảnh hưởng của khối lượng dữ liệu không đủ. Ở đây đều là các hệ số được khớp. Tăng riêng tham số hoặc dữ liệu làm giảm số hạng tương ứng; nhưng dưới ngân sách tính toán cố định, hai số hạng di chuyển theo các hướng ngược nhau.
Loại khối lượng dữ liệu bằng , rồi lấy đạo hàm theo . Điểm tối ưu thỏa
Vế trái là mức loss giảm từ việc thêm tham số; vế phải là mức loss tăng từ việc giảm dữ liệu. Khi hai bên bằng nhau, một thay đổi nhỏ thêm vào số tham số không mang lại lợi ích ròng. Sắp xếp lại cho:
thu được là một giá trị liên tục; trong thực tế, số lớp và độ rộng có thể được chọn gần nó. Lời giải tối ưu này chỉ tối thiểu hóa loss xác thực dưới ngân sách tính toán training cố định — nó loại trừ chi phí inference sau triển khai và không xét nguồn cung dữ liệu có đủ hay không. Khi một model đi vào phục vụ và phải xử lý khối lượng yêu cầu lớn, lựa chọn tối ưu có thể dịch chuyển về phía cấu hình nhỏ hơn, được training kỹ hơn; Mục 3.6.2 sẽ dùng các bản ghi training của các model công khai để kiểm tra đầu tư thực tế lệch khỏi dự đoán này bao xa.
Các số mũ phân bổ được khớp bởi các nghiên cứu khác nhau không thống nhất. Nghiên cứu sớm của Kaplan et al. cho quan hệ phân bổ gần đúng ; nghiên cứu Chinchilla, dùng thí nghiệm và cách khớp khác, tìm thấy quy mô model và khối lượng dữ liệu nên tăng theo tỷ lệ gần với tỷ lệ thuận với ngân sách. Phân bổ thứ nhất tăng tham số model nhanh hơn; phân bổ thứ hai dành nhiều ngân sách bổ sung hơn cho dữ liệu training. Do đó, đường cong và các số mũ khớp của nó trực tiếp thay đổi sự lựa chọn giữa tham số và dữ liệu.
Ví dụ 3-5: Một quan hệ quy mô training được khớp có thể dự đoán loss của một model lớn hơn không? Từ các bản ghi training công khai, chọn quan sát của sáu model nhỏ hơn để khớp và giữ lại (hold out) các quan sát của hai model lớn hơn. Trước tiên chọn một phương pháp khớp, sau đó so sánh các giá trị dự đoán cho các model giữ lại với các giá trị quan sát thực tế của chúng.
Lời giải: datablations là một tập công khai các bản ghi thí nghiệm nghiên cứu quy mô model và dữ liệu biến thiên ra sao; C4 là một trong các kho ngữ liệu văn bản được dùng trong các bản ghi này. Lấy tám model làm ví dụ, chúng ta khớp một đường cong dùng sáu model nhỏ hơn và giữ lại hai model có để kiểm thử. Loss thực tế của hai model lớn lần lượt khoảng 2,574 và 2,337; đường cong khớp dự đoán 2,583 và 2,363. Các dự đoán cao hơn một chút so với giá trị thực tế, với sai số căn quân phương khoảng 0,0193 nats/token. Nat là đơn vị thông tin khi dùng logarit tự nhiên; nats/token biểu thị loss trung bình mỗi token. Hình 3-27 phân biệt các điểm khớp và điểm kiểm thử bằng các marker khác nhau.
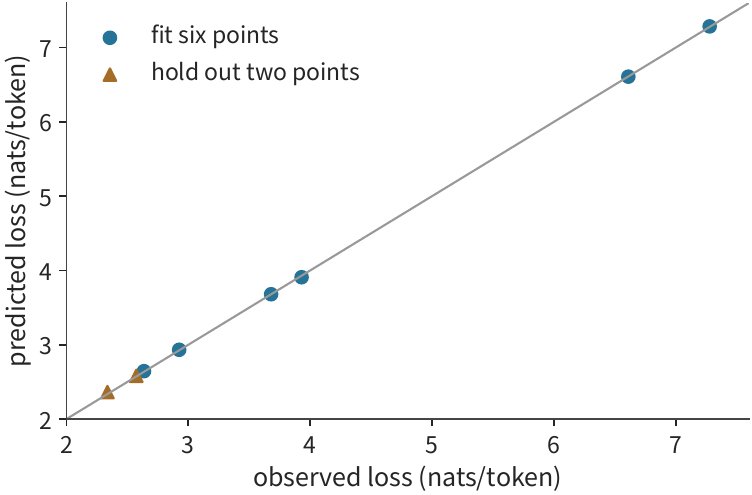
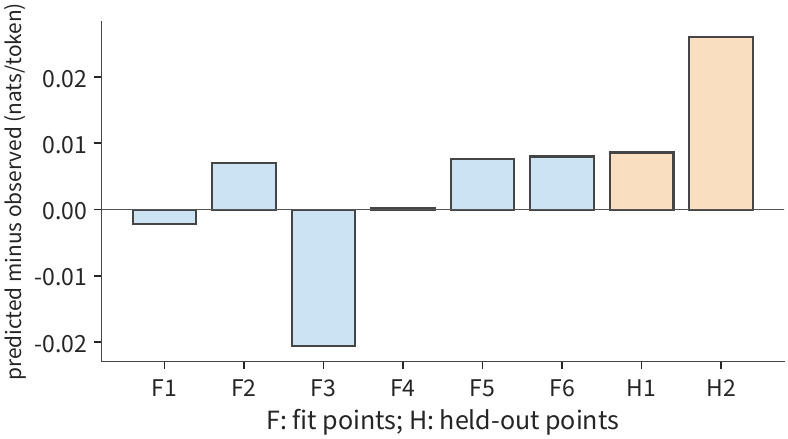
Kiểm thử giữ lại là cần thiết vì việc khớp chỉ đảm bảo đường cong bám sát nhất có thể với dữ liệu dùng để suy ra các hệ số. Chỉ bằng cách loại các model lớn hơn khỏi việc khớp rồi so sánh loss dự đoán với loss thực tế, chúng ta mới có thể kiểm tra quan hệ này có dự đoán được một quy mô mới hay không. Ở đây hai sai số lần lượt khoảng và ; bình phương chúng, lấy trung bình và khai căn sẽ cho sai số căn quân phương.
Sau khi dự đoán loss xác thực, chúng ta vẫn phải đánh giá model có thể hoàn thành các nhiệm vụ thực tế hay không. Báo cáo Llama 3 trước tiên dự đoán loss từ lượng tính toán training, sau đó thiết lập quan hệ giữa loss và hiệu quả nhiệm vụ. Theo cách này, các yêu cầu chất lượng cho các nhiệm vụ như viết mã, truy hồi và sử dụng công cụ có thể tiếp tục được chuyển thành các lựa chọn quy mô training và tính toán.
Cả khớp và dự đoán đều dựa trên các quan sát từ một lần chạy training đơn lẻ, và bản thân training có phương sai. Với cùng dữ liệu và quy mô model, thay đổi khởi tạo ngẫu nhiên có thể tạo ra các đường cong học khác nhau; một model lớn hơn, khi chưa được training đủ, không nhất thiết vượt trội một model nhỏ hơn. Lặp lại training với nhiều seed ngẫu nhiên có thể tách xu hướng gây ra bởi thay đổi quy mô khỏi phương sai ngẫu nhiên của một lần chạy đơn lẻ.
Serving lâu dài tích lũy chi phí của mỗi lần gọi lên trên ngân sách training. Một model nhỏ hơn có thể đạt chất lượng mục tiêu qua training lâu hơn: đầu tư nhiều hơn lúc đầu, và sau đó mỗi lần gọi đọc ít trọng số hơn và thực hiện ít tính toán hơn. Beyond Chinchilla-Optimal đưa nhu cầu inference này vào phân tích, bao phủ 47 model trải từ 150M–6B; trong số đó, model 150M đạt khối lượng training cao tới 10.000 token mỗi tham số, trong khi các model lớn nhất đạt tới 1.000. Ngân sách training và số lần gọi dịch vụ cùng nhau quyết định khi nào một model nhỏ hơn thu hồi được chi phí training thêm.
Đầu tư training và chi phí dịch vụ tích lũy dưới một loss mục tiêu cố định. Cố định loss mục tiêu cho việc khớp ở 2,9, ước tính chi phí training và serving bằng khối lượng tính toán ma trận, rồi quy đổi mọi thứ về thời gian GPU H100 SXM (tích của số GPU và thời lượng sử dụng, đo bằng GPU-giây hoặc GPU-giờ). Lấy yêu cầu với ; tính toán training là , và tính toán mỗi yêu cầu hoàn chỉnh là . Đỉnh dense BF16 của H100 SXM là 989,4 TFLOP/s; MFU BF16 được báo cáo cho pretraining Llama 3 trên H100 (định nghĩa trong Mục 1.2.2) là 38%–43%. Lấy 40% cho cả training và serving, điều này quy đổi thành 395,76 TFLOP mỗi GPU-giây. Model 0,1B cần khoảng 298,6B token training, vượt cận trên của khối lượng dữ liệu dùng để khớp, nên biểu đồ chi phí đánh dấu đường ngoại suy này bằng đường đứt nét. Theo đường ngoại suy này, training model 0,1B mất khoảng 125,7 GPU-giờ H100, nhiều hơn 73,5 GPU-giờ so với model 0,5B; nhưng mỗi lần gọi sau đó dùng ít hơn khoảng 0,00129 GPU-giây. Ở khoảng 204,8 triệu lần gọi, tổng chi phí của hai model trở nên bằng nhau. Trước điểm này, chi phí training thêm mà model 0,1B trả chưa được thu hồi; sau điểm này, khoản tiết kiệm tích lũy mỗi lần gọi vượt khoản đầu tư ban đầu. Vì training và serving được quy đổi bằng cùng một hệ số, điểm giao nhau này chỉ phụ thuộc vào khối lượng tính toán và độc lập với giá trị MFU.
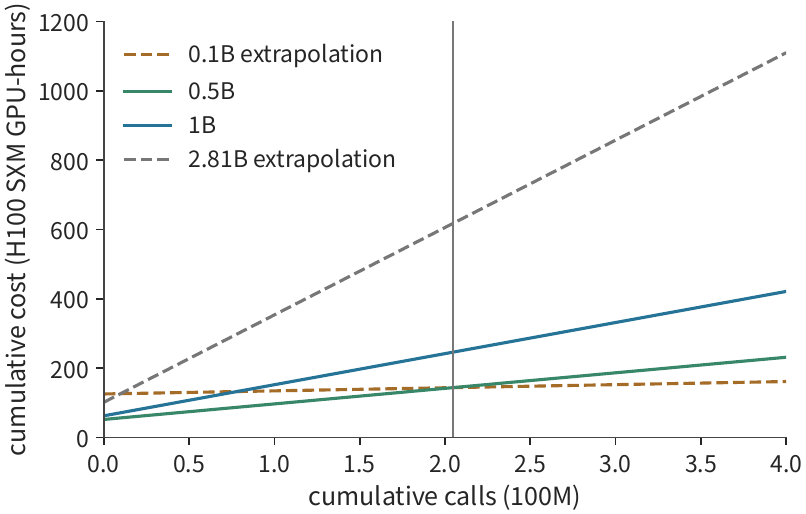
Quay lại việc phân bổ giữa tham số và dữ liệu, chúng ta cũng có thể trực tiếp dự đoán kết quả của một ngân sách tăng lên. Từ biểu thức lời giải tối ưu, ; thay ngược vào ràng buộc tính toán cho . Nếu hai số mũ bằng nhau, ngân sách tăng gấp bốn sẽ nhân đôi cả tham số lẫn dữ liệu training. Điều này làm ý nghĩa của các số mũ khớp trở nên cụ thể: các số mũ quyết định mọi tính toán bổ sung nên được chia giữa model và dữ liệu như thế nào.
Bài tập 3-8 [Mở rộng]: Cách phân bổ ngân sách tính toán giữa tham số model và dữ liệu training
Dùng mô hình loss và ràng buộc ngân sách tính toán , hãy suy ra số tham số tối thiểu hóa loss và khối lượng dữ liệu mỗi cái tăng theo ngân sách tính toán như thế nào. Lấy , khi ngân sách tính toán tăng lên gấp bốn lần và gấp chín lần giá trị ban đầu, số tham số tối ưu và khối lượng dữ liệu tối ưu mỗi cái nên tăng theo hệ số bao nhiêu? Sau đó, dùng tám điểm quan sát C4 từ Ví dụ 3-5, khớp với sáu điểm và kiểm thử với hai điểm còn lại, tính sai số dự đoán tại hai điểm kiểm thử, và giải thích vì sao sai số tại các điểm khớp không thể thay thế sai số từ kiểm thử giữ lại.
3.6.2 Đầu tư training từ Llama đến Qwen
Việc khớp trong Mục 3.6.1 đã giải thích cách quy mô model và dữ liệu training đánh đổi lẫn nhau. Mục này dùng hồ sơ training của các model công khai để phân tích khoản đầu tư training mà các nhà phát triển thực sự áp dụng: trước hết so sánh số token training trên mỗi tham số, sau đó tách khối lượng tính toán thuật toán khỏi thời gian training trên phần cứng cụ thể.
Từ các giai đoạn và quy mô được công bố trong nhiều báo cáo, một xu hướng hiện ra: ở cùng mức tham số khoảng 7–8B, số token training liên tục tăng.
| Model và phạm vi được công bố | Token training | Ước tính thô | Ước tính thô |
|---|---|---|---|
| Llama 1, 6.7B | 1T | 149 | FLOPs |
| Llama 2, ~7B | 2T | 286 | FLOPs |
| Llama 3.1, ~8B | ~15T | ~1.875 | ~ FLOPs |
| Qwen2.5, ~7B, công bố ở cấp họ model | ~18T | ~2.571 | ~ FLOPs |
| Qwen3, ~8B, công bố ở cấp họ model | ~36T | ~4.500 | ~ FLOPs |
quy đổi khoản đầu tư dữ liệu thành “mỗi tham số tương ứng với bao nhiêu token training.” Trong số các model dense khoảng 7–8B trong bảng, tăng từ khoảng 149 lên khoảng 4.500, cho thấy các model có số tham số tương tự có thể khác nhau rất nhiều về khối lượng dữ liệu training. Chi phí training ban đầu tăng theo dữ liệu, trong khi dung lượng trọng số cần cho mỗi lần gọi sau khi triển khai vẫn chủ yếu do số tham số quyết định. Do đó, một model nhỏ được training kỹ hơn có thể tăng khoản đầu tư một lần trong khi giảm chi phí serving lâu dài.
Những con số này cũng làm rõ mối quan hệ giữa kết quả khớp của Mục 3.6.1 và khoản đầu tư training thực tế. Theo phân bổ tỉ lệ của Chinchilla, khối lượng dữ liệu tối ưu theo tính toán cho một model khoảng 8B là khoảng 20 token mỗi tham số, tức khoảng 160B token; các khoản đầu tư thực tế trong bảng trải từ 1T đến khoảng 36T, vượt chuẩn này từ một đến hai bậc độ lớn. Hai cách tiếp cận trả lời các câu hỏi khác nhau: khớp tối thiểu hóa validation loss dưới một ngân sách tính toán training cố định, còn các nhà phát triển đưa chi phí serving sau khi triển khai vào mục tiêu của họ, chọn một model nhỏ hơn được training kỹ hơn khi nguồn dữ liệu dồi dào và khối lượng lời gọi dự kiến lớn. Nghiên cứu Beyond Chinchilla-Optimal được trích dẫn trong Mục 3.6.1 và công thức điểm giao nhau chi phí trong Mục 3.6.3 cho các điều kiện định lượng cho lựa chọn này. Tính tối ưu theo ngân sách training và tính tối ưu đầu cuối là hai mục tiêu khác nhau; khoản đầu tư thực tế vượt mục tiêu thứ nhất không có nghĩa mục tiêu thứ nhất bị tính sai.
Training lâu hơn, tuyển chọn dữ liệu, chưng cất (distillation) và post-training đều là những cách dùng nhiều công sức đầu vào hơn để nâng khả năng nhiệm vụ của một model ở một quy mô nhất định. Trong đánh giá base model của model card Llama 3, Llama 3 8B và Llama 2 70B lần lượt đạt 66,6/69,7 trên MMLU, một benchmark câu hỏi trắc nghiệm trải rộng nhiều ngành, và 78,5/87,5 trên TriviaQA-Wiki, một benchmark hỏi đáp dùng nguồn Wikipedia. Khoảng cách khác nhau trên hai benchmark cho thấy người triển khai phải đặt yêu cầu chất lượng theo đúng nhiệm vụ của mình; chỉ một model nhỏ đạt ngưỡng chất lượng mới có thể biến lợi thế về dung lượng và độ trễ đọc của trọng số nhỏ hơn thành lợi ích serving.
Khi phân tích các model lớn và MoE, tổng số tham số và số tham số được kích hoạt phải được liệt kê riêng. DeepSeek-V3 công bố 671B tổng tham số, khoảng 37B kích hoạt trên mỗi token và 14,8T token pretraining; DeepSeek V4-Flash công bố 284B / khoảng 13B và 32T; DeepSeek V4-Pro công bố 1,6T / khoảng 49B và 33T. Tổng trọng số quyết định dung lượng, trong khi tham số kích hoạt chỉ cho ước tính thô về khối lượng tính toán. Ba phép chiếu của các expert backbone DeepSeek V4-Flash có thể được tính riêng:
Ở đây là số lớp backbone, là chiều ẩn, là chiều trung gian của expert, còn và là số expert routed và expert shared được chọn trên mỗi token; hệ số lần lượt ứng với ba phép chiếu, 2 FLOP mỗi phép nhân-cộng, và tổng forward-cộng-backward gấp ba lần forward pass. Các expert backbone của DeepSeek V4-Flash tổng khoảng 45,4495 GFLOPs/token, tích lũy thành khoảng FLOPs trên 32T token; DeepSeek V4-Pro khoảng 169,2465 GFLOPs/token, tích lũy thành khoảng FLOPs trên 33T token. Tính toán của một bước training đầy đủ được cấu thành chung từ các ma trận expert này cùng với attention, routing, MTP, optimizer và tính toán lại (recomputation). Các trọng số loss được báo cáo cũng không phải là tỉ lệ thực thi — ví dụ, một trọng số MTP 0,3 không có nghĩa chỉ 30% tính toán phụ trợ được thực thi.
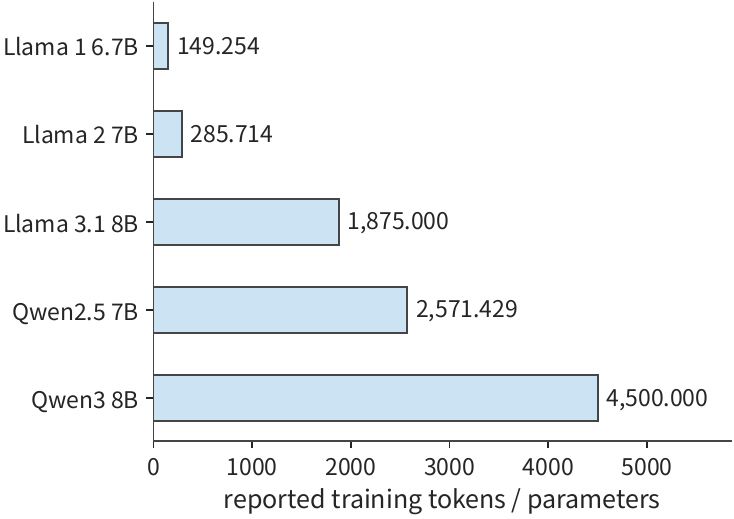
Bài tập 3-9 [Mở rộng]: Tăng dữ liệu training hoặc số expert thay đổi yêu cầu tài nguyên như thế nào
Hãy tính lại và từ bảng Llama/Qwen. Nếu số tham số giữ nguyên và khối lượng dữ liệu training tăng gấp bốn, hãy dự đoán tính toán training và dung lượng trọng số thuần sau khi triển khai mỗi cái thay đổi ra sao. Với MoE, hãy giải thích liệu khi tổng số expert tăng gấp đôi trong khi số expert được chọn mỗi token giữ nguyên, cả dung lượng tham số lẫn tính toán training của expert có thể được ước tính là tăng gấp đôi hay không.
Ngoài khối lượng tính toán, khoản đầu tư training cũng thường được đo bằng GPU-giờ. Nếu thẻ được dùng liên tục và tổng GPU-giờ là , thời gian lịch thực tế là
Training Llama 1 65B tiêu thụ 1.022.362 A100 GPU-giờ. Dùng liên tục 2048 thẻ, con số này tương ứng khoảng 499,2 giờ, tức 20,80 ngày; chỉ dùng một nửa số thẻ đó với cùng hiệu quả accelerator sẽ cần khoảng 41,60 ngày. GPU-giờ phản ánh tổng khoản đầu tư, còn số thẻ quyết định cần bao nhiêu thời gian thực tế để hoàn thành khối lượng công việc đó.
Báo cáo DeepSeek-V3 đưa ra 2,664M H800 GPU-giờ cho pretraining; 14,8T token chỉ tương ứng với giai đoạn pretraining. Dùng liên tục 2048 thẻ, việc này sẽ mất khoảng 54,20 ngày. Mở rộng ngữ cảnh và post-training sau đó có những con số sử dụng riêng, nhưng các giai đoạn khác nhau bao phủ các phạm vi khác nhau và không thể đơn giản chia chung cho số token pretraining.
Quy đổi GPU-giờ thành thời gian lịch thực tế đòi hỏi chia cho số thẻ dùng đồng thời trong cùng khoảng thời gian. Với Llama 3.1 405B, lấy con số 30,84M H100 GPU-giờ được công bố công khai và giả định công việc này dùng cả quy mô 16.384 thẻ suốt quá trình, thời gian lịch thực tế khoảng ngày. Nếu một giai đoạn nào đó dùng ít thẻ hơn, cùng số GPU-giờ sẽ cần nhiều thời gian lịch hơn; do đó thời điểm phân bổ tài nguyên training quyết định khi nào training hoàn thành.
Các con số sử dụng ở trên đến từ ba loại accelerator khác nhau, nên GPU-giờ không thể so sánh trực tiếp về quy mô đầu tư giữa các thiết bị. Quy đổi theo đỉnh tính toán dense BF16: A100 80GB là 312 TFLOP/s, còn H100 và H800 đều là 989,4 TFLOP/s (H800 chỉ có băng thông liên kết thấp hơn); một GPU-giờ H100 hoặc H800 do đó tương đương khoảng A100 GPU-giờ. Hình 3-31 quy đổi đồng nhất ba bộ con số sử dụng công khai thành giờ tương đương A100 80GB; phép quy đổi này giả định mức sử dụng thực tế tương tự giữa các thiết bị và nhằm so sánh quy mô đầu tư, không nhằm chỉ ra khác biệt về hiệu quả hay chi phí.
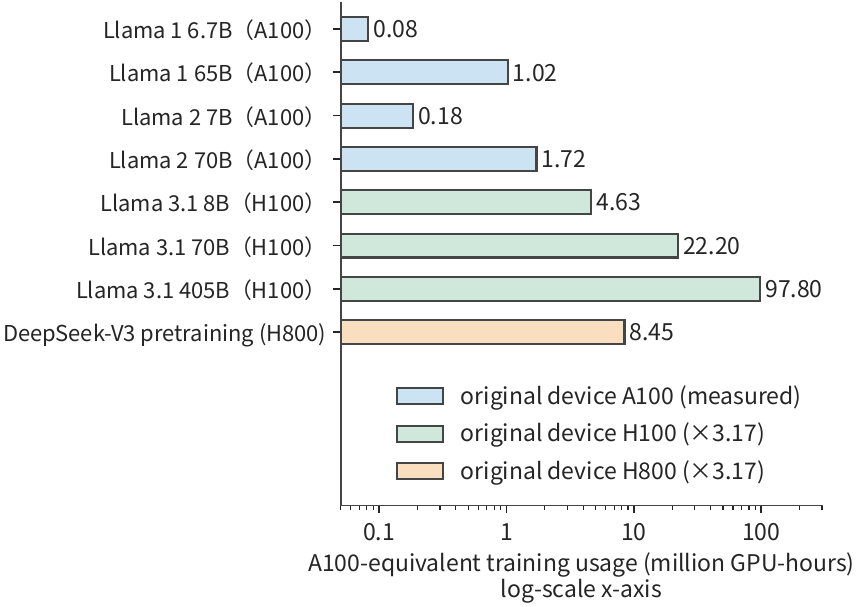
Tất cả các con số sử dụng ở trên đều thuộc pretraining; khoản đầu tư post-training cũng có thể được so sánh bằng GPU-giờ. Bảng 21 của báo cáo kỹ thuật Qwen3 liệt kê hai nhánh post-training RL và OPD cho cùng một model 8B cạnh nhau, với khoản đầu tư lần lượt 17.920 và 1.800 GPU-giờ. Hai nhánh là các phương án loại trừ lẫn nhau, mỗi nhánh bao gồm cả công việc sinh, phản hồi và học. Gán GPU-giờ vào các giai đoạn và accelerator cụ thể, rồi kết hợp với quá trình thực thi của từng giai đoạn, giúp chúng ta giải thích khoản đầu tư training chủ yếu được tiêu thụ ở đâu.
3.6.3 Chi phí đầu cuối dưới yêu cầu chất lượng
Bây giờ chúng ta gom lại phân tích của Chương 2 và chương này. Cấu trúc model quyết định dung lượng lưu trữ, khối lượng tính toán và khối lượng đọc cần cho mỗi lần gọi; khối lượng công việc quyết định số lần gọi và thời gian chờ liên quan; training quyết định khoản đầu tư trước khi đưa vào vận hành. Gọi chi phí ban đầu của model là ; giả sử sẽ có nhiệm vụ trong tương lai, với loại nhiệm vụ chiếm tỉ phần và chi phí trung bình mỗi nhiệm vụ hoàn thành là , do đó
Trước khi so sánh, mọi model phải đáp ứng cùng các điều kiện về chất lượng, hạn chót và tiêu chí hoàn thành. Nếu tỉ lệ thành công khác nhau giữa các model, cũng phải bao gồm chi phí của các lần thất bại và thử lại; các giả định về thay đổi giá, vòng đời model, bảo trì và chiết khấu cũng nên được nêu rõ khi đưa ra một ngân sách. Nếu phần cứng chuyên dụng đòi hỏi chu kỳ triển khai dài hơn, model có thể giữ trong sử dụng bao lâu cũng trở thành một điều kiện của lựa chọn này.
Xét hai model, cả hai đều thỏa mãn yêu cầu chất lượng nhiệm vụ và hạn chót. Nếu model nhỏ hơn cần thêm chi phí training , nhưng tiết kiệm cho mỗi nhiệm vụ thành công, khối lượng lời gọi tại đó chi phí tích lũy trở nên bằng nhau là
Nếu model nhỏ hơn cần thêm 100.000 H100 GPU-giờ training, tức GPU-giây, và tiết kiệm 0,72 H100 GPU-giây cho mỗi nhiệm vụ, thì , tức năm trăm triệu nhiệm vụ. Nếu nhu cầu dự kiến thấp hơn con số này, khoản chi phí training thêm chưa được thu hồi; cao hơn con số này, model nhỏ hơn tích lũy khoản tiết kiệm ròng lớn hơn. Dung lượng, độ trễ, chất lượng và khối lượng lời gọi cùng nhau quyết định lựa chọn; chỉ nhìn vào kích thước model hoặc giá mỗi token không thể chốt được đánh giá này.
Bài tập 3-10 [Mở rộng]: Thời gian hoàn thành training và chi phí serving tích lũy
Giả sử hoàn thành training cần tổng 1.022.362 A100 GPU-giờ, con số sử dụng công khai của Llama 1 65B. Dùng lần lượt 2048 và 1024 A100 liên tục, giả định tổng GPU-giờ không đổi khi số accelerator thay đổi, hãy tìm số ngày cần để hoàn thành training trong mỗi cấu hình. Sau đó so sánh hai model cùng thỏa mãn cùng yêu cầu chất lượng và hạn chót: model nhỏ hơn cần thêm 100.000 H100 GPU-giờ training và tiết kiệm 0,72 H100 GPU-giây cho mỗi nhiệm vụ thành công. Khi dự kiến hoàn thành lần lượt hai trăm triệu và một tỉ nhiệm vụ thành công, mỗi trường hợp nên chọn model nào? Hãy tính chênh lệch chi phí tổng và giải thích lựa chọn sẽ đảo ngược ở đâu nếu khối lượng nhiệm vụ thực tế thay đổi.
Các chương sau sẽ dùng ba loại thông tin khối lượng công việc được tổ chức trong chương này. Bảng dưới đây liệt kê những gì phải được ghi lại cho mỗi loại khối lượng công việc và các câu hỏi thiết kế hệ thống mà thông tin này sẽ phục vụ sau này.
| Khối lượng công việc | Các trường phải giữ lại | Dùng về sau |
|---|---|---|
| Chat/Agent | Kiểm tra nhiệm vụ, model và phiên bản, đầu vào/trúng/đầu ra mỗi vòng, thời điểm đến, phụ thuộc công cụ, phân nhánh và khoảng tái sử dụng | Chương 8 sắp xếp batching và trạng thái; Chương 9 chuyển giao và định tuyến; Chương 11 quản lý môi trường công cụ |
| Vision/Thời gian thực | Byte ảnh gốc, , EC/KV, thời điểm đến của khung hoặc đoạn, yêu cầu phản hồi đầu tiên/phát liên tục, tính toán không còn cần sau khi bị ngắt | Chương 8–9 sắp xếp mã hóa và chuyển giao; Chương 12 tính đến liên kết và vị trí thực thi |
| Training/RL | Dữ liệu và chất lượng, độ dài và nhãn, micro-batch/cập nhật, số mẫu sinh/giữ lại, tính toán phần thưởng và lời gọi model, phiên bản trọng số, hạn chót | Chương 4–7 phân tích yêu cầu tính toán, lưu trữ và truyền thông; Chương 10 sắp xếp học; Chương 11 cấu hình môi trường và nhóm tài nguyên |
Cả ba ví dụ cho thấy mô tả một khối lượng công việc đòi hỏi phải ghi lại quá trình thực thi cụ thể. Trong ví dụ yêu cầu hai phút, tỉ lệ đầu vào so với đầu ra tại mỗi khoảng thời gian quyết định khi nào tồn đọng xuất hiện; trong agent mã, phụ thuộc công cụ quyết định thời gian chờ và trạng thái phải được giữ bao lâu; trong RL, số mẫu trước và sau khi lọc quyết định giai đoạn sinh và giai đoạn cập nhật mỗi giai đoạn xử lý bao nhiêu dữ liệu. Chỉ bằng cách nắm bắt thông tin này, tài nguyên mới có thể được sắp xếp cho từng giai đoạn.
Chương 4 sẽ kết hợp sức tính toán, dung lượng lưu trữ và băng thông của một con chip để phân tích cách các khối lượng công việc này thực thi trên accelerator. Các kích thước ma trận, kích thước trạng thái và số lần truy cập được tính trong chương này sẽ được dùng để phán đoán tính toán mất bao lâu, dữ liệu có vừa hay không và các thao tác đọc/ghi có thể hoàn thành kịp thời hay không. Các quan hệ phụ thuộc giữa các giai đoạn sau đó quyết định công việc nào có thể chồng lấn và công việc nào phải chờ.
Ngộ nhận và cạm bẫy
Ngộ nhận: nếu tốc độ yêu cầu và độ dài trung bình giống nhau thì khối lượng công việc giống nhau. Một số ít yêu cầu cực dài, tổ hợp của độ dài đầu vào và đầu ra, cùng thứ tự đến của các yêu cầu đều ảnh hưởng đến nhu cầu tài nguyên trong một cửa sổ thời gian ngắn. Trong Ví dụ 3-1, dung lượng đủ cho khối lượng đến trung bình, vậy mà tồn đọng vẫn tích tụ trong phút sau đó.
Ngộ nhận: nếu giá mỗi token giảm thì chi phí mỗi nhiệm vụ thành công cũng giảm. Suy nghĩ thêm, các câu trả lời không qua kiểm tra và chi phí công cụ và môi trường đều nên nằm ở tử số, với số nhiệm vụ đạt tiêu chí ở mẫu số. Một batch không có lần thành công nào chỉ có thể báo cáo mức tiêu thụ và các lần thất bại — không thể ước tính chi phí mỗi lần thành công.
Ngộ nhận: nếu tổng số token training giống nhau thì khối lượng công việc hệ thống giống nhau. Phân bố chuỗi thay đổi số cặp truy vấn-khóa của attention, chiến lược nhãn và vocabulary-head thay đổi công việc đầu ra, số lần cập nhật thay đổi chi phí optimizer; RL thêm vào chi phí sinh và phản hồi cho các phản hồi không được chấp nhận.
Ngộ nhận: quy mô tối ưu theo tính toán suy ra từ việc khớp Scaling Law là quy mô nên được áp dụng cho training. Tính tối ưu theo tính toán chỉ đúng dưới một ngân sách training cố định loại trừ chi phí inference. Số token training trên mỗi tham số của các model công khai vượt chuẩn này từ một đến hai bậc độ lớn, một lựa chọn được thực hiện khi chi phí serving lâu dài được gộp vào mục tiêu; một hàm mục tiêu khác không có nghĩa kết quả khớp đã bị lật đổ.
Dấu vết nhiệm vụ Code
Nhiệm vụ là sửa một hàm gộp khoảng (interval-merging) sao cho các khoảng lồng nhau và các khoảng có đầu mút chạm nhau được gộp đúng, mà không sửa đổi đầu vào hay các danh sách lồng của nó. Model có thể đọc tệp được chỉ định, viết lại nó, chạy một kiểm thử cố định và kết thúc nhiệm vụ; bộ điều khiển không sửa mã thay cho model. Với chế độ suy nghĩ tắt, model đọc tệp một lần, viết lại năm lần và chạy kiểm thử sáu lần trong 12 vòng, vẫn không hoàn thành nhiệm vụ; với chế độ suy nghĩ bật, bốn vòng gồm cắt bớt đầu ra, ghi tệp, chạy kiểm thử và kết thúc nhiệm vụ. Thời gian chờ do việc cắt bớt ở vòng đầu tạo ra cũng được tính vào tổng thời gian nhiệm vụ.
Chú thích nguồn
- Model: Chương 2, Kiến trúc Model, các quy ước gọi yêu cầu trong §2.2 và cách đếm KV của Qwen3-8B; tính toán yêu cầu cho bốn model.
- Chi phí: Khảo sát giá token 2023–2026, §2, §4, §11; giá API, chi phí sản xuất và chi phí mỗi nhiệm vụ thành công được tách riêng.
- ServeGen: ServeGen, NSDI 2026, §2–7; ghi chú về tài liệu nguồn và đọc mã.
- Khối lượng công việc: Phân bố yêu cầu và cấp phát, các yêu cầu giai đoạn sau khi hiệu chỉnh cho đầu vào cố định hai phút và các hiệu ứng token đầu tiên; cận dưới băng thông decode cho 64 chuỗi trên RTX PRO 6000, với ngữ cảnh trung bình 2742 token.
- Thời điểm đến: Bài tập 3-2: phát lại hai phút thực tế, đầu vào đầy đủ, nhật ký gửi và hoàn thành, lấy mẫu KV và phạm vi chạy.
- ServeGen phát lại: Phát lại thực tế cửa sổ ServeGen.
- Tính lại agent: Tính lại dấu vết thực tế với chế độ suy nghĩ bật.
- Ngữ cảnh: Tổ chức ngữ cảnh và tình huống Agent, liên kết Chương 2 của sách AI Agent của tác giả với các bản ghi thực nghiệm.
- Suy nghĩ: Bài tập 3-3: ngân sách 1024 và ngân sách 4096; nền tảng lý thuyết trong Test-Time Compute.
- Suy nghĩ tắt: Chẩn đoán với chế độ suy nghĩ tắt, ghi lại kết quả chấm theo các tiêu chí định trước, kết quả thu được bằng cách trích câu trả lời từ đầu ra sau đó và dữ liệu quan sát từ các tiến trình đồng thời.
- Agent: Bài tập 3-4: hai dấu vết agent mã, bao gồm các kiểm tra độc lập và một điều kiện bí danh bổ sung.
- Truy hồi: Ví dụ truy hồi và sinh.
- Tăng tốc agent: Chỉ tăng tốc đoạn model vòng đầu 2x.
- TypeSafe JEV: Trang chủ TypeSafe AI, giá và bản demo song song; bài đăng ra mắt gồm tường thuật của chính người sáng lập và mô tả lấy mẫu song song, RLCD và phương pháp đánh giá; tài liệu API nêu rõ các câu hỏi được đánh giá song song trên cùng một trạng thái.
- RLCR: Beyond Binary Rewards: Training LMs to Reason About Their Uncertainty, phần thưởng RLCR trong §3.
- Tính toán quyết định: Các đường thực thi và so sánh giá cho yêu cầu quyết định, bao gồm đường full-layer V4.1 Flash, đường LLM với 512 token đầu ra và bảng giá DeepSeek; tái tạo bằng
python3 calculations/calc.py decision-request --format md; con số 2 đô la mỗi GPU-giờ từ tổng quan hệ thống inference DeepSeek; các model và giá DeepSeek. - Vision: Các ma trận mã hóa vision và số tensor.
- EPD: Byte, trạng thái và vị trí giai đoạn cho đầu vào đa phương thức, với cấu hình Qwen3-VL-4B cố định, tiền xử lý và toàn bộ EC DeepStack.
- Media: Nguồn mô hình sinh và các đường thực thi; Omni audio, Fish audio, ảnh FLUX, video H3, video Wan.
- Ảnh: Số lượng yêu cầu sinh ảnh Qwen.
- AOI: Bài báo AOI và tình huống keyframe.
- Lịch sử audio: Hai nhật ký giọng nói lịch sử.
- Audio: Dòng thời gian giảng dạy với buffer 40 ms và buffer 60 ms.
- Ngắt audio: Ví dụ giảng dạy với ngắt và im lặng.
- Tính toán training: Ghi chú về tính toán training, forward và backward của lớp tuyến tính, phân bố chuỗi và tính toán mỗi expert của DeepSeek V4-Flash.
- Ma trận training: Ma trận training Qwen3-8B 8K.
- Qwen: Báo cáo kỹ thuật Qwen3, pretraining ba giai đoạn trong §3.2 và các nhánh post-training trong Bảng 21.
- Nhãn giảm nửa: Nhãn giảm nửa và vocabulary head nén tường minh.
- Ngoài ma trận: Tính toán phi-ma trận bổ sung của training, đo riêng so với biến thể 8K.
- Training V4: Bộ nén trực tuyến DeepSeek V4-Flash, backward của attention, training MoE một lớp, backward của wrapper mHC, nhóm optimizer.
- DeepSeek-R1: Báo cáo DeepSeek-R1.
- DeepSeek V4: Báo cáo DeepSeek V4, expert miền và OPD đa teacher trong §5.1, lập lịch teacher, rollout và sandboxing trong §5.2.
- verl: Thí nghiệm 10-8: đường ống training verl tối thiểu cố định. Chương này dùng thí nghiệm này để phân biệt chất lượng nhiệm vụ với cập nhật tham số; tổ chức của hệ thống hoàn chỉnh được trình bày trong Chương 10.
- Loss verl: Quá trình chuẩn hóa loss và cập nhật tham số cho cấu hình training verl cố định, gắn với cấu hình gốc, mã nguồn và các tensor được xuất ra.
- RL: Batch RL giảng dạy Qwen.
- RL tỉ lệ thấp: Hạ tỉ lệ giữ mẫu trong khi giữ nguyên số mẫu được giữ lại.
- Scaling Laws: Kaplan Scaling Laws, §6; Chinchilla, phân bổ tối ưu theo tính toán và phương pháp khớp.
- Khớp C4: Khớp tám điểm C4 công khai, với nhật ký nguồn, các loại trừ và bốn mục nhạy cảm được giữ cùng báo cáo.
- Llama 3: Báo cáo Llama 3, ngân sách training, dự đoán loss và hiệu quả nhiệm vụ hạ nguồn; §3.3.2 và Bảng 4 đưa ra MFU BF16 38%–43% trên H100.
- Model card Llama 3: Model card Meta Llama 3, các cột Llama 3 8B và Llama2 70B trong bảng Base pretrained models.
- Training cục bộ: Bài tập 3-8: sáu lần chạy training model nhỏ trên văn bản cố định, giữ các checkpoint và kết quả hoàn chỉnh cho hai seed.
- Beyond Chinchilla-Optimal: Beyond Chinchilla-Optimal, bản camera-ready ICML 2024, nhu cầu inference, phạm vi thí nghiệm và ngoại suy training dài.
- Vòng đời: Chi phí vòng đời ước tính từ kết quả khớp C4, chi phí tính bằng H100 SXM GPU-giây.
- Lịch sử: Ghi chú về khoản đầu tư training và lịch sử Scaling Law và tính lại với các trường đã công bố được khóa.
- Tài liệu đa phương thức: Tài liệu tính toán đa phương thức.
- Tình huống V4.1: Báo cáo kỹ thuật chính thức DeepSeek V4.1, Phần 1, 2, 3 và 6; điều kiện cố định và tính lại qua các phiên chương.
Tóm tắt chương
Khối lượng công việc của một dịch vụ chạy liên tục phụ thuộc cả vào lượng công việc mỗi yêu cầu đòi hỏi lẫn thời điểm các yêu cầu đến và các phụ thuộc giữa các bước. Tốc độ trung bình cho ước tính thô về tài nguyên cần thiết; phân tích tồn đọng ngắn hạn và thời gian lưu trú của trạng thái hé lộ áp lực tài nguyên mà giá trị trung bình không nắm bắt được. Nhiệm vụ nhiều vòng thêm vào việc chờ công cụ và các lần thử thất bại, nhiệm vụ thời gian thực phải đảm bảo dữ liệu đến đúng hạn, còn training thêm backward pass, cập nhật tham số và đồng bộ trọng số.
Khi so sánh tài nguyên và chi phí của các phương án khác nhau, nên áp dụng cùng yêu cầu chất lượng và tiêu chí hoàn thành nhiệm vụ. Scaling Laws cung cấp một mô hình thống kê có thể kiểm chứng cho việc phân bổ training, trong khi nhu cầu serving lâu dài có thể thay đổi các lựa chọn cho khoản đầu tư ban đầu. Các Bài tập Cốt lõi 3-2, 3-4 và 3-7 lần lượt áp dụng các phương pháp này cho yêu cầu liên tục, nhiệm vụ tương tác và vòng lặp RL.